RESEARCH / Instorm
TECH SESSION 1편 | AI는 왜 똑같이 물어봐도 매번 다른 답을 할까?
같은 질문에 다른 답이 나오는 이유를 샘플링·Temperature·Top-p·GPU 비결정성 원리와 Thinking Machines Lab의 실험으로 설명합니다.
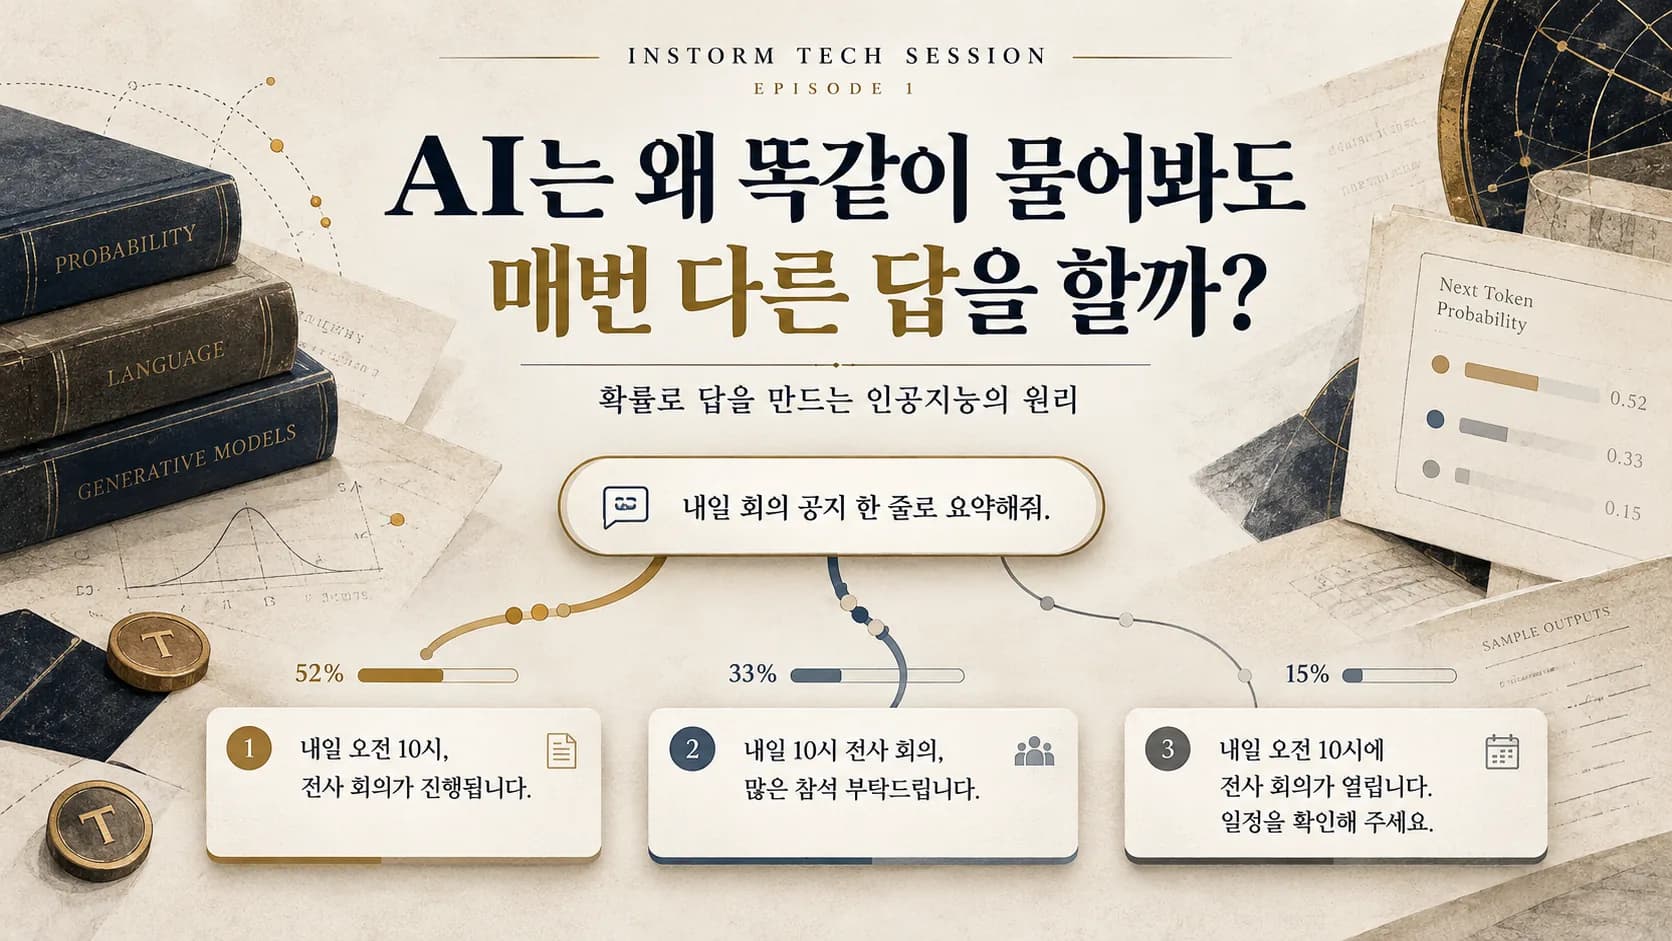
같은 질문에서 갈라진 세 문장. 그 뒤에는 확률, 추첨, 그리고 GPU의 숫자 계산이 있습니다.
같은 질문에 세 가지 답이 나왔습니다
내일 회의 공지문을 작성하는 직원이 있습니다.
“내일 오후 3시 기획회의 참석 안내문을 짧게 써 줘.”
첫 번째 답은 “내일 오후 3시, 기획회의를 진행합니다. 참석 부탁드립니다.”였습니다. 다시 입력하니 “기획회의는 내일 오후 3시에 열립니다. 관계자 여러분의 참석을 바랍니다.”라고 합니다. 세 번째는 또 달랐습니다. “내일 15시에 기획회의가 예정되어 있습니다. 참석해 주세요.”
모두 같은 사실을 담았지만 문장은 달랐습니다. 위 문장들은 실제 서비스를 세 번 시험한 기록이 아니라 현상을 보여주기 위한 가상 사례입니다.
계산기에 2+2를 세 번 입력하면 세 번 모두 4가 나옵니다. 그런데 왜 언어모델은 이렇게 대답할까요? 기계가 그때그때 기분을 바꾸는 것은 아닙니다. 더 근본적인 이유가 있습니다.
언어모델은 완성된 답을 저장소에서 꺼내기보다, 지금까지 주어진 문맥을 바탕으로 다음 토큰이 나올 확률을 계산하며 답을 이어갑니다. 그러니까 같은 질문을 받더라도, 그 확률에서 어떤 후보를 선택하느냐가 달라지면 뒤의 문장도 달라질 수 있습니다.
이 과정을 이해하려면 아직 AI를 논할 필요도 없습니다. 작은 확률표 하나면 충분합니다.
가장 그럴듯한 단어가 반드시 선택되는 것은 아닙니다
“오늘 날씨가 정말 …”이라는 문장 뒤에 ‘좋다’, ‘춥다’, ‘덥다’ 중 하나를 넣는다고 해봅시다. 실제 모델은 단어가 아니라 토큰(Token)을 다루지만, 여기서는 설명을 위해 각각이 하나의 후보 토큰이라고 가정하겠습니다.
모델이 계산한 원시 점수인 Logit(로짓)이 차례로 2, 1, 0이라고 합시다. 로짓은 확률이 아닙니다. 순위가 있는 점수에 가깝습니다. 이를 Softmax(소프트맥스)로 변환하면 각 후보의 확률이 됩니다.
| 후보 | 로짓 | Temperature 1일 때 확률 |
|---|---|---|
| 좋다 | 2 | 66.52% |
| 춥다 | 1 | 24.47% |
| 덥다 | 0 | 9.00% |
직접 계산한 세 후보짜리 교육용 예시. 실제 모델의 출력 분포가 아닙니다. 반올림 때문에 합계가 99.99%로 보일 수 있습니다.
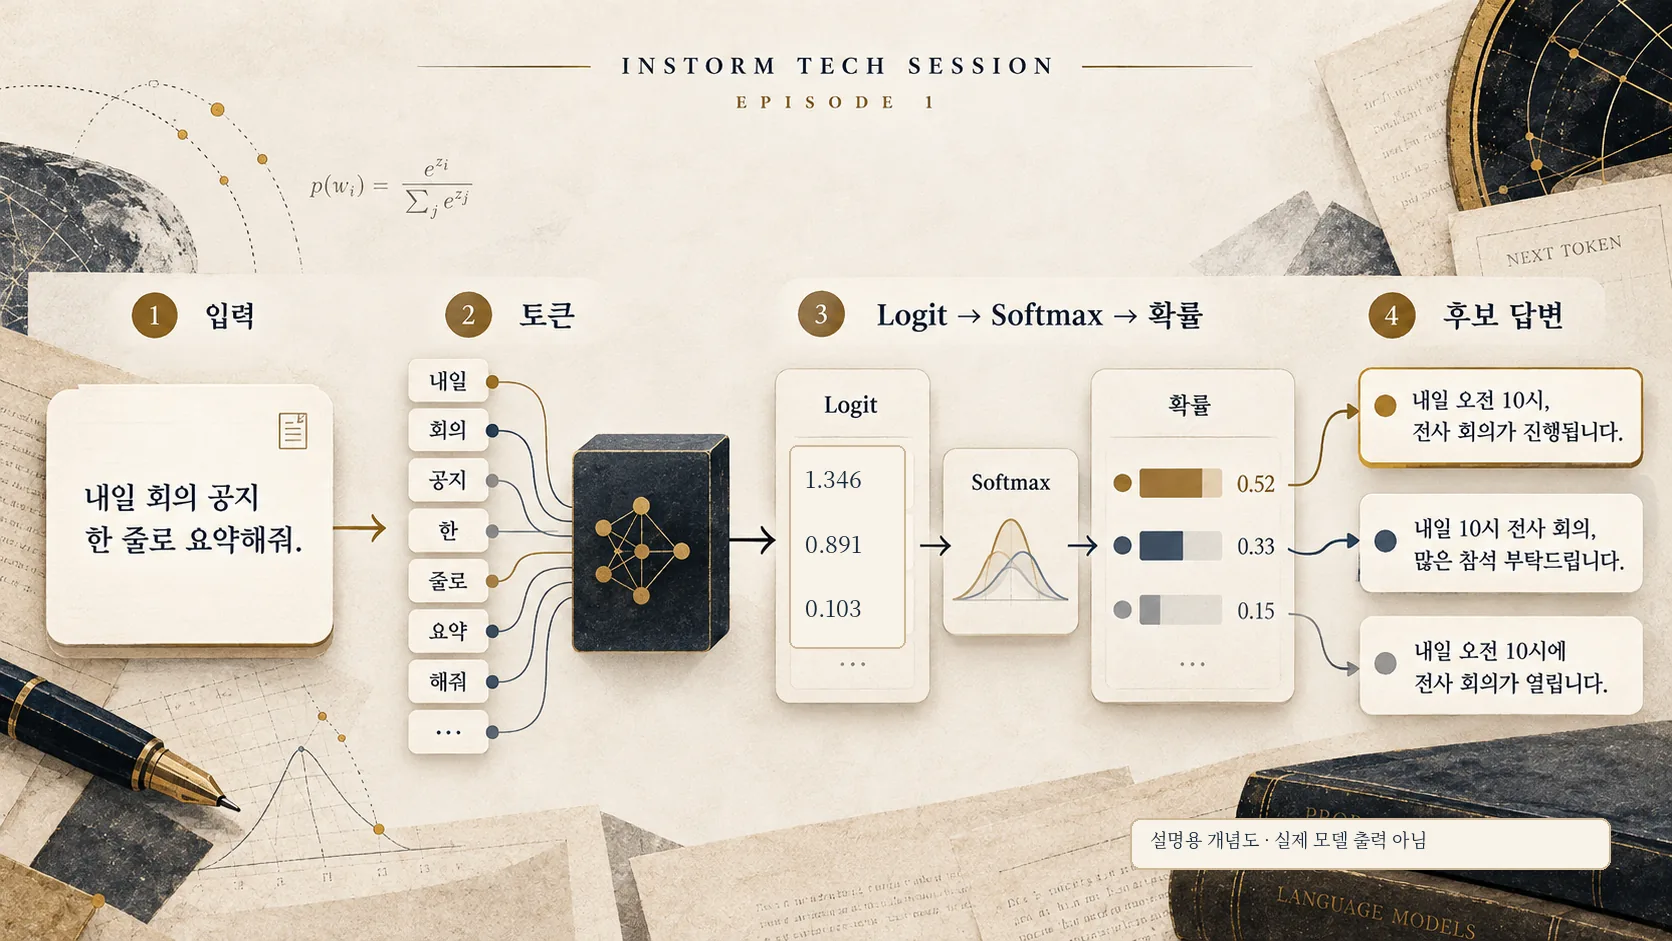
여기서 가장 가능성이 큰 ‘좋다’를 무조건 선택하면 Greedy Decoding(탐욕적 디코딩)입니다. 하지만 확률표에 따라 후보를 뽑으면 Sampling(샘플링)이 됩니다. 66.52%가 가장 크더라도 24.47%의 ‘춥다’가 선택될 기회가 남습니다.
이것이 첫 번째 원리입니다. 확률이 가장 높다는 것과 반드시 선택된다는 것은 다릅니다.
그런데 잠깐, 이 확률표를 만들어 놓고도 AI의 문장 스타일을 바꿀 수 있다면 어떨까요?
온도를 바꾸자 확률표가 달라졌습니다
그 손잡이가 Temperature(온도)입니다. 서버의 열을 조절하는 기능이 아닙니다. 로짓을 온도로 나눠 확률 분포의 뾰족한 정도를 바꾸는 설정입니다. 같은 점수 2·1·0을 가지고 직접 계산해보겠습니다.
| 후보 | 온도 0.5 | 온도 1.0 | 온도 2.0 |
|---|---|---|---|
| 좋다 | 86.68% | 66.52% | 50.65% |
| 춥다 | 11.73% | 24.47% | 30.72% |
| 덥다 | 1.59% | 9.00% | 18.63% |
같은 가상 로짓을 Softmax(logit / T)에 넣은 계산값. 실제 모델의 창의성이나 정답률 측정이 아닙니다.
온도 0.5에서는 가장 높은 후보로 확률이 몰립니다. 온도 2.0에서는 낮은 후보의 선택 가능성도 커졌습니다. 하지만 후보 간 원래 순서 자체가 뒤집힌 것은 아닙니다.
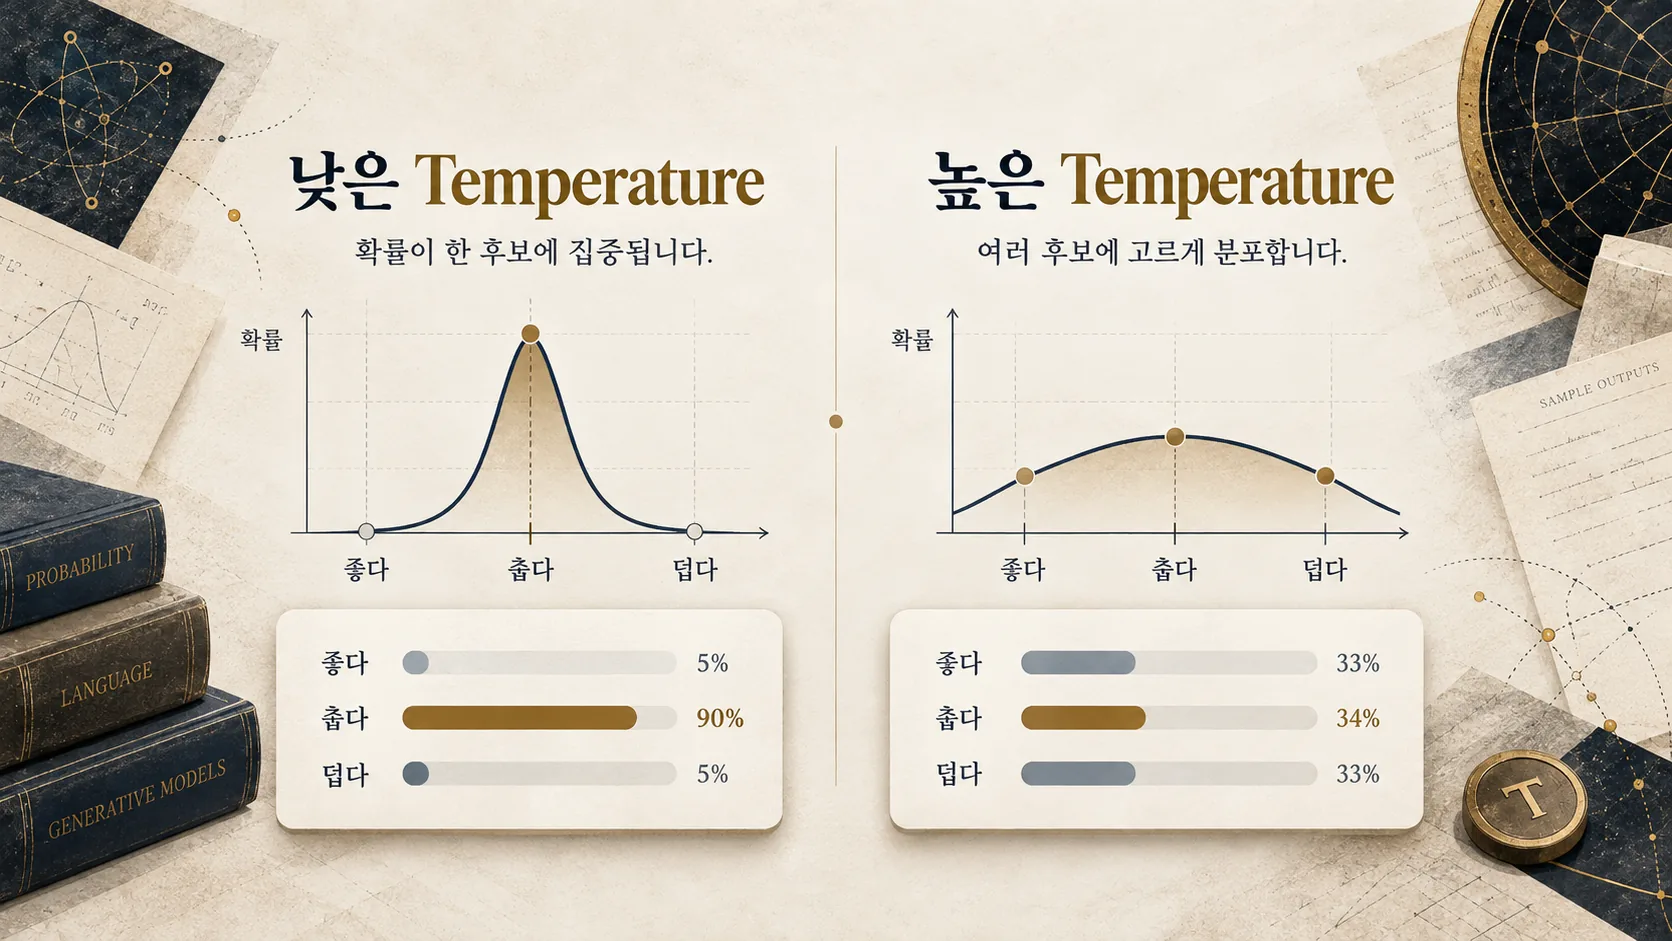
따라서 Temperature를 높인다는 것은 “더 똑똑하게 만든다”는 뜻이 아닙니다. 똑같은 모델이 가진 후보 중 어떤 표현을 얼마나 다양하게 뽑을 것인지를 조절하는 것입니다. 온도가 높다고 반드시 좋은 광고 문구가 나오지도, 낮다고 반드시 사실을 맞히지도 않습니다.
그리고 Temperature=0은 실무에서 보통 무작위 샘플링을 하지 않고 최고 점수 토큰을 고르는 특별한 경로로 취급됩니다. 수식에 그대로 0을 대입해 계산한다는 뜻은 아닙니다.
어느 후보까지 추첨에 넣을까요?
또 하나의 손잡이가 있습니다. Top-p, 또는 Nucleus Sampling(핵 샘플링)입니다.
방금 온도 1.0에서 나온 확률을 높은 순서대로 더해보겠습니다. ‘좋다’까지는 66.52%, ‘춥다’까지는 90.99%입니다. Top-p를 0.9로 설정하면 확률의 누적 합이 90% 이상이 되는 최소 후보 집합을 사용합니다.
따라서 이 예시에서는 ‘좋다’와 ‘춥다’ 두 후보가 남고 ‘덥다’는 이번 추첨에서 제외됩니다. 남은 두 후보의 확률은 다시 합계 100%가 되도록 정규화합니다. 계산하면 약 73.10% 대 26.90%입니다.
여기서 두 설정의 차이가 드러납니다. Temperature는 확률 분포를 바꾸고, Top-p는 선택 대상의 범위를 자릅니다. 어떤 시스템은 Top-k까지 함께 사용합니다. 다만 지원 옵션과 연산 적용 순서는 모델 제공자·서빙 구현에 따라 다릅니다.
사람에게는 ‘말투를 조금 바꾸는 설정’처럼 보이지만, 내부에서는 로짓 변환과 후보 집합 선택이라는 꽤 구체적인 계산이 벌어지고 있습니다.
첫 단어 하나가 뒤의 문장을 바꿉니다
답변은 처음에 하나를 뽑고 끝나는 추첨이 아닙니다.
AI가 “내일 회의는”을 선택했다면 그 문장을 이어 쓸 때의 문맥은 이제 “내일 회의는”입니다. 다른 실행에서 “기획회의 안내드립니다”를 선택했다면 다음 토큰을 계산하는 입력부터 달라집니다.
자기회귀 생성(Autoregressive Generation)은 이렇게 방금 선택한 토큰을 다음 계산의 조건으로 다시 사용하는 방식입니다. 작은 가지 하나에서 갈라진 두 길이, 뒤로 갈수록 서로 다른 문장 구조로 발전할 수 있는 이유입니다.
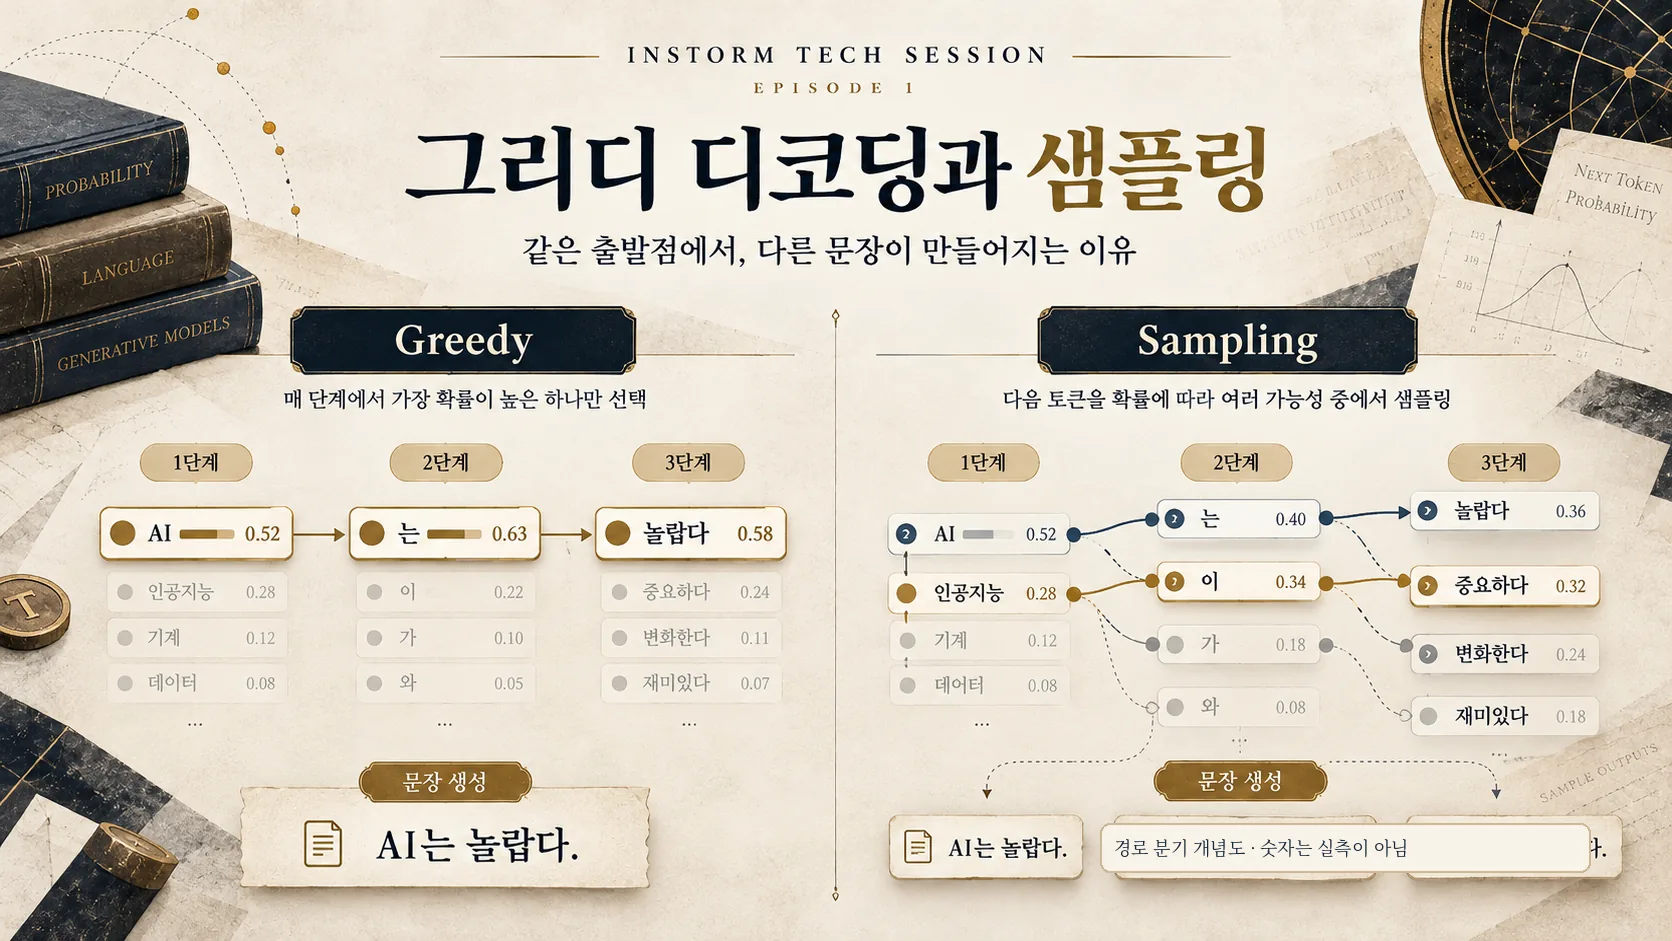
그렇다고 표현이 달라졌다는 사실만으로 정답이 틀렸다고 말할 수는 없습니다. “오후 세 시”와 “15시”는 표면 문자열은 다르지만 같은 시간을 뜻합니다. 반대로 완전히 같은 문장을 두 번 출력했더라도, 그 내용이 허위라면 두 번 모두 틀린 것입니다.
문자열 일치, 의미 일치, 사실 정확성은 각각 다른 평가 항목입니다.
2019년 연구자들은 '정답만 고르는 방식'을 의심했습니다
흥미로운 반전은 2019년 연구에서 등장합니다. Ari Holtzman과 동료들의 The Curious Case of Neural Text Degeneration은 언어모델이 가장 가능성이 큰 문장만 추구할 때 오히려 글이 무너질 수 있다고 지적했습니다.
논문 Figure 1에는 GPT-2 Large를 이용한 개방형 생성 사례가 실립니다. Beam Search(여러 후보 문장 경로를 비교해 고득점 경로를 선택하는 방법)에서 같은 기관 이름을 거듭 반복하는 결과와, 제한 없는 샘플링에서 맥락을 잃은 결과를 대비합니다. 연구자들이 제안한 방식은 분포의 낮은 확률 꼬리를 제외하고 핵심 후보 안에서 샘플링하는 Top-p였습니다.
이 논문의 실험은 특정 GPT-2 모델과 개방형 텍스트 생성 평가에 관한 것입니다. 오늘날 모든 모델에서 Top-p가 언제나 가장 좋다는 증명은 아닙니다. 그래도 결론은 지금도 중요합니다. '학습을 잘한 모델'과 '그 모델에서 좋은 문장을 꺼내는 생성 알고리즘'은 별개의 문제라는 것입니다.
그런데 여기까지 설명하고 나면 아직 설명되지 않는 현상이 하나 남습니다. 추첨을 없애고 최고 확률 후보만 선택했는데도, 실제 서비스에서 답이 달라지는 경우입니다.
온도를 0으로 낮췄는데도 다른 이유
2025년 9월 Thinking Machines Lab에서 발표한 Horace He와 동료들의 글, Defeating Nondeterminism in LLM Inference는 이 현상을 아주 깊게 파고듭니다.
핵심은 Batching(배칭)과 Floating-point(부동소수점) 연산입니다. GPU 서버는 사용자 한 명의 요청만 처리하지 않습니다. 여러 요청을 하나로 묶어 행렬 계산을 수행합니다. 같은 요청이 어떤 때는 혼자, 어떤 때는 다른 요청 수십 개와 함께 처리될 수 있습니다.
수학에서는 0.1과 매우 큰 수를 어떤 순서로 더해도 결과가 같을 것처럼 느껴집니다. 하지만 유한한 자릿수를 사용하는 부동소수점 계산에서는 반올림 때문에 연산 순서에 따라 결과가 미세하게 달라질 수 있습니다. (a+b)+c와 a+(b+c)가 항상 일치하지 않는 현상을 비결합성(Non-associativity)이라고 합니다.
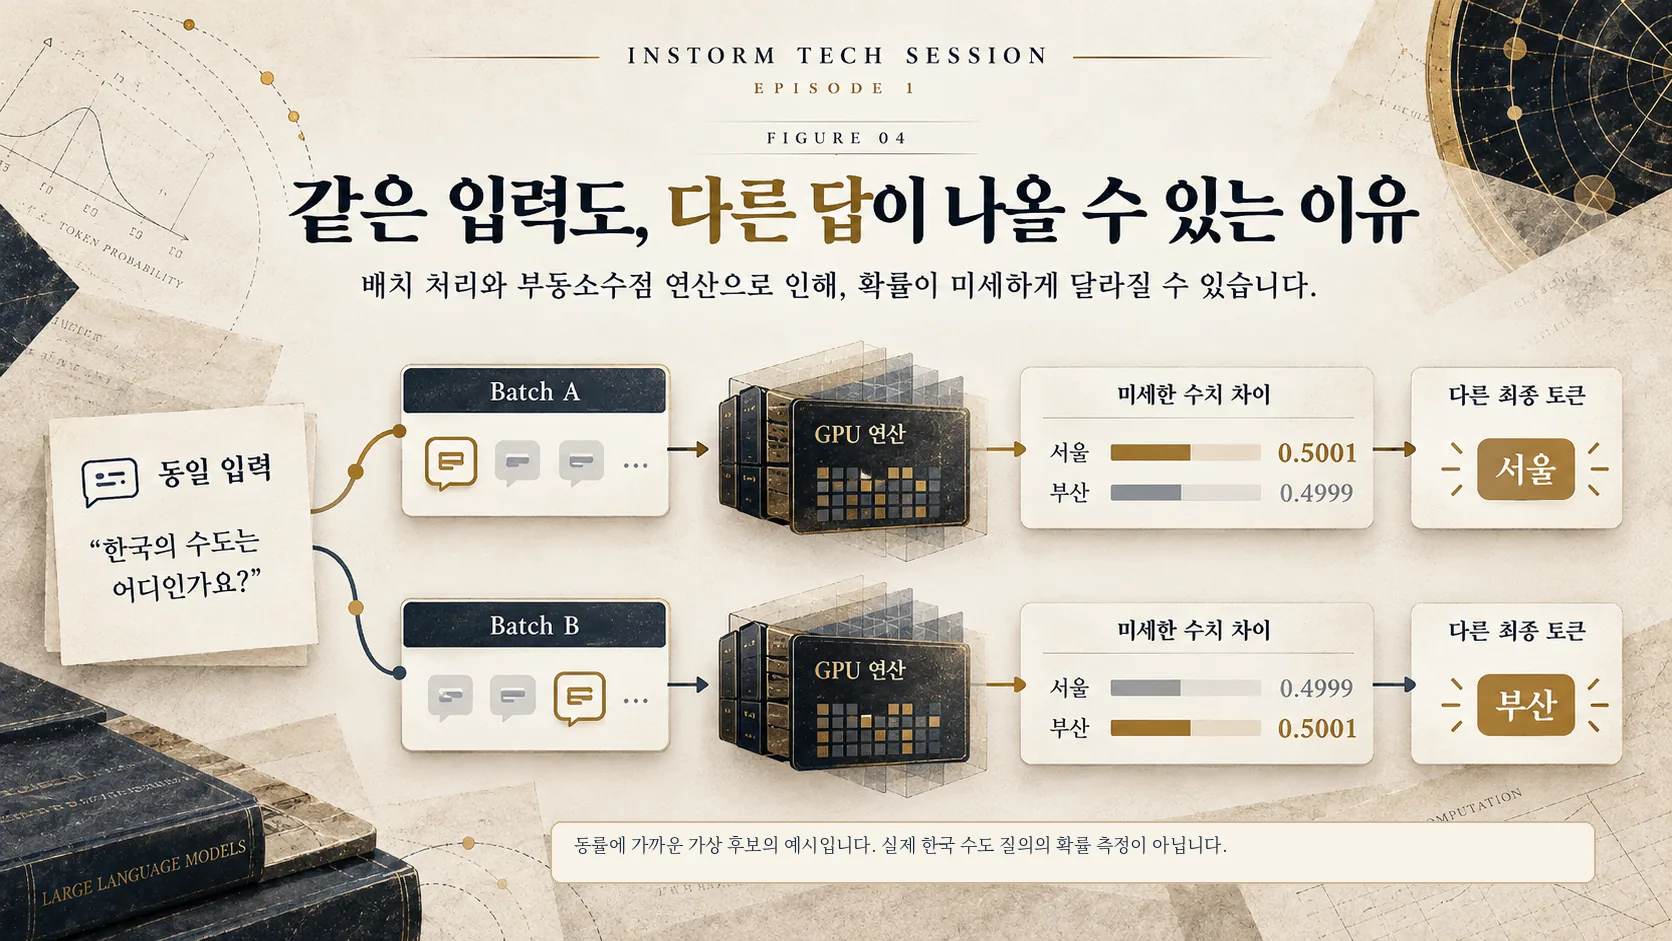
연구진이 강조한 것은 단순한 “GPU가 동시에 계산해서 무작위로 틀린다”는 설명이 아닙니다. 같은 개별 입력이라도 배치 크기에 따라 커널(Kernel)이 다른 계산 경로를 선택하면 출력 숫자가 달라질 수 있다는 문제였습니다. 이를 막으려면 연산을 요청 묶음의 크기와 무관하게 유지하는 Batch Invariance(배치 불변성)가 필요합니다.
논문에 나온 수치는 더욱 인상적입니다. 연구진은 Qwen3-235B-A22B-Instruct-2507 모델에 “Tell me about Richard Feynman”이라는 동일한 프롬프트를 주고, 비추론 모드·Temperature 0에서 1,000토큰씩 1,000번 생성했습니다. 그 결과 서로 다른 완성 답변 80개가 나왔습니다. 처음 102개 토큰은 동일했지만 103번째 토큰부터 분기하는 사례가 있었습니다. 반면 연구진이 배치 불변 커널을 적용한 조건에서는 1,000개 결과가 전부 일치했습니다. 이것은 해당 모델·설정·실험 구현에서 보고한 측정 결과이지, 모든 서비스에서 80개가 나온다는 보편 법칙은 아닙니다.
이 연구는 RMSNorm, 행렬곱, Attention과 같은 연산에서 그 방법을 살폈고, 실제 추론 구현과 재현성의 관계를 보여줬습니다. 이는 그 논문에서 분석한 구현 계층에 관한 결과이지, 세상의 모든 출력 불일치를 배칭 하나로 설명한다는 뜻이 아닙니다. 모델 버전, 시스템 프롬프트, 도구 호출, 숨겨진 서버 설정도 별도 변수입니다.
즉, 같은 답변이 나오는지 확인하려면 “Temperature를 0으로 했는가”에서 질문을 끝내면 안 됩니다. 모델·문맥·디코딩·계산 환경까지 어느 부분이 같았는지가 중요합니다.
기업은 무엇을 고정하고 무엇을 검증해야 할까요?
마케팅 문구를 여러 개 만드는 작업이라면 표현의 다양성이 장점입니다. 반대로 계약서의 날짜를 추출하거나 회계 숫자를 처리한다면 멋진 문장보다 재현 가능한 결과가 중요합니다.
같은 결과를 비교하려면 모델 이름과 버전, 정확한 프롬프트, 대화 기록, Temperature·Top-p·Seed 제공 여부, 도구 사용과 실행 시점을 기록해야 합니다. 그래도 제공자가 서버 내부 구현을 공개하지 않는다면 비트 단위의 재현성을 보장할 수 없을 수 있습니다. 사실 추출 작업은 구조화된 출력과 규칙 기반 검증을 함께 적용하는 편이 안전합니다.
AI의 서로 다른 대답은 모두 고장도 아니고 모두 창의성도 아닙니다. 확률적인 토큰 선택은 다양성을 만들고, 실제 수치 계산과 운영 환경은 추가적인 차이를 만들 수 있습니다. 해결된 문제는 표현을 유연하게 생성하는 방법이고, 남은 문제는 원하는 수준의 재현성과 정확성을 얼마나 보장할 수 있느냐입니다.
그렇다면 AI가 고른다는 그 '토큰'은 대체 무엇일까요? 사람이 보는 글자와 같은 것일까요? 다음 편은 작고 빨간 딸기 하나에서 시작합니다.
참고 자료
- Holtzman et al. (2019 arXiv / ICLR 2020), The Curious Case of Neural Text Degeneration. https://arxiv.org/abs/1904.09751 — 개방형 생성, Beam Search의 반복 문제와 Nucleus Sampling. 특히 Figure 1.
- Horace He & Thinking Machines Lab (2025), Defeating Nondeterminism in LLM Inference. https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/ — 부동소수점 비결합성, 배치 불변성, RMSNorm·행렬곱·Attention 커널.
- Thinking Machines Lab (2025), Batch Invariant Ops (연구 코드). https://github.com/thinking-machines-lab/batch_invariant_ops — 구현 참고.
- Brown et al. (2020), Language Models are Few-Shot Learners. https://arxiv.org/abs/2005.14165 — 자기회귀 언어모델 배경.