
기술·연구
TECH SESSION 6편 | AI는 단어의 순서를 어떻게 기억할까?
Transformer는 단어 순서를 어떻게 알까? Positional Encoding과 RoPE 회전 원리, LongRoPE2·MrRoPE 및 긴 컨텍스트의 한계를 설명합니다.
Instorm · 11분 읽기
RESEARCH
AI 검색의 원리부터 직접 확인한 데이터까지. 질문하고, 만들고, 검증합니다.
24개의 이야기
Transformer는 단어 순서를 어떻게 알까? Positional Encoding과 RoPE 회전 원리, LongRoPE2·MrRoPE 및 긴 컨텍스트의 한계를 설명합니다.
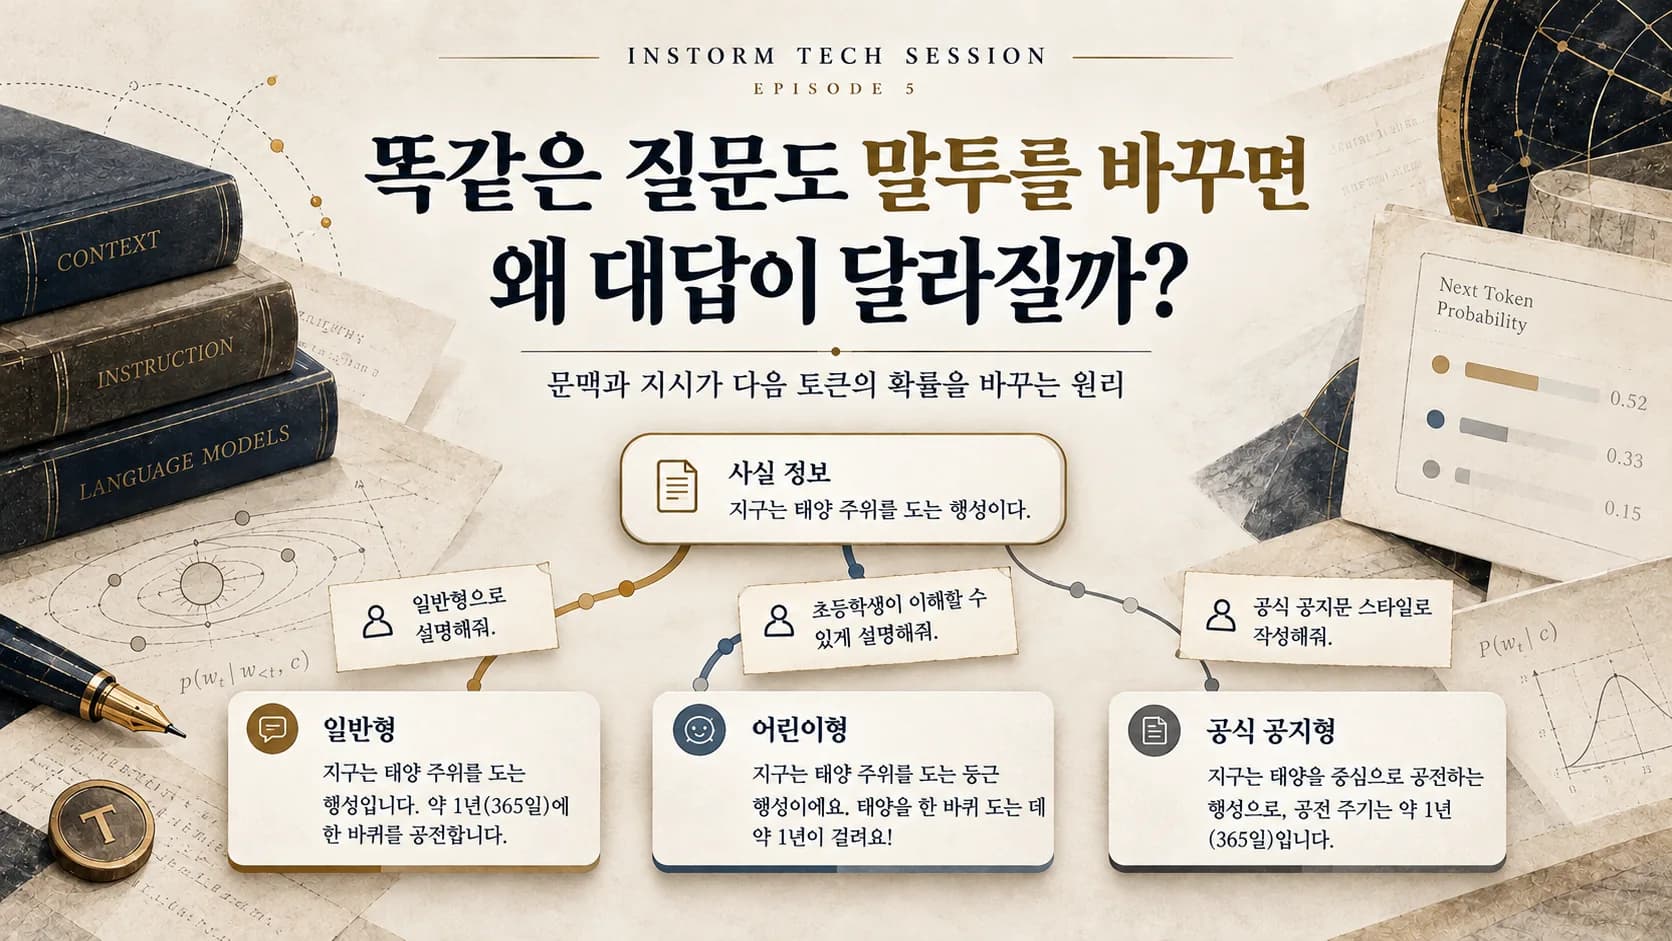
같은 질문도 말투를 바꾸면 답이 달라지는 이유. Context Conditioning, Few-shot, 프롬프트 민감도와 2026년 연구를 쉽게 풀어봅니다.
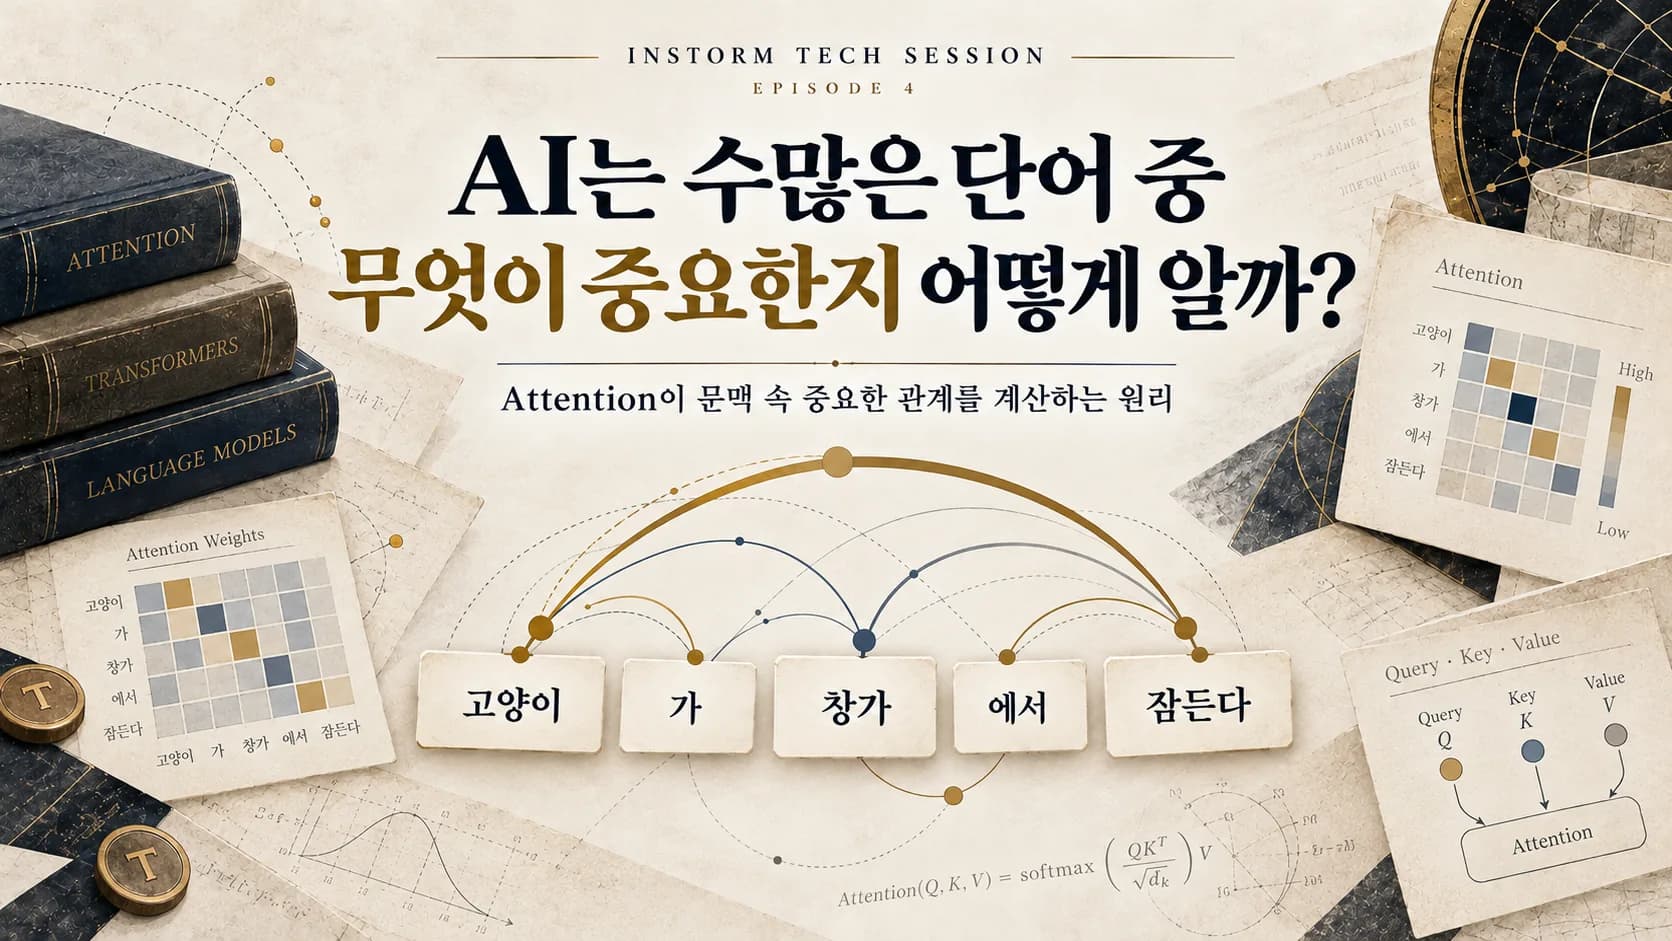
Transformer와 Self-Attention은 어떻게 Q·K·V를 계산할까? 2017년 원논문부터 2026년 Local Attention 연구까지 숫자 예시로 설명합니다.
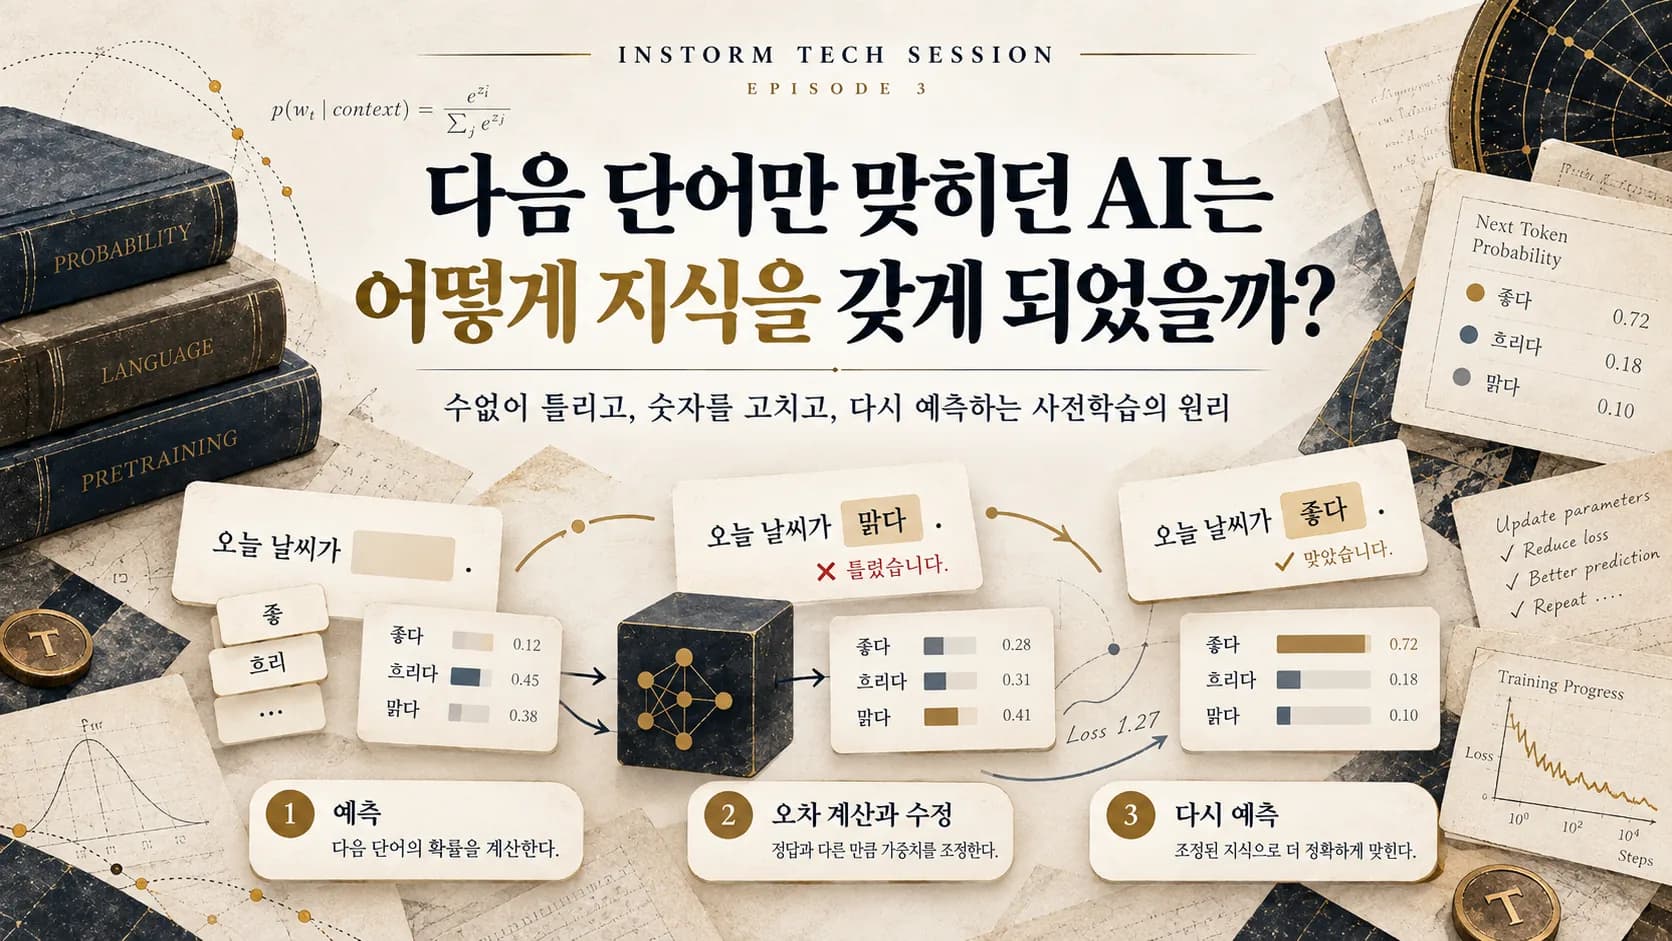
언어모델이 다음 토큰을 예측하며 지식을 형성하는 원리. 임베딩, Cross-Entropy, Backpropagation, Scaling Laws와 Chinchilla 논문까지 설명합니다.
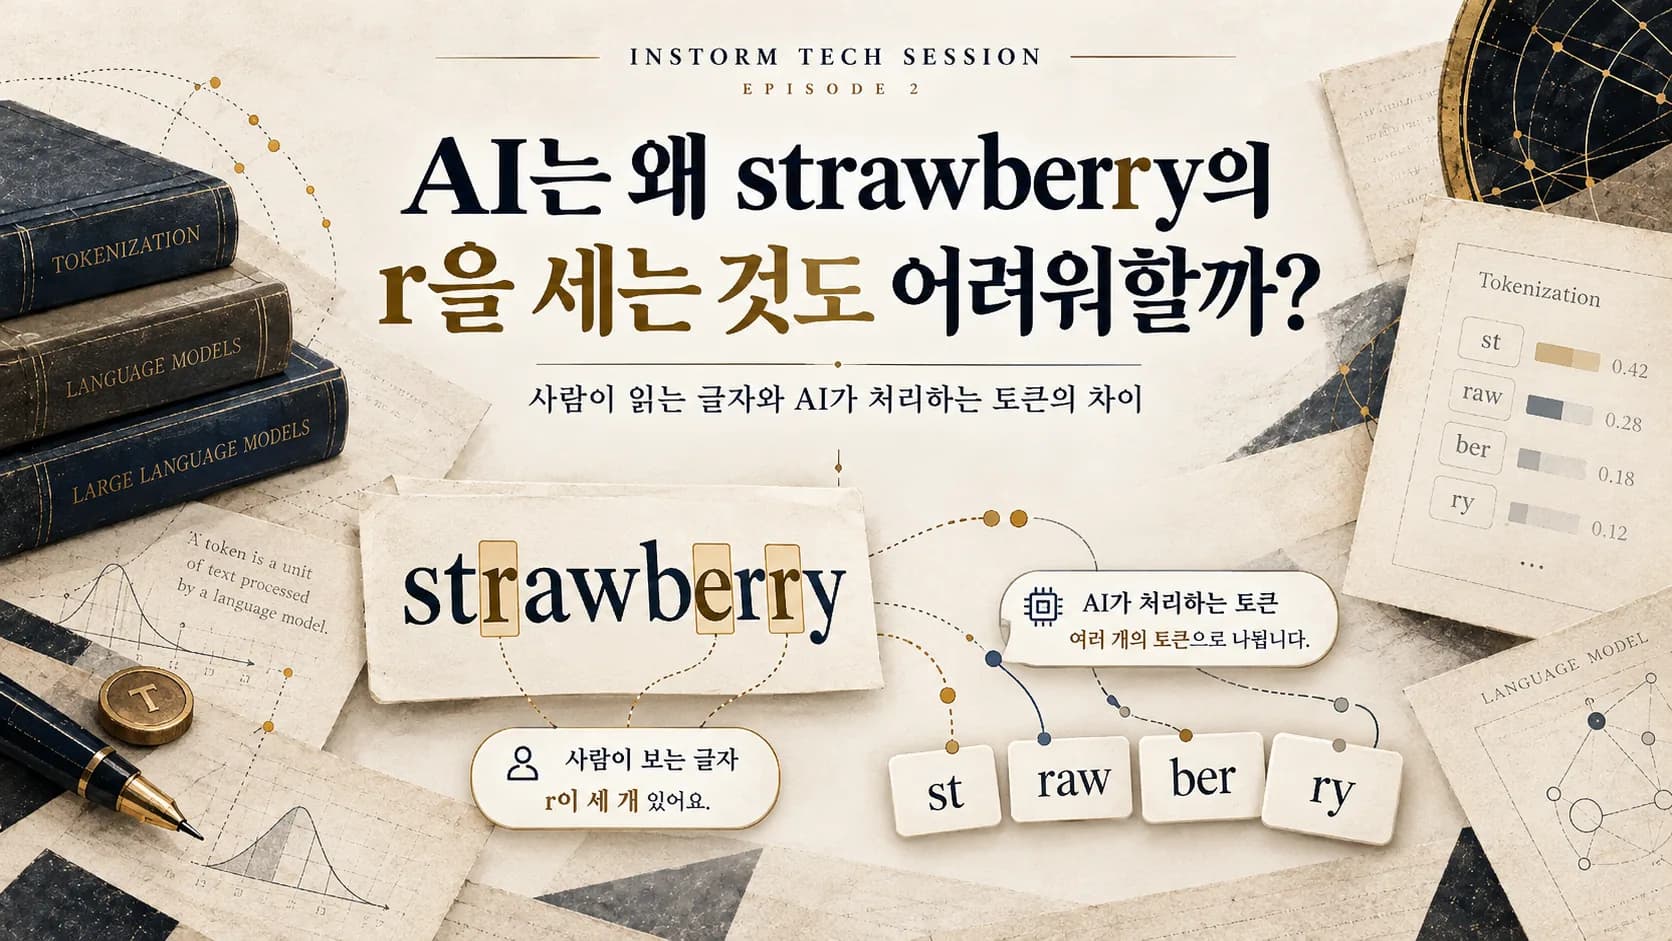
AI가 strawberry의 r을 세는 것이 왜 어려웠을까? 유니코드·BPE·SentencePiece 토큰화와 Byte Latent Transformer 연구를 연결합니다.
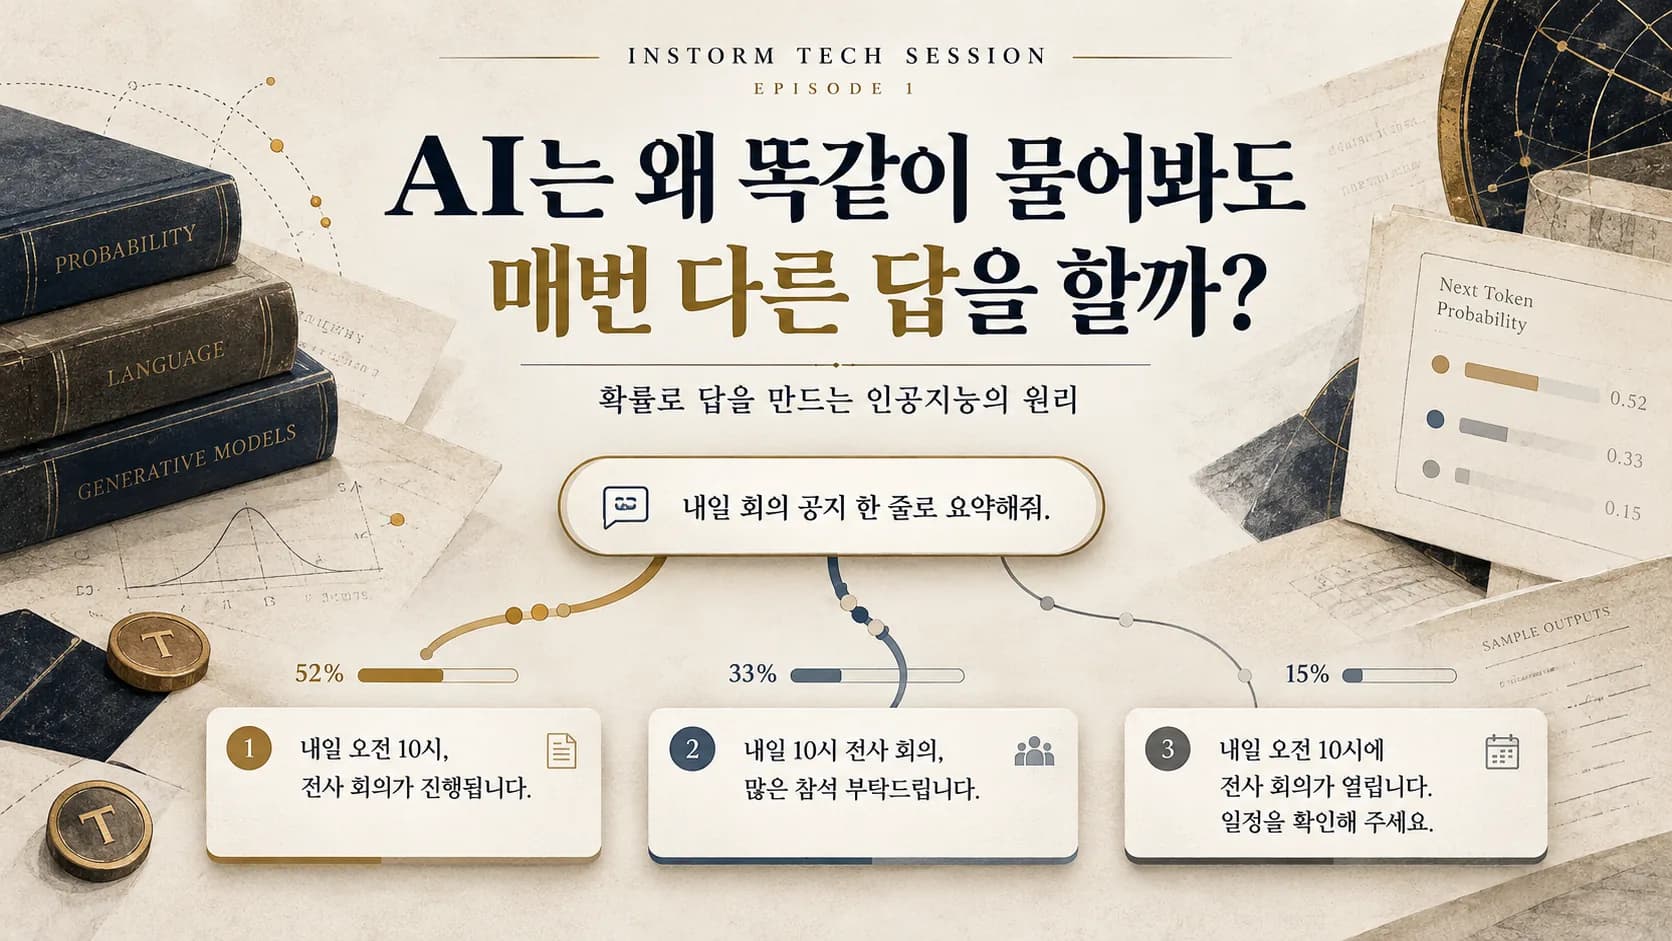
같은 질문에 다른 답이 나오는 이유를 샘플링·Temperature·Top-p·GPU 비결정성 원리와 Thinking Machines Lab의 실험으로 설명합니다.
AI 답변의 브랜드 언급, 공식 페이지 연결, 설명의 정확성과 실제 방문·문의를 구분해 이해하는 방법을 설명합니다.
고객의 질문에 답하고 확인 가능한 근거를 연결하는 편집법. 사례 표현과 발행 전 점검 항목을 제공합니다.
SEO·AEO·GEO를 작업 단위로 이해하고, 작은 팀이 접근 점검·회사 설명·고객 질문·측정 순서로 실행하는 방법을 제안합니다.
검색 순위, 브랜드 언급, 자사 URL 인용, 방문과 문의를 나누어 기록하고 수정 전후를 비교하는 방법을 설명합니다.
ChatGPT에서 회사가 안 보일 때 질문 조건, 검색용 크롤러, 회사 설명, 실제 출처를 순서대로 확인하는 진단 가이드입니다.
AI 초안을 발행하기 전에 확인할 사실과 공개 범위, 원고 검토와 발행 후 관리 기준을 정리합니다.
네이버 AI 브리핑과 일반 검색을 구분하고, 홈페이지·블로그·플레이스에서 확인할 정보와 기술 점검 순서를 설명합니다.
검색 서비스마다 브랜드가 소개되는 맥락은 달라질 수 있습니다. 공식 정보와 채널별 설명을 정리하고 고객의 발견 경로를 살펴보는 방법을 안내합니다.
AI 검색 최적화는 글을 여러 채널에 올리는 작업으로 끝나지 않습니다. 수집·색인·검색·답변 생성의 차이, 엔진별 크롤러 정책, 콘텐츠 배치 전략, 인용과 실제 유입을 구분하는 측정법까지 공식 기술 문서를 기준으로 정리했습니다.
AEO는 검색·AI 서비스가 질문에 답할 때 우리 콘텐츠를 이해하고 활용하기 쉽도록 정리하는 작업입니다. 글을 짧게 쓰거나 FAQ를 붙이는 것만으로 끝나지 않습니다. AI가 페이지를 읽고 답변을 만드는 과정, 인용에 실패하는 이유, 브랜드블룸의 AI 가독성 7원칙을 설명합니다.
GEO는 생성형 AI의 답변에서 우리 브랜드와 콘텐츠가 발견되고, 활용되고, 인용될 가능성을 높이는 작업입니다. SEO와 기본기를 공유하지만 측정해야 할 결과는 다릅니다. 논문과 구글 공식 문서, 그리고 브랜드블룸의 국내 실측으로 그 차이를 설명합니다.
블로그 검색 순위와 AI 답변에서의 브랜드 소개는 따로 살펴봐야 합니다. 고객에게 필요한 정보와 채널 운영의 기본을 정리합니다.
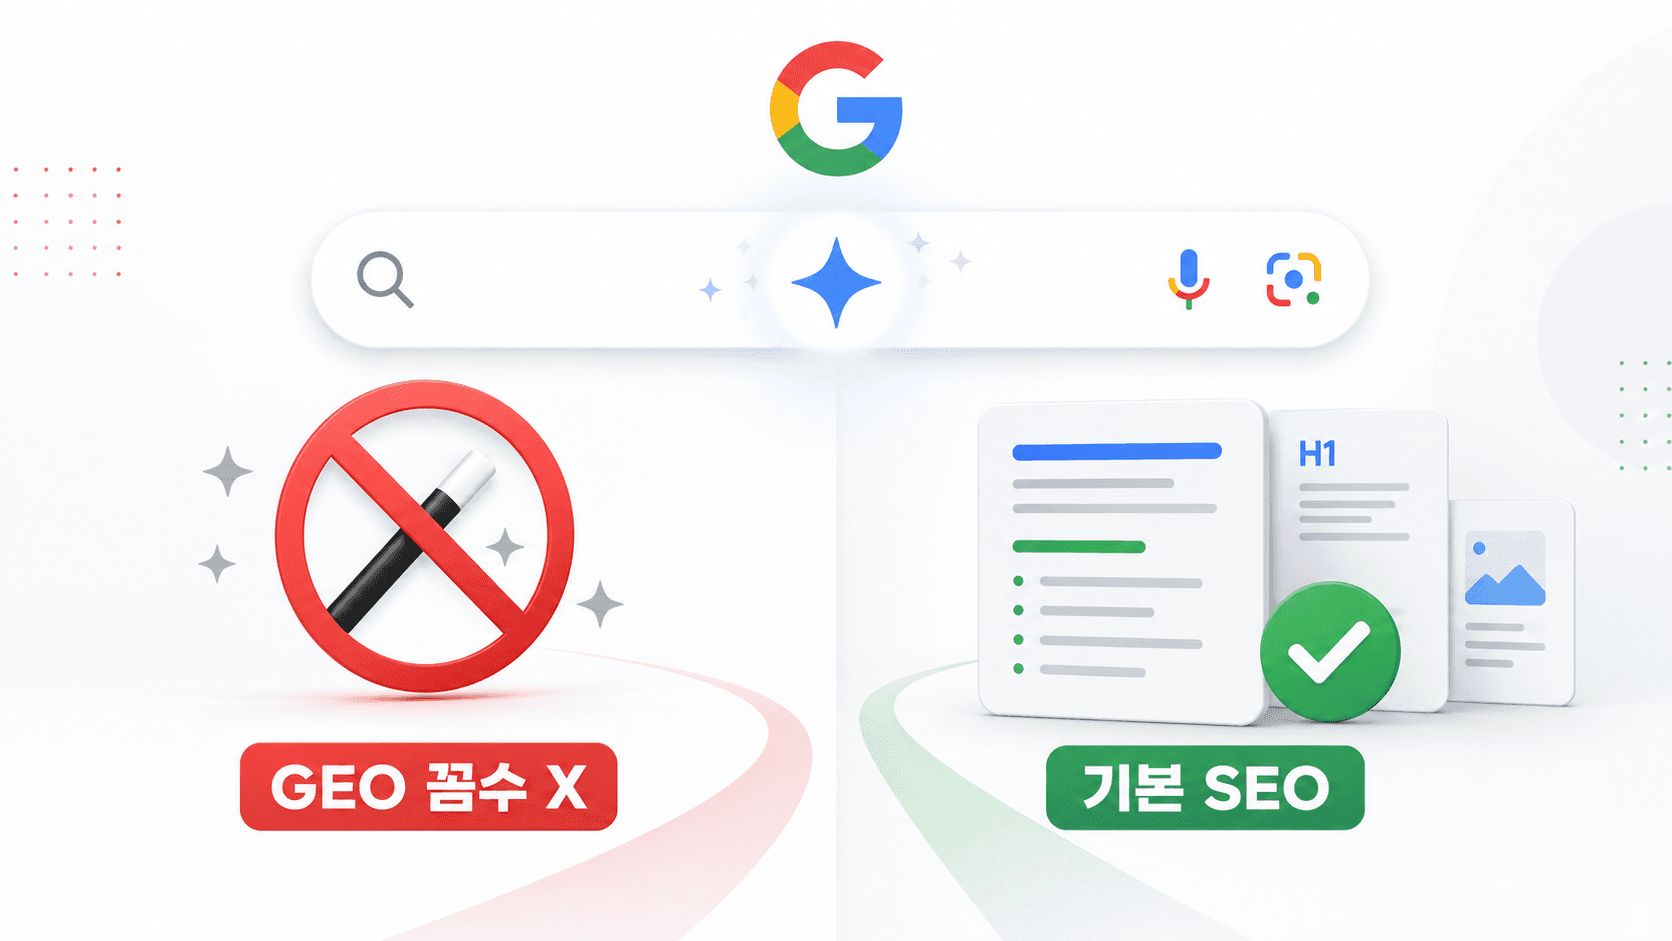
구글이 2026년 5월 공식 AI 검색 최적화 가이드를 냈습니다. "AEO·GEO도 결국 SEO"라는 결론에 저희는 대부분 동의합니다. 다만 그 가이드에 적히지 않은 전제 세 가지가 한국 시장의 실전과 어긋나는 지점을, 원문과 데이터로 정리했습니다. 시리즈 특별편.
구글 검색의 68%는 클릭 없이 끝나고(SparkToro 2026), AI 답변은 확률로 조립됩니다. 저희가 "노출 보장"을 말하지 않는 기술적 이유와, 대신 무엇을 측정하고 약속하는지를 데이터로 정리했습니다. AI 검색의 원리 시리즈 완결편.
"글을 올렸는데 왜 AI가 아직 우리를 모르죠?" AI가 정보를 얻는 두 갈래 — 학습된 기억(pretraining)과 실시간 검색(RAG) — 를 구분하면 답이 보입니다. 구글 공식 문서와 LLM 학습 원리로, 축적에 왜 시간이 걸리는지 정리했습니다. 시리즈 4편.
수백만 원 들인 홈페이지가 AI 답변에는 왜 안 나올까요. AI는 사람이 보는 형태로 글을 수집하지 않기 때문입니다. 프린스턴대 KDD 2024 논문이 1만 개 질의로 검증한 'AI가 인용하는 글쓰기'를 수치 그대로 정리했습니다. 시리즈 3편.
ChatGPT에 같은 질문을 두 번 하면 답이 다릅니다. 버그가 아니라 설계입니다. temperature, 확률 추첨, 검색 변동, 모델 업데이트 — 네 가지 변수로 "AI 노출 100% 보장"이 왜 성립할 수 없는지 팩트로 설명합니다. 시리즈 2편.
AI는 저장된 정답을 꺼내는 기계가 아니라, 매 순간 확률로 문장을 조립하는 기계입니다. 이 원리를 알면 'AI 노출'을 둘러싼 오해가 풀립니다. AI 검색의 원리 시리즈 1편.