RESEARCH / Instorm
TECH SESSION 6편 | AI는 단어의 순서를 어떻게 기억할까?
Transformer는 단어 순서를 어떻게 알까? Positional Encoding과 RoPE 회전 원리, LongRoPE2·MrRoPE 및 긴 컨텍스트의 한계를 설명합니다.

철수가 영희를 쫓는 이야기와 영희가 철수를 쫓는 이야기는 다릅니다. 그런데 Attention만 계산하는 신경망은 순서를 어떻게 알 수 있을까요? 답은 위치를 숫자로 표현하는 방법에 있습니다.
철수가 영희를 쫓았습니다. 그런데 순서를 바꿔보겠습니다
“철수가 영희를 쫓았습니다.”
누가 누구를 쫓았을까요? 철수가 영희를 쫓았습니다.
“영희가 철수를 쫓았습니다.”
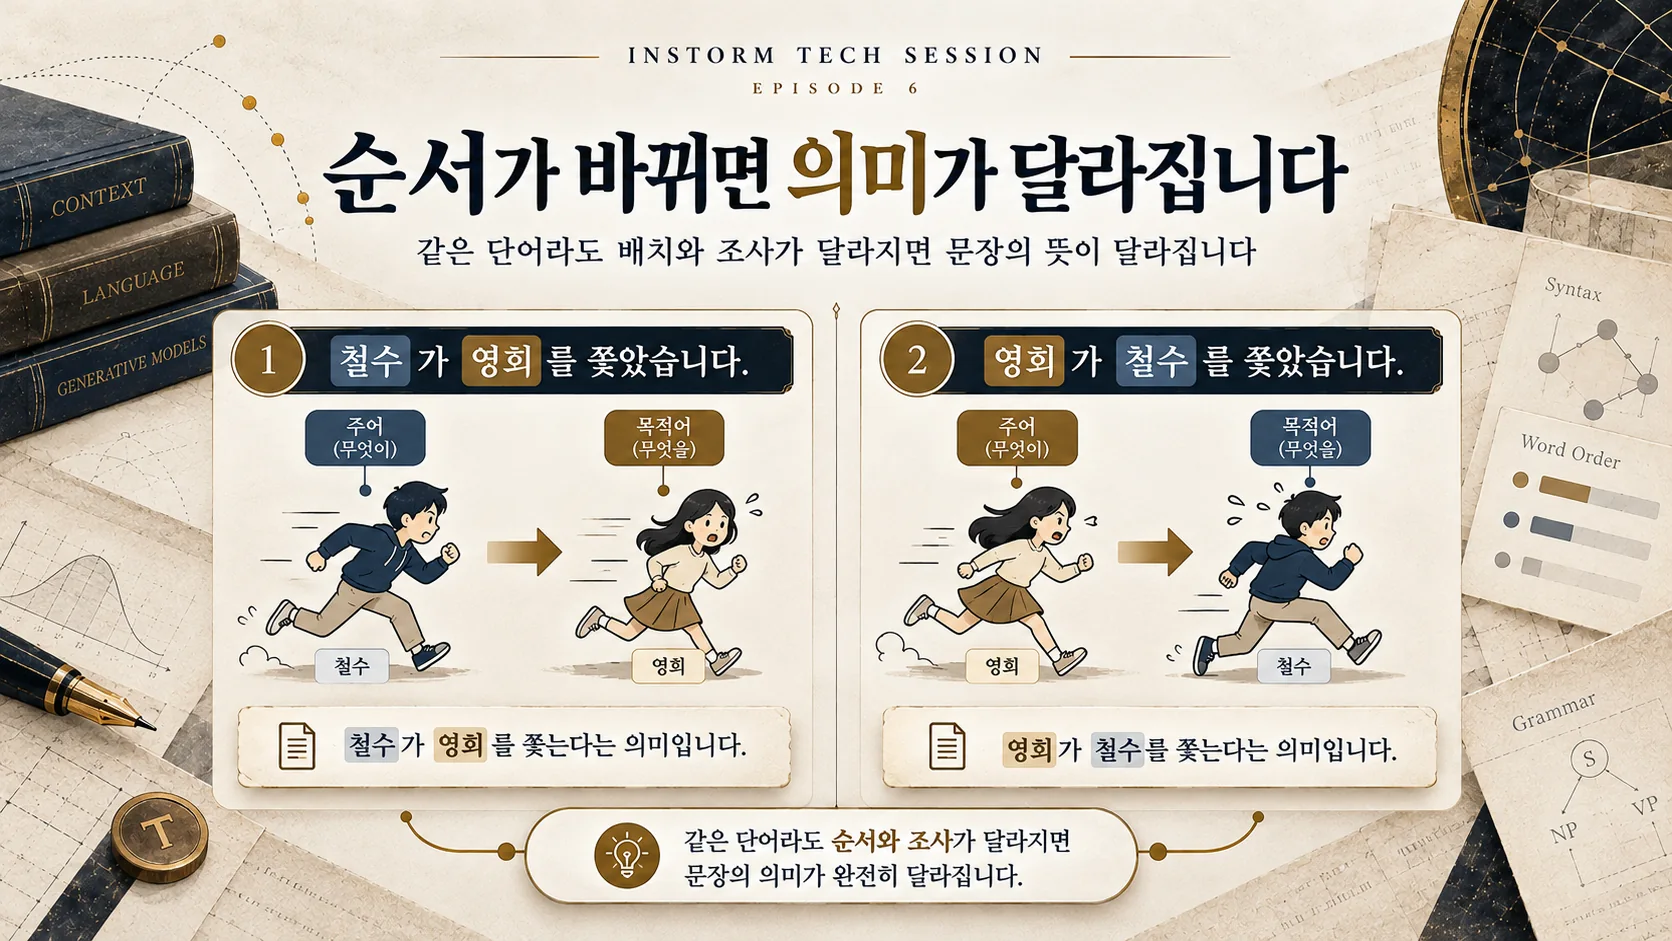
등장하는 이름은 같습니다. 행동도 같습니다. 그러나 이번에는 영희가 철수를 쫓습니다. 사람은 순서와 조사를 함께 읽어 주어와 목적어를 구분합니다.
그런데 컴퓨터는 어떨까요? 지난 4편에서는 Transformer가 Self-Attention(셀프 어텐션)으로 토큰 사이의 관계를 계산한다고 했습니다. 입력의 단어가 같고, 단어의 기본 임베딩도 같다면, 어느 것이 첫 번째이고 어느 것이 세 번째인지는 어떻게 알 수 있을까요?
여기에는 수학적으로 중요한 사실이 하나 있습니다. 순서 신호 없이 전체 입력에 적용하는 기본 Self-Attention은 토큰을 섞으면 그에 맞춰 출력도 섞이는 성질이 있습니다. 이를 Permutation Equivariance(순열 등변성)라고 부릅니다. 토큰 사이의 관계는 계산하지만, 그것만으로 고유한 위치 번호가 생기지는 않습니다.
물론 자기회귀 LLM에서 사용하는 Causal Mask(인과 마스크)는 이전 토큰만 볼 수 있게 하므로, 모델 구조 자체가 순서의 영향을 받기도 합니다. “Transformer는 순서를 전혀 모른다”는 단정은 정확하지 않습니다. 다만 문장의 위치 관계를 명확하게 표현하고 일반화하도록 돕는 장치가 필요합니다.
이 문제에서 등장한 기술이 바로 Positional Encoding(위치 인코딩)입니다.
단어의 위치를 숫자로 알려줄 수 있을까요?
2017년 Attention Is All You Need에서 연구자들은 토큰 임베딩에 위치 정보를 더했습니다. RNN처럼 앞 단어를 순차적으로 읽는 구조에 의존하지 않고도, 모델이 위치를 구별할 수 있게 한 것입니다. (Vaswani et al., 2017)
가장 쉬운 방법은 첫 번째 토큰에 0, 두 번째에 1, 세 번째에 2라는 번호를 붙이는 것입니다. 그러나 단순한 숫자 하나만 추가하는 대신 모델이 처리할 수 있는 벡터로 위치를 표현합니다.
2017년 원논문의 대표적인 방식은 Sine(사인)과 Cosine(코사인)을 이용한 Sinusoidal Positional Encoding(정현파 위치 인코딩)입니다. 삼각함수를 외울 필요는 없습니다. 빠르게 반복하는 파형과 느리게 반복하는 파형을 여러 개 겹친다고 상상해보세요. 위치가 바뀔 때마다 서로 다른 수치 패턴을 만들 수 있습니다.
이 위치 벡터를 단어의 임베딩과 더하면, 똑같은 단어라도 첫 번째 자리에 있을 때와 열 번째 자리에 있을 때 모델이 받는 숫자가 달라집니다.
이와 달리 위치마다 학습 가능한 별도의 벡터를 사용하는 Learned Position Embedding(학습형 위치 임베딩)도 있습니다. 그리고 토큰의 절대 번호가 아니라 토큰들 사이의 거리 자체를 반영하려는 방법도 발전했습니다.
여기서 한 가지 질문이 생깁니다. 위치가 0번과 1번일 때도 한 칸 차이고, 100번과 101번일 때도 한 칸 차이입니다. 이런 상대적인 거리를 자연스럽게 반영하려면 어떨까요?
절대 위치와 상대 위치는 다릅니다
교실의 자리를 생각해보겠습니다. 철수가 1번 자리에 앉고 영희가 2번 자리에 앉아 있습니다. 다음 날 두 사람의 자리가 10번과 11번으로 바뀌었다고 해봅시다.
Absolute Position(절대 위치)은 두 사람의 자리 번호가 달라졌다고 말합니다. Relative Position(상대 위치)은 두 사람 사이가 여전히 한 자리 차이라고 말합니다.
문장에서도 이 구분은 중요합니다. ‘고양이’와 ‘잠든다’가 바로 옆에 나타날 수도 있고, 긴 수식어 때문에 멀리 떨어질 수도 있습니다.
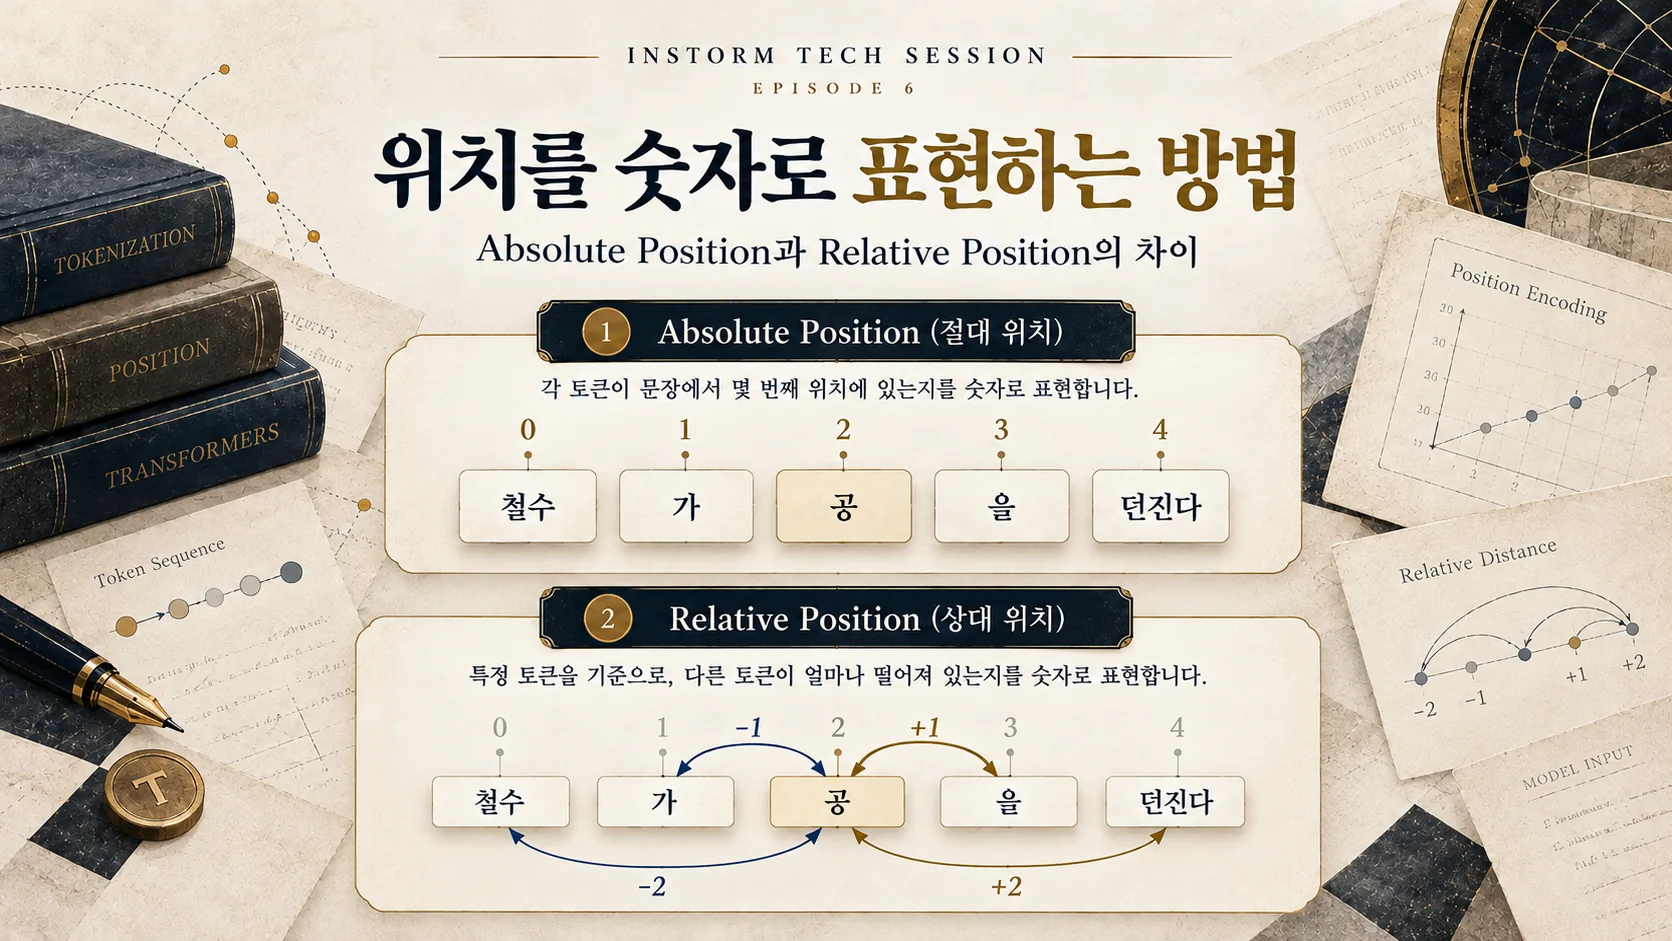
2018년 Peter Shaw와 동료들은 Self-Attention with Relative Position Representations를 발표했습니다. Self-Attention이 토큰의 상대적인 위치 관계도 계산에 반영할 수 있도록 하는 방법을 제안했습니다. (Shaw et al., 2018)
그러나 연구는 거기에서 멈추지 않았습니다. 절대 위치 번호를 그대로 더하거나 상대거리 표현을 따로 저장하는 것 외에 기하학적으로 더 간결한 방법이 있을까요?
2021년, 위치를 이용해 숫자 벡터 자체를 회전시키는 방법이 등장합니다.
2021년, 연구자들은 단어가 아니라 벡터를 회전시켰습니다
2021년 Jianlin Su와 동료들의 RoFormer: Enhanced Transformer with Rotary Position Embedding은 RoPE(Rotary Position Embedding)를 제안했습니다. 이름 그대로 회전으로 위치를 표현합니다. (Su et al., 2021)
“단어를 회전시킨다”는 말은 아닙니다. 종이에 적힌 글자가 돌아가는 것도 아닙니다. 모델 안의 숫자 벡터를 회전시킵니다.
시계바늘을 떠올려보세요. 같은 길이의 바늘도 12시 방향일 수 있고 3시 방향일 수 있습니다. 바늘의 길이는 유지하면서 방향만 달라지는 것입니다.
RoPE의 핵심은 각 토큰이 가진 위치 번호에 따라 Query(Q)와 Key(K)의 벡터 성분 쌍을 서로 다른 각도로 회전시키는 것입니다. 그러면 회전된 Q와 K를 비교할 때 두 위치 사이의 상대적 차이가 자연스럽게 반영됩니다.
왜 그런지 수학 없이도 이해할 수 있도록 실제로 작은 계산을 해보겠습니다.
숫자 두 개만으로 RoPE의 핵심을 계산해 보겠습니다
오른쪽을 가리키는 길이 1인 화살표를 생각합시다. 숫자로는 (1,0)입니다. 이 예시에서 위치가 한 칸 늘어날 때마다 45도씩 회전한다고 가정해보겠습니다.
- 0번 위치: 0도, 오른쪽을 가리킴
- 1번 위치: 45도, 오른쪽 위를 가리킴
- 2번 위치: 90도, 위를 가리킴
실제 RoPE에서 모든 차원에 45도가 적용되는 것은 아닙니다. 원리를 보여주기 위한 단일 2차원 가상 설정입니다.
두 화살표의 방향이 얼마나 비슷한지 알아보기 위해 내적(Dot Product)을 계산합니다. 길이가 1인 두 화살표의 내적은 두 화살표 사이 각도의 코사인 값과 같습니다.
| 비교 위치 | 위치 차이 | 각도 차이 | 내적 |
|---|---|---|---|
| 1번과 0번 | 1 | 45° | 약 0.707 |
| 11번과 10번 | 1 | 45° | 약 0.707 |
| 2번과 0번 | 2 | 90° | 0 |
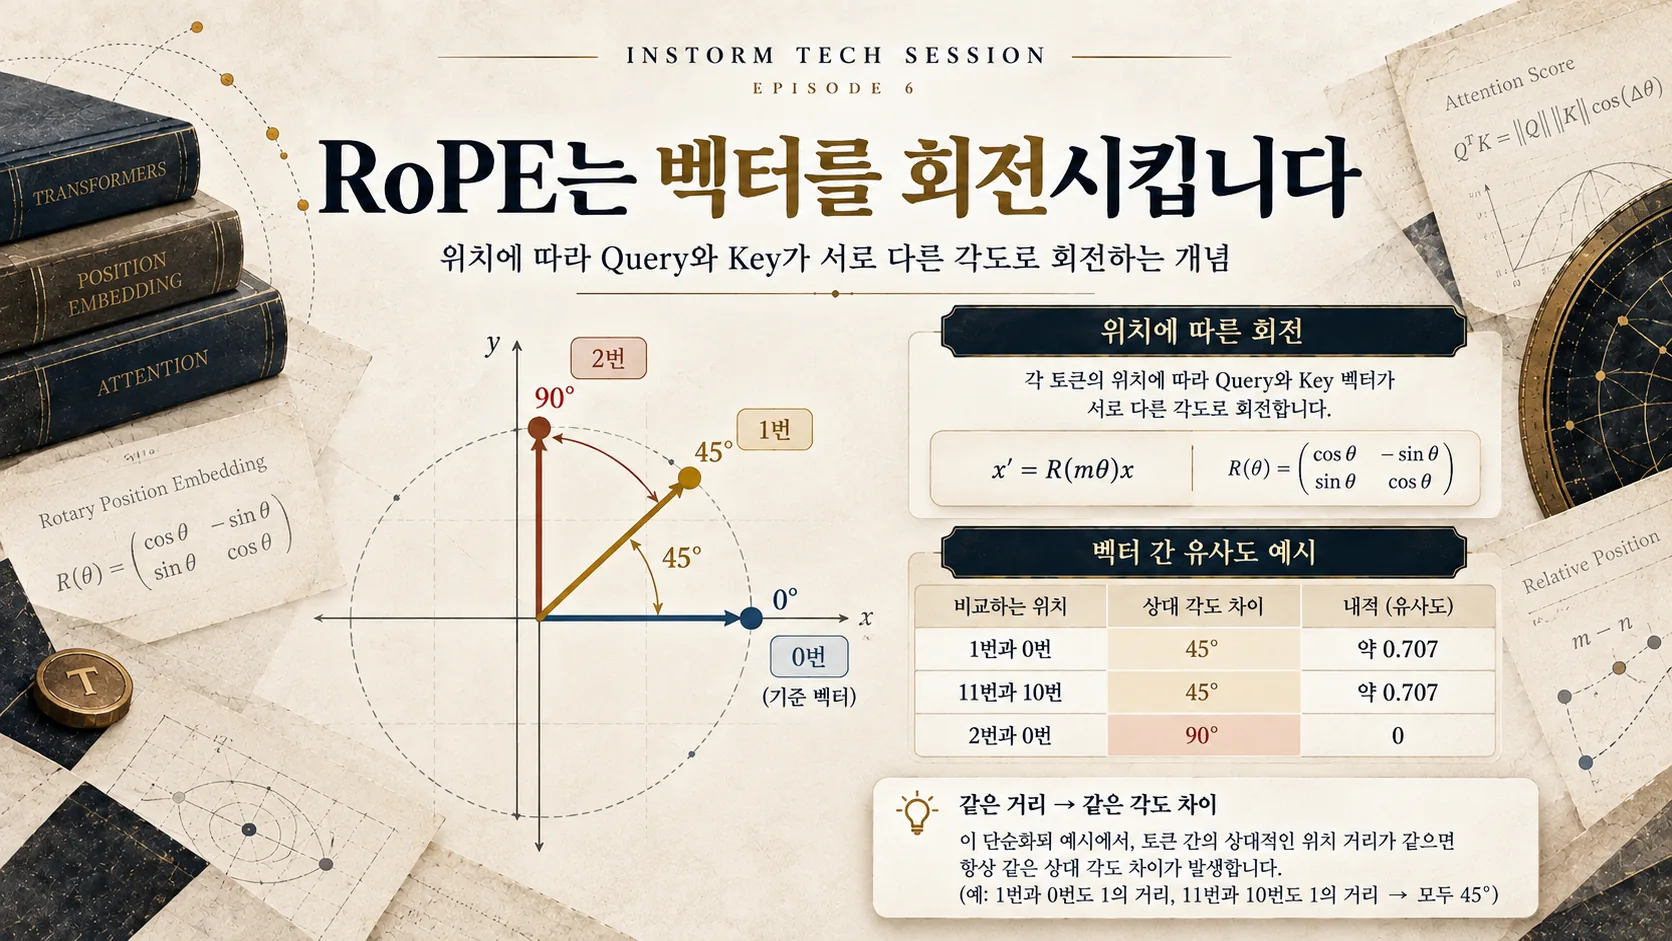
같은 기본 벡터를 사용하고 위치당 45도로 회전시킨 교육용 가상 계산입니다. 실제 LLM의 Attention 점수나 성능 측정이 아닙니다.
절대 위치는 1과 0에서 11과 10으로 크게 달라졌지만, 거리는 한 칸으로 똑같습니다. 회전된 벡터 사이의 각도 차이도 같기 때문에 내적이 같습니다.
그렇다고 두 토큰의 상대 거리가 같으면 현실의 모델에서 Attention 점수도 언제나 같다는 뜻은 아닙니다. 실제 Q와 K의 값은 토큰 내용과 문맥에 따라 달라집니다. RoPE가 담당하는 것은 그 비교 속에 위치 관계를 반영하는 일입니다.
이렇게 보면 RoPE는 특별한 기억 창고가 아닙니다. 위치를 표현하는 계산 규칙입니다.
RoPE는 Transformer의 어디에 들어갈까요?
4편에서 배운 Attention을 떠올려봅시다. 입력 토큰 표현 X를 선형 변환해 Q와 K, V를 만들었습니다. 이후 Q와 K의 내적으로 점수를 계산하고, Softmax와 V의 가중합을 수행합니다.
RoPE를 사용하는 일반적인 구현에서는 Q와 K를 만든 다음, 위치에 따른 회전을 적용하고, 회전된 Q·K로 점수를 계산합니다. 보통 V에는 같은 회전을 적용하지 않습니다.
실제 고차원 RoPE는 숫자 두 개씩을 묶어 회전합니다. 서로 다른 차원 쌍에는 서로 다른 주파수가 적용되므로 빠르게 도는 쌍과 느리게 도는 쌍이 함께 위치 관계를 표현합니다.
이 구조에는 장점이 있습니다. 회전된 Q와 K의 내적을 상대 위치 차이에 의존하는 형태로 쓸 수 있습니다. 그러나 회전을 계산할 수 있다고 해서 무한히 긴 문장을 정확히 다룬다는 뜻은 아닙니다.
특히 모델이 학습할 때 보지 못했던 매우 긴 위치를 입력하면 별도의 문제가 시작됩니다.
왜 긴 문장에서는 위치를 다시 연구해야 할까요?
어떤 모델이 학습할 때 2,048토큰 길이의 문맥을 주로 봤다고 가정해보겠습니다. 그런데 실제로 32,768토큰 길이의 문서를 입력하려 한다면 어떨까요?
RoPE의 위치 회전 규칙은 계산할 수 있습니다. 그러나 모델이 학습 범위를 벗어난 위치에서도 안정적으로 예측할지는 별도 문제입니다. 이를 Extrapolation(외삽) 문제라고 부릅니다.
2023년 Shouyuan Chen과 동료들은 Extending Context Window of Large Language Models via Positional Interpolation을 발표했습니다. 핵심은 더 큰 위치 번호를 그대로 대입하기보다 위치 값을 압축해 기존 학습 범위에 대응시키는 Position Interpolation(위치 보간)입니다.
연구진은 LLaMA 7B~65B 등의 모델을 대상으로 최대 32,768토큰까지 문맥 길이를 늘리는 실험을 보고했고, 논문에서는 추가 학습을 1,000단계 이내로 진행한 설정들을 설명했습니다. 이는 해당 모델·학습 구성에 대한 결과입니다. (Chen et al., 2023)
2025년 ICML의 LongRoPE2: Near-Lossless LLM Context Window Scaling은 긴 위치 표현을 개선하는 또 다른 접근을 연구했습니다. LLaMA3-8B와 Phi3-mini-3.8B를 평가했으며, LLaMA3-8B를 128K의 유효 문맥으로 확장하면서 원래 짧은 문맥 성능의 98.5% 이상을 유지했다고 보고했습니다. ‘모든 작업에서 정확도 98.5%’라는 뜻이 아니라 원래 단문 성능 대비 유지율에 관한 논문 수치입니다. (Shang et al., ICML 2025)
2026년 ICLR의 MrRoPE: Mixed-radix Rotary Position Embedding은 RoPE 확장을 통합적으로 설명하는 수학적 관점을 제안했습니다. 추가 미세조정이 없는 MrRoPE-Pro 실험에서 128K 길이 Needle-in-a-Haystack 평가의 Recall 85% 이상, 일부 Infinite-Bench 검색·대화 과제에서 YaRN 대비 두 배를 넘는 정확도를 보고했습니다. 모두 해당 평가 설정에서 얻은 결과입니다. (Tian et al., ICLR 2026)
이처럼 긴 문맥 기술은 계속 발전합니다. 그러나 여기서 마지막으로 중요한 구분이 남았습니다.
길게 입력할 수 있다는 것과 잘 찾아 쓴다는 것은 다릅니다
아주 긴 책에서 정답을 찾아야 한다고 상상해보겠습니다. 모델이 책 전체를 입력받을 수 있게 됐다고 해서, 가운데 숨어 있는 문장을 반드시 정확히 찾아낼까요?
2024년 Lost in the Middle: How Language Models Use Long Contexts에서 연구진은 긴 문맥의 처음이나 끝에 정보가 있을 때보다 중간에 있을 때 성능이 떨어지는 현상을 여러 모델과 과제에서 관찰했습니다. 이 효과가 모든 모델, 모든 상황에서 동일한 곡선으로 나타난다는 뜻은 아닙니다. (Liu et al., TACL 2024)
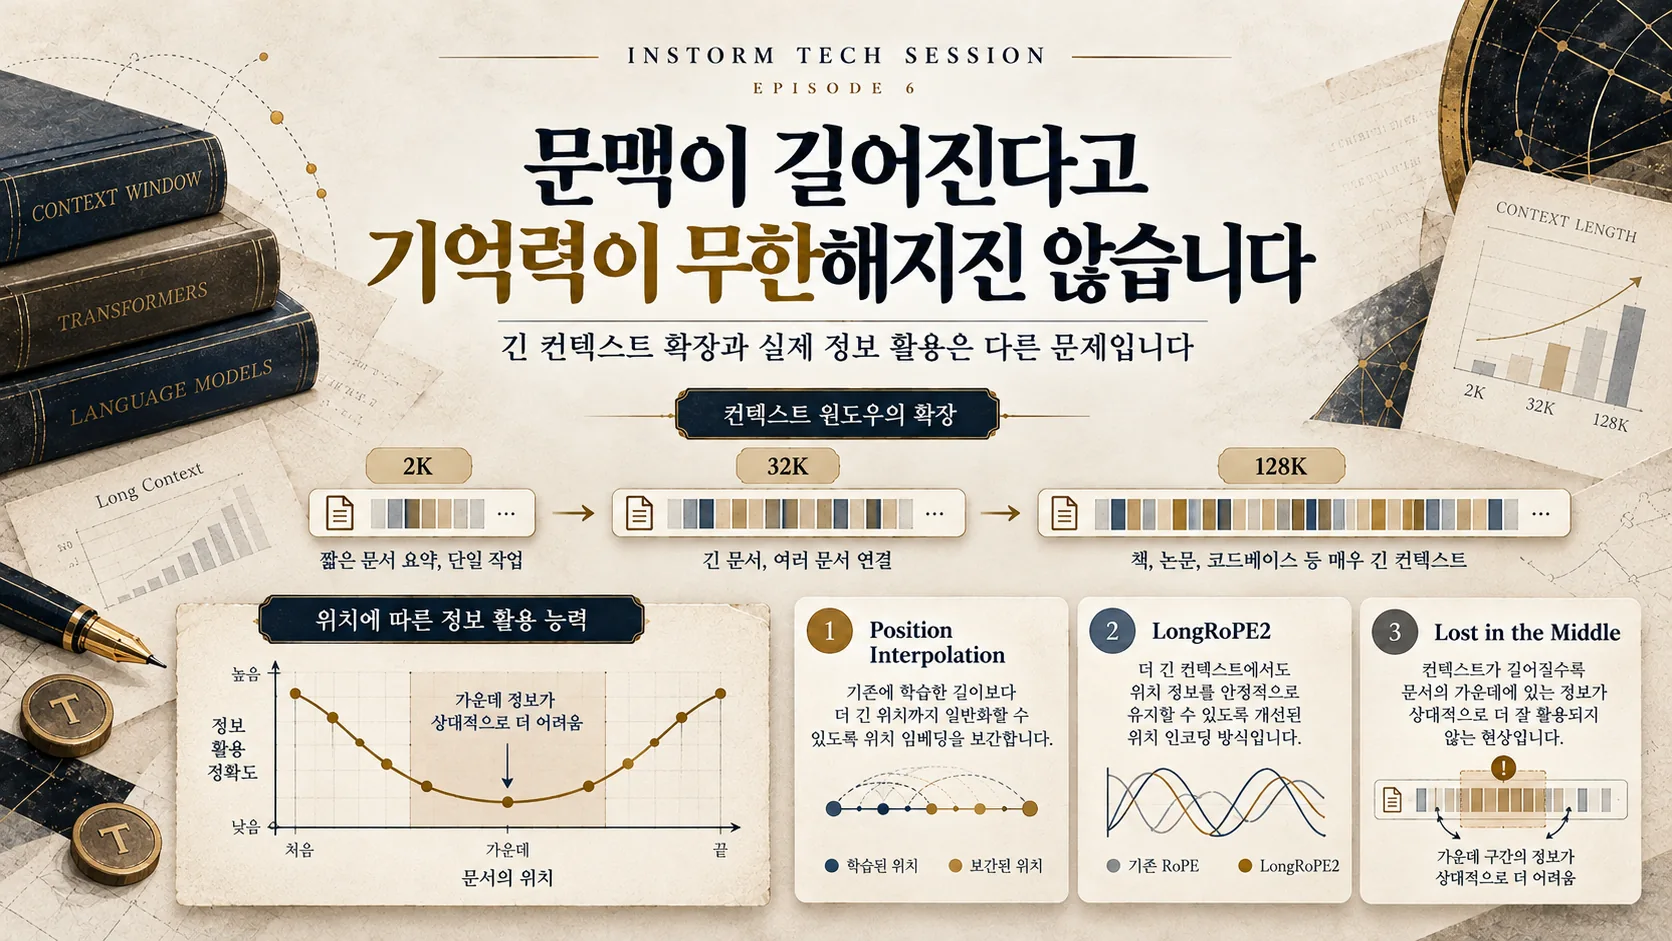
따라서 Context Window(컨텍스트 윈도우)의 크기는 ‘한 번에 입력할 수 있는 토큰 범위’를 뜻할 뿐, 그 안에 들어간 모든 내용을 동등하게 활용한다는 보장이 아닙니다.
Positional Encoding과 RoPE가 해결한 문제는 문장의 위치 관계를 모델 계산에 반영하는 방법입니다. 이후 연구들은 그 위치 표현을 더 긴 입력으로 확장해 왔습니다. 그러나 정보를 실제로 얼마나 정확히 활용하는가는 여전히 별도의 평가가 필요합니다.
그렇다면 다음 질문이 생깁니다. AI는 왜 대화가 길어지면 앞에서 했던 이야기를 놓칠까요? 7편에서는 컨텍스트 윈도우, 입력 잘림, 그리고 Lost in the Middle을 깊이 살펴보겠습니다.
참고 자료
- Vaswani et al. (2017), Attention Is All You Need — 기본 Transformer 위치 인코딩.
- Shaw et al. (2018), Self-Attention with Relative Position Representations — 상대 위치 표현.
- Su et al. (2021), RoFormer: Enhanced Transformer with Rotary Position Embedding — RoPE 원전.
- Chen et al. (2023), Extending Context Window of Large Language Models via Positional Interpolation — Position Interpolation.
- Liu et al. (2024), Lost in the Middle: How Language Models Use Long Contexts — 문맥 내 위치별 정보 활용.
- Shang et al. (2025), LongRoPE2: Near-Lossless LLM Context Window Scaling — 128K 유효 문맥과 짧은 문맥 성능 유지.
- Tian et al. (2026), MrRoPE: Mixed-radix Rotary Position Embedding — RoPE의 확장 방식 비교.