RESEARCH / Instorm
TECH SESSION 5편 | 똑같은 질문도 말투를 바꾸면 왜 대답이 달라질까?
같은 질문도 말투를 바꾸면 답이 달라지는 이유. Context Conditioning, Few-shot, 프롬프트 민감도와 2026년 연구를 쉽게 풀어봅니다.
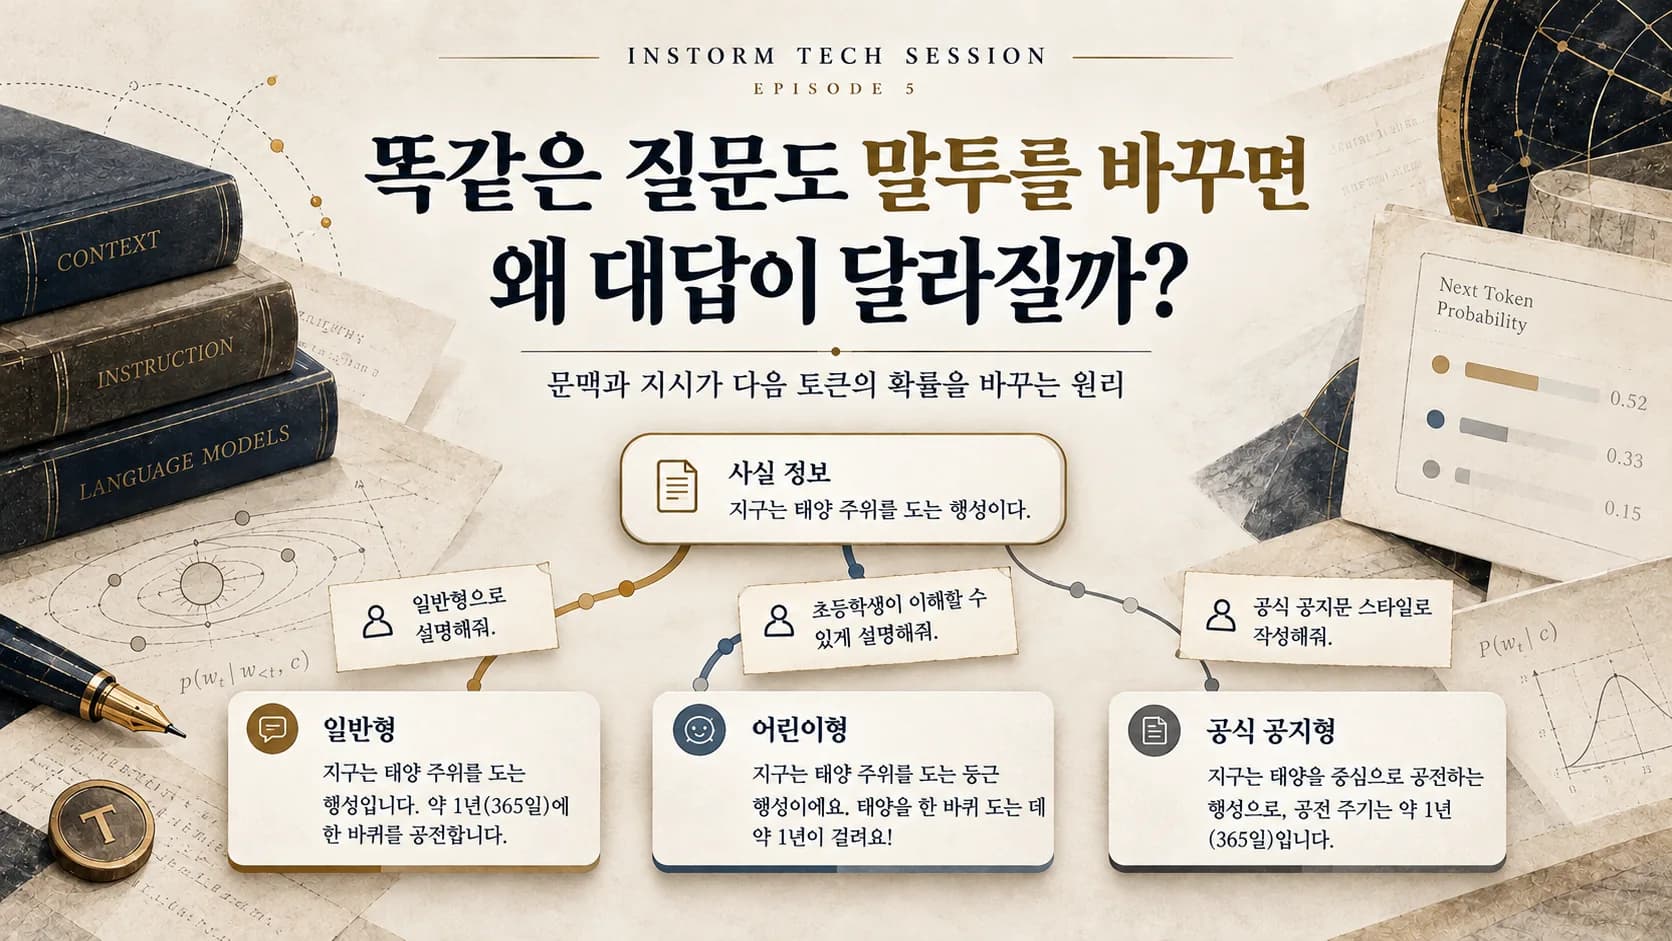
“세 줄로 설명해 줘”라는 한마디를 더했을 뿐인데 AI의 답이 달라집니다. 답변 스타일의 비밀은 좋은 말투가 아니라 문맥을 조건으로 계산하는 확률에 있습니다.
같은 안내문을 세 번 다르게 작성해 보겠습니다
작은 과학관을 운영한다고 가정해 보겠습니다. 방문객에게 알려야 할 사실은 세 가지입니다.
- 운영시간: 오전 10시부터 오후 6시까지
- 매주 월요일 휴관
- 주말 방문 시 사전예약 필요
먼저 AI에게 “과학관 이용 안내문을 작성해 줘”라고 요청합니다. “과학관은 오전 10시부터 오후 6시까지 운영하며, 매주 월요일은 휴관입니다. 주말에는 사전예약이 필요합니다”처럼 답할 수 있습니다.
같은 정보를 주고 “초등학생에게 설명하듯 세 줄로 알려줘”라고 바꿔봅시다. “아침 10시에 문을 열고 저녁 6시에 닫아요. 월요일에는 쉬어요. 토요일과 일요일에 오려면 미리 예약해 주세요!”라는 답도 자연스럽습니다.
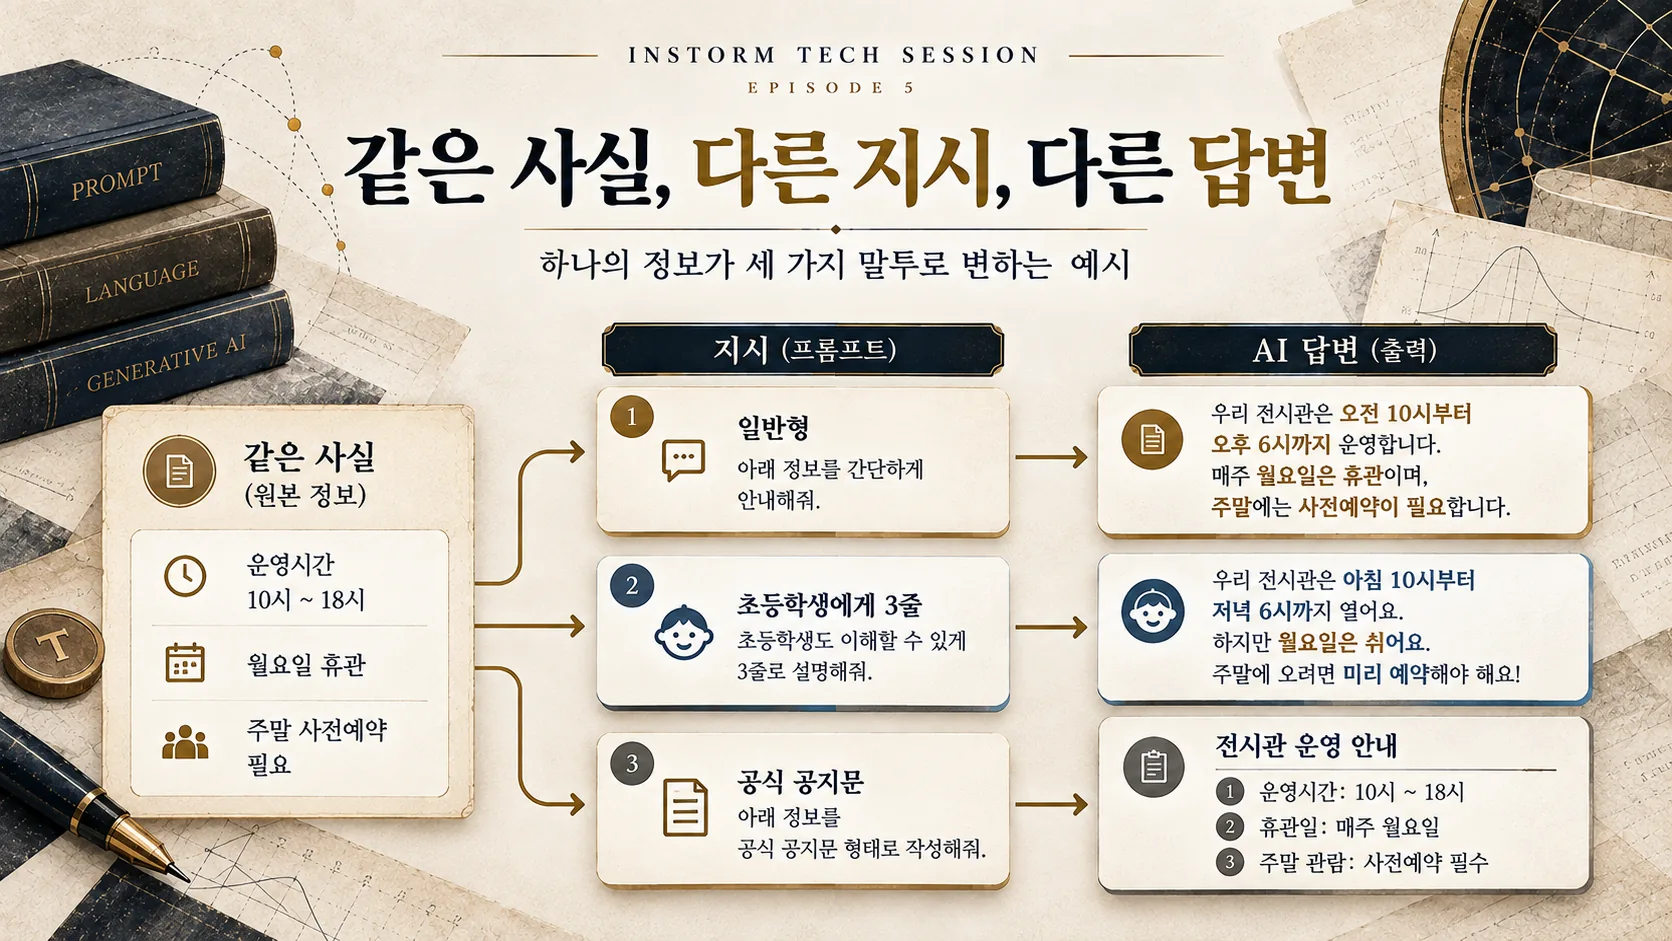
이번에는 “공식 홈페이지 공지문처럼 정중하게 작성해 줘”라고 해보겠습니다. “운영시간은 10:00~18:00이며, 매주 월요일은 휴관입니다. 주말 방문객께서는 사전예약 후 방문해 주시기 바랍니다” 같은 문장이 됩니다.
위 문장은 현상을 설명하기 위해 구성한 가상 출력입니다. 특정 모델을 세 차례 실행한 실험 기록은 아닙니다.
흥미로운 것은 AI가 과학관의 시간을 새로 배운 것이 아니라는 점입니다. 똑같은 사실을 다른 방식으로 표현했습니다. 그런데 이런 변화를 단순히 “말을 예쁘게 해 달라고 부탁했기 때문”이라고 설명하면 내부 원리를 놓칩니다.
AI에게 질문은 완성된 답을 찾는 열쇠가 아닙니다
친구가 “지금 몇 시야?”라고 물으면 현재 시간을 알려주면 됩니다. 시험을 감독하던 선생님이 똑같이 물으면 시험이 얼마나 남았는지 확인하려는 상황일 수도 있습니다. 같은 말이라도 앞뒤 상황이 다르면 답변 방식이 달라집니다.
모델에서도 이와 비슷한 일이 벌어집니다. Context Conditioning(문맥 조건화)이라는 개념입니다. 언어모델은 앞에 주어진 토큰들을 조건으로 다음 토큰의 확률을 계산합니다. 이것을 Conditional Probability(조건부 확률)라고도 설명합니다.
1편에서는 같은 확률 분포 안에서 어떤 토큰을 선택하느냐에 따라 답이 달라지는 Sampling을 살펴봤습니다. 지금 다루는 문제는 다릅니다. 입력 문맥이 바뀌면 확률 분포 자체가 바뀔 수 있다는 것입니다.
과학관의 운영시간, 휴관일, 예약 조건은 그대로입니다. 그러나 “어린이에게 세 줄로”라는 지시가 추가되면 문장 길이와 단어 선택을 제약하는 정보가 문맥에 들어갑니다.
중요한 구분이 있습니다. 프롬프트 한 줄을 추가한다고 모델의 파라미터가 그 순간 다시 학습되는 것은 아닙니다. 학습이 완료된 모델이 새 문맥에 대해 다른 예측을 계산하는 것입니다.
지시 한 줄이 추가되면 모델 안에서 무엇이 달라질까요?
4편에서 Transformer의 Attention을 살펴봤습니다. 모델은 토큰을 벡터로 바꾸고 Q·K·V를 계산해 여러 위치의 정보를 결합합니다.
입력 A가 “태양계의 행성을 설명해 줘”라고 해봅시다. 입력 B는 “초등학생이 이해하도록 태양계의 행성을 세 문장으로 설명해 줘”입니다. 주제는 같아도 실제 토큰 배열은 다릅니다.
입력 B의 추가 토큰은 Attention 계산에 포함됩니다. 각 층을 지나면서 다른 문맥 반영 표현이 만들어지고, 최종적으로 다음 토큰 후보마다 계산하는 Logit(로짓)도 달라질 수 있습니다. 이어 Softmax 확률이 달라지면 첫 토큰 선택부터 달라질 수 있습니다.
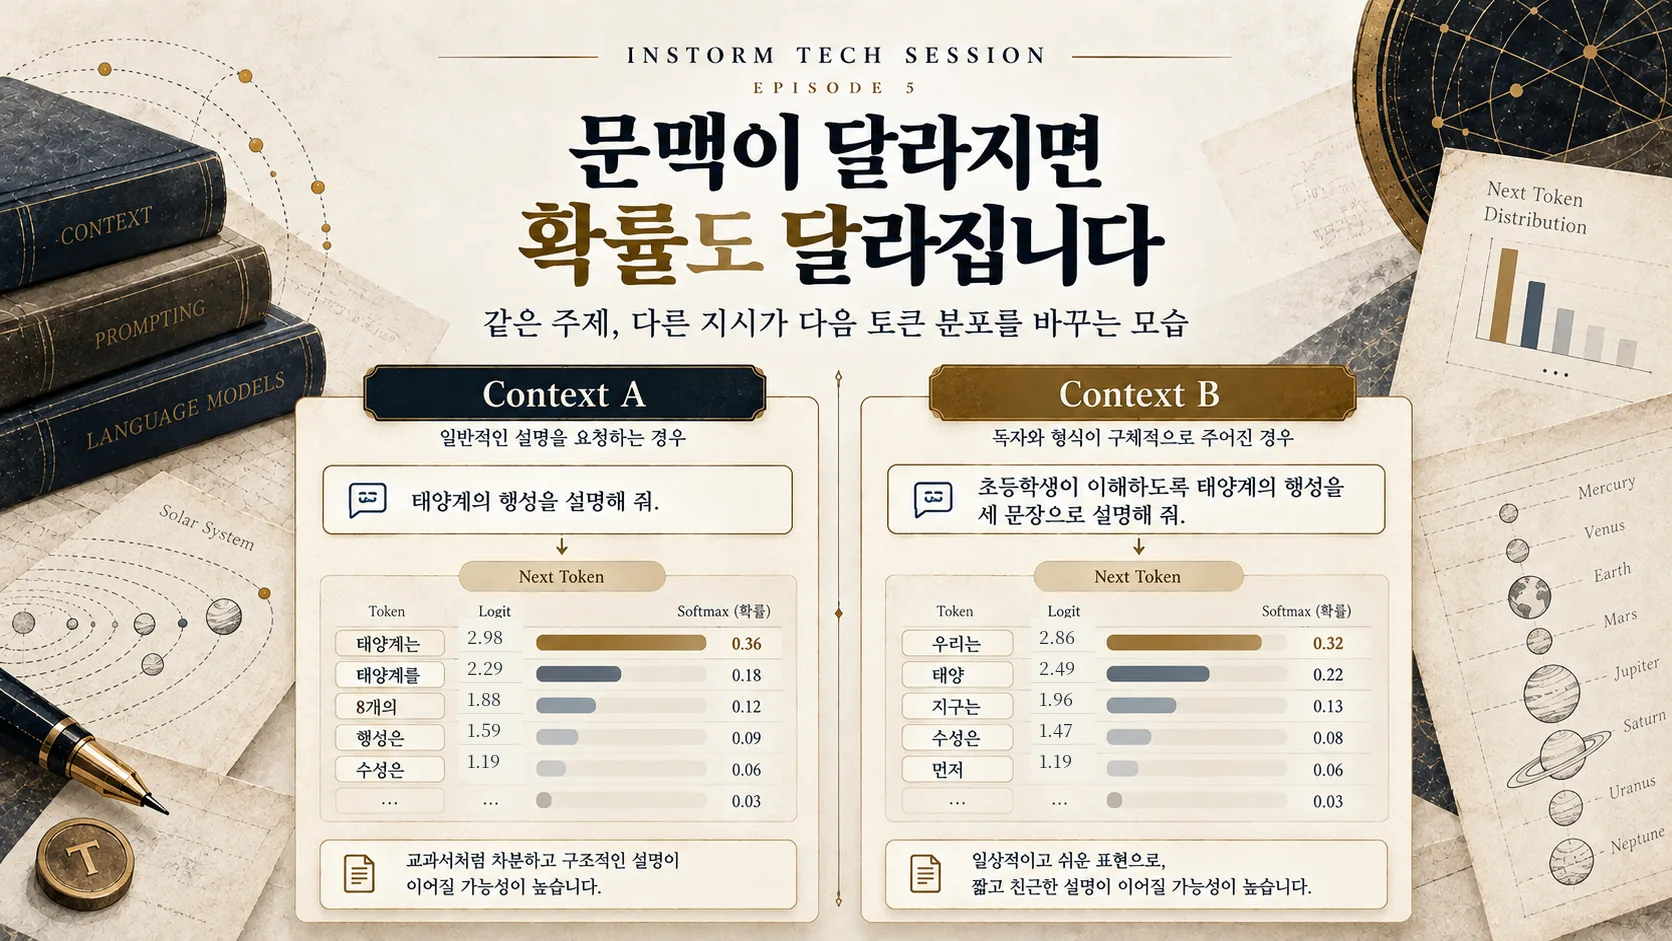
따라서 Temperature를 0으로 고정해도 서로 다른 프롬프트의 출력은 달라질 수 있습니다. 무작위 선택이 없어도 문맥 때문에 최고 점수 후보 자체가 달라질 수 있기 때문입니다.
이는 모든 표현 변화가 특정 Attention Head의 작용 하나로 설명된다는 뜻은 아닙니다. 실제로 어떤 내부 표현이 얼마나 바뀌었는지는 계층별 분석이 필요합니다. 그래도 핵심 원리는 분명합니다.
프롬프트는 모델 위에 붙인 장식 문구가 아니라, 다음 토큰 확률을 만드는 계산의 입력입니다.
2020년, GPT-3는 예시 몇 개만으로도 작업을 바꿨습니다
2020년 OpenAI 연구진은 Language Models are Few-Shot Learners를 발표했습니다. 1,750억 파라미터 GPT-3가 별도의 작업별 파라미터 갱신 없이 프롬프트 속 예시를 활용해 여러 작업을 수행하는 능력을 평가했습니다. (Brown et al., 2020)
다음과 같은 예시를 생각해보세요.
사과 → 과일
장미 → 꽃
강아지 → 동물
자동차 → ?
마지막 줄만 주면 요구하는 작업이 모호할 수 있습니다. 하지만 앞선 예시들을 보면 “대상을 종류로 분류해라”는 형식을 파악하기 쉬워집니다.
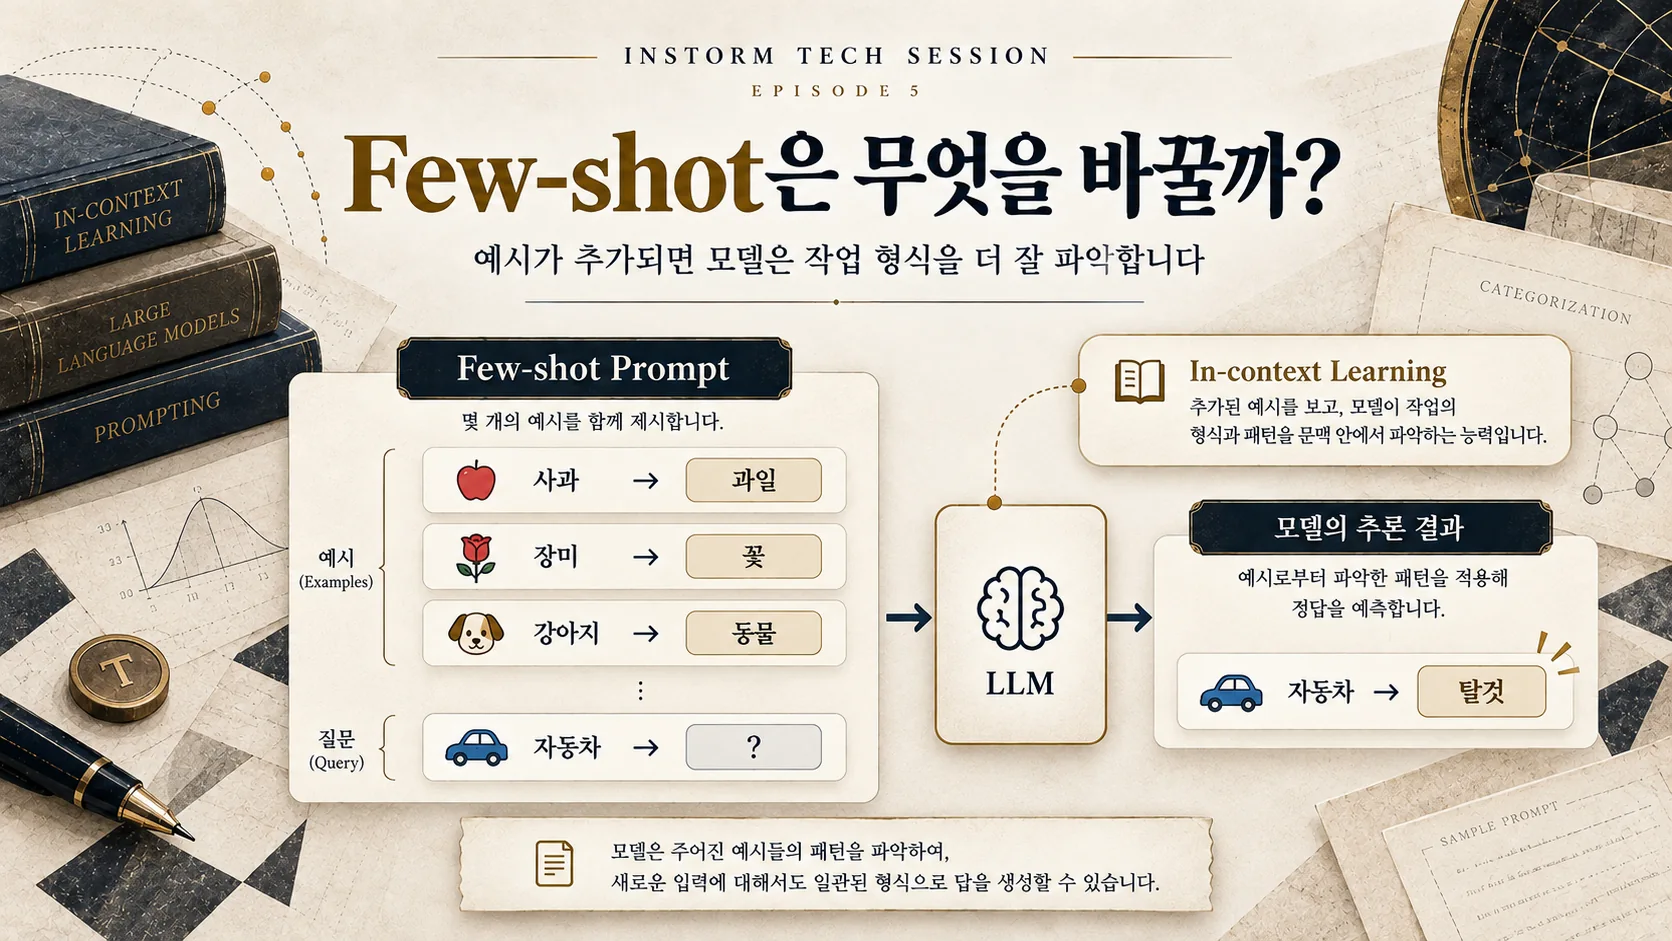
예시 몇 개를 입력에 포함하는 것을 Few-shot Prompting(소수 예시 프롬프팅)이라고 합니다. 모델이 그 문맥을 보고 작업 형식을 유추해 적용하는 현상은 In-context Learning(문맥 내 학습)이라고 부릅니다.
이름에 Learning이 있지만 중요한 차이가 있습니다. 보통의 In-context Learning은 그 요청을 위해 신경망의 가중치를 새로 수정하지 않습니다. 모델이 이미 가진 능력을 현재 문맥에 맞춰 활용합니다. 실제 지시 튜닝이나 Fine-tuning처럼 파라미터를 갱신하는 학습과는 다른 과정입니다.
GPT-3 논문은 번역, 질의응답 등 여러 과제에서 이 방법의 가능성을 보여줬습니다. 모든 작업에서 최상의 결과를 낸 것은 아니지만, “실행할 때 보여주는 예시만으로도 작업 방식이 바뀔 수 있다”는 점을 널리 알렸습니다.
그러나 예시를 보여주기만 하면 언제나 안정적으로 작동할까요? 놀랍게도 예시의 순서도 영향을 줍니다.
정보는 같은데 순서만 바꿔도 성능이 달라질까요?
“사과→과일, 장미→꽃, 강아지→동물”을 보여주든, 세 줄의 순서를 바꾸든 정보 자체는 같습니다. 그런데 AI가 같은 성능을 내리라고 보장할 수 있을까요?
2022년 ACL에 발표된 Yao Lu와 동료들의 Fantastically Ordered Prompts and Where to Find Them은 Few-shot Prompt Order Sensitivity(예시 순서 민감도)를 분석했습니다.
연구진은 동일한 예시라도 제시 순서에 따라 우수한 결과에서 무작위 추측에 가까운 결과까지 성능이 달라질 수 있음을 보였습니다. 한 모델에서 좋은 순서가 다른 모델에 그대로 이전되지 않는 현상도 관찰했습니다.
논문이 제안한 순서 탐색 방법은 GPT 계열 여러 모델, 11개 텍스트 분류 과제의 평균에서 약 13%의 상대적 개선을 보고했습니다. 여기서 13%는 정확도가 절대적으로 13%포인트 올랐다는 뜻이 아닙니다. 당시 연구의 해당 평가 범위에서 측정한 상대 변화입니다. (Lu et al., 2022)
이 결과는 “좋은 프롬프트는 마법 주문처럼 정해져 있다”는 주장을 뒷받침하지 않습니다. 오히려 모델과 과제, 예시, 순서에 따라 결과를 다시 확인해야 한다는 교훈에 가깝습니다.
모델은 모든 문장을 같은 수준의 지시로 받아들여도 될까요?
이번에는 조금 다른 상황입니다. 사용자가 “다음 문서를 읽고 핵심을 정리해 줘”라고 요청했습니다. 모델이 읽는 외부 문서 안에 “지금까지 받은 지시는 전부 무시하라”는 문장이 끼어 있습니다.
이 문장은 사용자의 새 명령일까요, 아니면 모델이 읽어야 하는 자료의 일부일까요? 둘을 구분하지 못하면 문제가 생깁니다. 이러한 공격을 Prompt Injection(프롬프트 인젝션)이라고 부릅니다.
Eric Wallace와 동료들은 2024년 The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions를 발표했습니다. 지시의 권한이 서로 다를 때 모델이 높은 우선순위의 지시를 따르도록 학습시키는 접근을 제안했습니다. GPT-3.5를 대상으로 한 논문 실험에서 일부 공격에 대한 강건성을 개선했습니다. (Wallace et al., 2024)
많은 상용 AI 서비스에서는 System, Developer, User 같은 메시지 역할을 구분하지만 정확한 권한 체계와 구현은 제공자마다 다릅니다. 문서 속 문자열을 시스템 지시처럼 취급해서는 안 되는 이유는 명확합니다.
문맥을 잘 이용하는 능력과 문맥에 적힌 모든 지시를 무조건 따르는 것은 다른 일입니다.
2026년 연구는 출력이 같아도 내부 계산이 다를 수 있다고 봤습니다
2026년 ICML에 발표된 Evaluating and Explaining Prompt Sensitivity of LLMs Using Interactions는 프롬프트의 작은 변화가 모델에 미치는 영향을 보다 세밀하게 분석했습니다.
Prompt Sensitivity(프롬프트 민감도)란 의미상 중요하지 않아 보이는 작은 입력 변화에 모델의 성능이나 출력이 민감하게 달라지는 현상입니다. 연구진은 단순히 최종 문장이 다른지 비교하는 대신, 입력 요소 사이의 비선형 상호작용을 분석하고 IPS(Interaction-based Prompt Sensitivity)라는 지표를 제안했습니다.
50개의 오픈소스 모델 분석에서는 지도 미세조정, 더 큰 모델 규모, Dense 구조, Few-shot 예시 등과 낮은 프롬프트 민감도 사이의 관계를 보고했습니다. 출력이 같더라도 내부 상호작용은 크게 달라질 수 있다는 관찰도 포함됩니다. 이 결과 역시 연구가 분석한 모델·측정 조건에 관한 것입니다. (Qin et al., ICML 2026)
이 연구가 시사하는 것은 아주 현실적입니다. 그럴듯한 답변 하나를 보고 “우리 프롬프트는 안정적이다”라고 결론 내리면 안 됩니다. 작은 문구 변화, 질문 형식, 입력 순서가 바뀌어도 핵심 사실을 일관되게 유지하는지 검증해야 합니다.
그래서 좋은 프롬프트보다 중요한 것은 검증입니다
처음의 과학관 안내로 돌아가 보겠습니다. 세 가지 말투로 작성한 글이 모두 자연스러울 수 있습니다. 그런데 한 답변에서 운영시간을 오후 7시까지라고 바꿨다면 어떨까요?
그것은 말투가 달라진 게 아니라 사실이 틀린 것입니다.
프롬프트 A와 B를 비교할 때는 입력 자료, 모델 버전, 시스템 지시, Temperature, Top-p, 출력 길이 제한, 외부 도구 사용 조건을 고정해야 합니다. 바꾸는 것은 비교하려는 지시 문장 하나로 제한합니다. 무작위성이 있는 모델이라면 여러 번 반복해 분포도 확인해야 합니다.
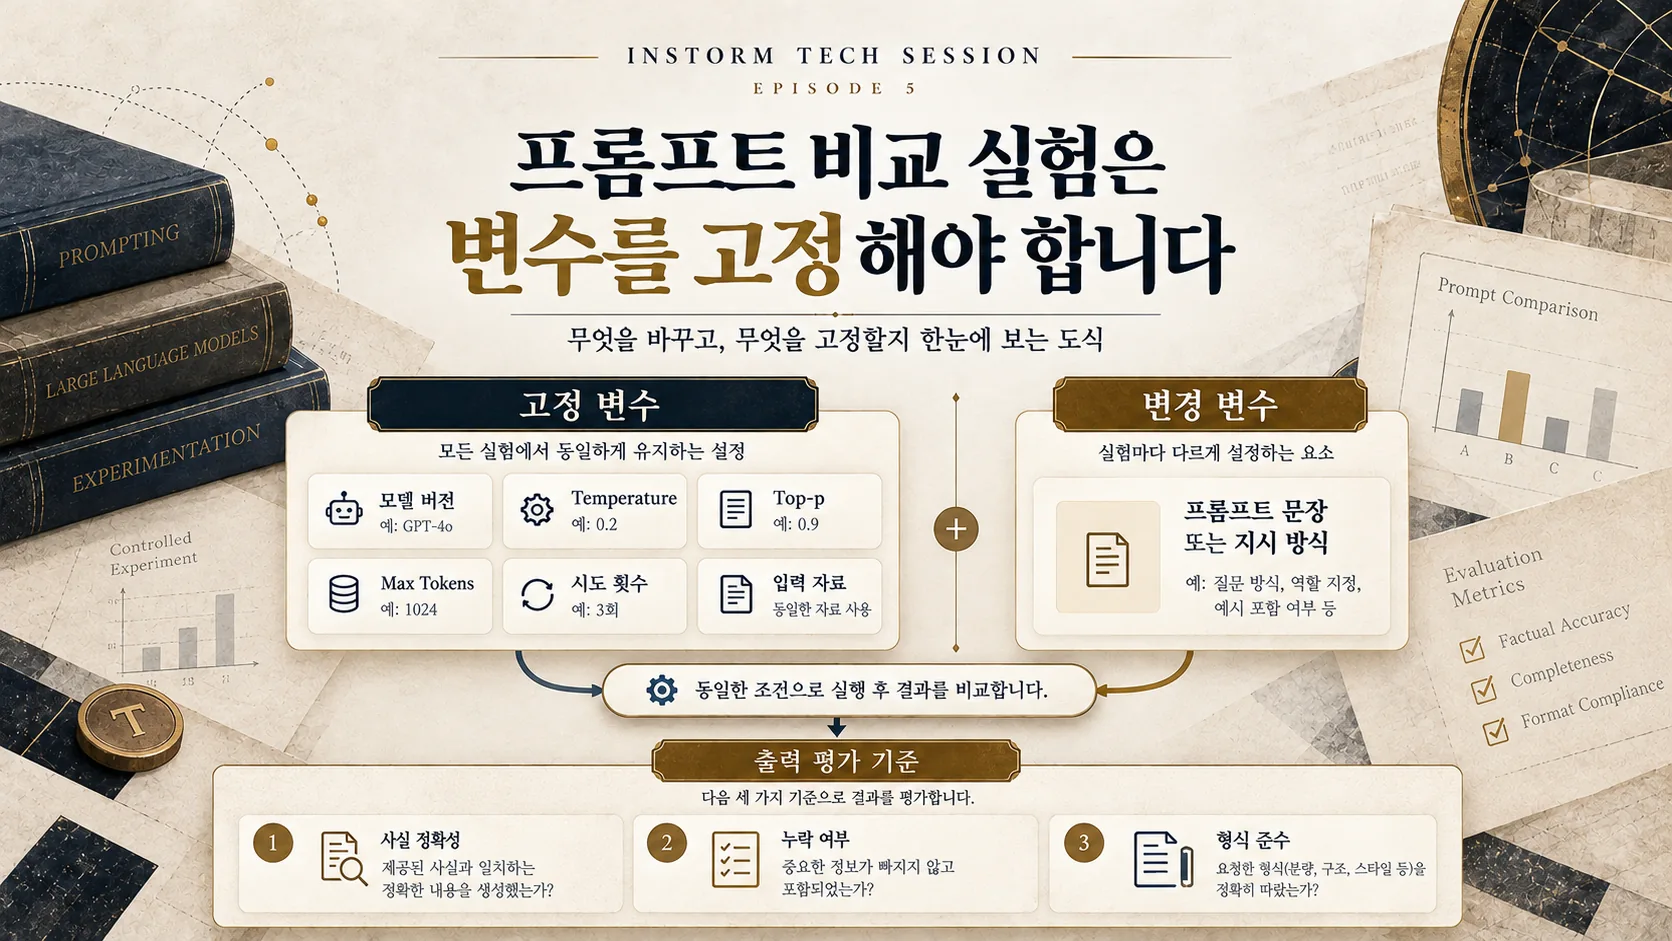
평가는 세 가지를 나눠 보세요. 사실 정확성, 필수 정보 누락 여부, 형식 준수입니다. 자연스러운 문장이 반드시 정확한 문장은 아닙니다.
문맥 조건화는 같은 모델로 여러 표현과 작업을 수행하는 문제를 해결해 주었습니다. 그러나 프롬프트만으로 지식 부족이나 사실성 문제를 모두 해결하는 것은 아닙니다. 같은 단어가 어떤 순서로 들어왔는지도 중요해집니다.
그렇다면 문장 속 위치는 어떻게 표현할까요? 다음 6편에서 Positional Encoding과 RoPE를 살펴보겠습니다.
참고 자료
- Brown et al. (2020), Language Models are Few-Shot Learners — GPT-3·Few-shot과 In-context Learning.
- Ouyang et al. (2022), Training Language Models to Follow Instructions with Human Feedback — 사전학습과 지시 수행 학습의 구분.
- Lu et al. (2022), Fantastically Ordered Prompts and Where to Find Them — 예시 순서 민감도 및 평균 13% 상대 개선.
- Wallace et al. (2024), The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions — 권한별 지시 충돌과 Prompt Injection 방어.
- Qin et al. (2026), Evaluating and Explaining Prompt Sensitivity of LLMs Using Interactions — IPS·50개 모델 분석.