RESEARCH / Instorm
TECH SESSION 2편 | AI는 왜 'strawberry'의 r을 세는 것도 어려워할까?
AI가 strawberry의 r을 세는 것이 왜 어려웠을까? 유니코드·BPE·SentencePiece 토큰화와 Byte Latent Transformer 연구를 연결합니다.
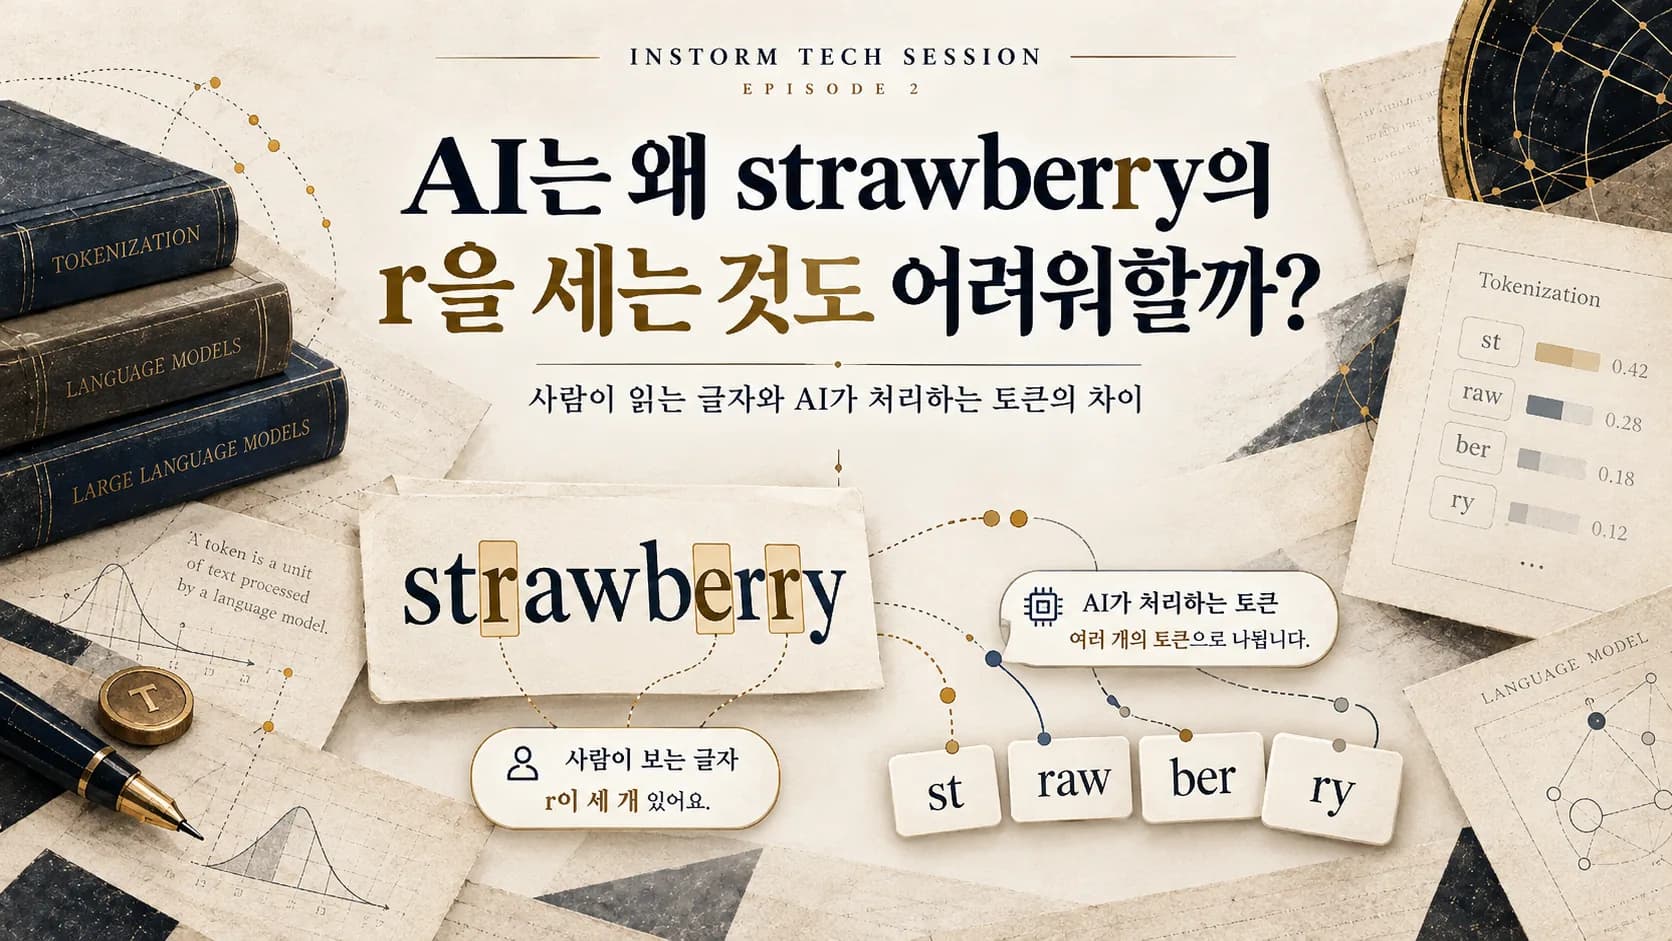
사람은 글자 열 개를 보는데, AI는 왜 몇 개의 숫자 조각으로 읽을까요? 토큰화의 역사와 실제 분할 실험.
딸기에 들어 있는 r은 세 개인데
2024년 무렵 인터넷에는 기묘한 질문이 돌았습니다.
“strawberry 안에 r이 몇 개 있나요?”
눈으로 세어보면 어렵지 않습니다. s · t · r · a · w · b · e · r · r · y. 세 개입니다.
그런데 당시 일부 대화형 언어모델은 이 간단한 문제에 틀린 답을 내놓았습니다. 복잡한 코드를 작성하는 AI가 영어 철자 하나를 세는 데 실수하자 많은 사람이 놀랐습니다.
그렇다고 지금 모든 AI가 이 문제를 틀린다는 뜻은 아닙니다. 새로운 모델은 더 잘 풀 수 있고, 필요하면 코드를 실행해 정확하게 셀 수도 있습니다. 우리가 궁금해해야 할 것은 'AI가 바보인가'가 아니라 왜 이 일이 언어모델에는 생각보다 별개의 기술적 과제인가입니다.
힌트는 키보드가 아니라 모델이 입력을 받는 방식에 있습니다.
컴퓨터가 말하는 '글자 하나'는 무엇일까요?
우리가 보는 '가'라는 글자 하나는 컴퓨터 안에서 Unicode(유니코드) 코드 포인트 U+AC00으로 표현할 수 있습니다. 이를 UTF-8로 저장하면 세 바이트입니다. 영어 a는 같은 방식에서 한 바이트입니다.
하지만 바이트(Byte)와 글자(Character)와 토큰(Token)은 다른 단위입니다. 더 복잡한 이모지는 눈으로 볼 때 하나처럼 보여도 여러 코드 포인트를 조합해 만들 수 있습니다.
언어모델 앞단의 Tokenizer(토크나이저)는 입력 문장을 모델이 사용하는 조각 목록인 Vocabulary(어휘집)에 맞춰 쪼갭니다. 조각 하나에는 Token ID라는 번호가 붙습니다. 번호 123이 124보다 뜻이 크다는 말은 아닙니다. 단지 어휘집의 서로 다른 항목을 가리키는 표지판입니다.
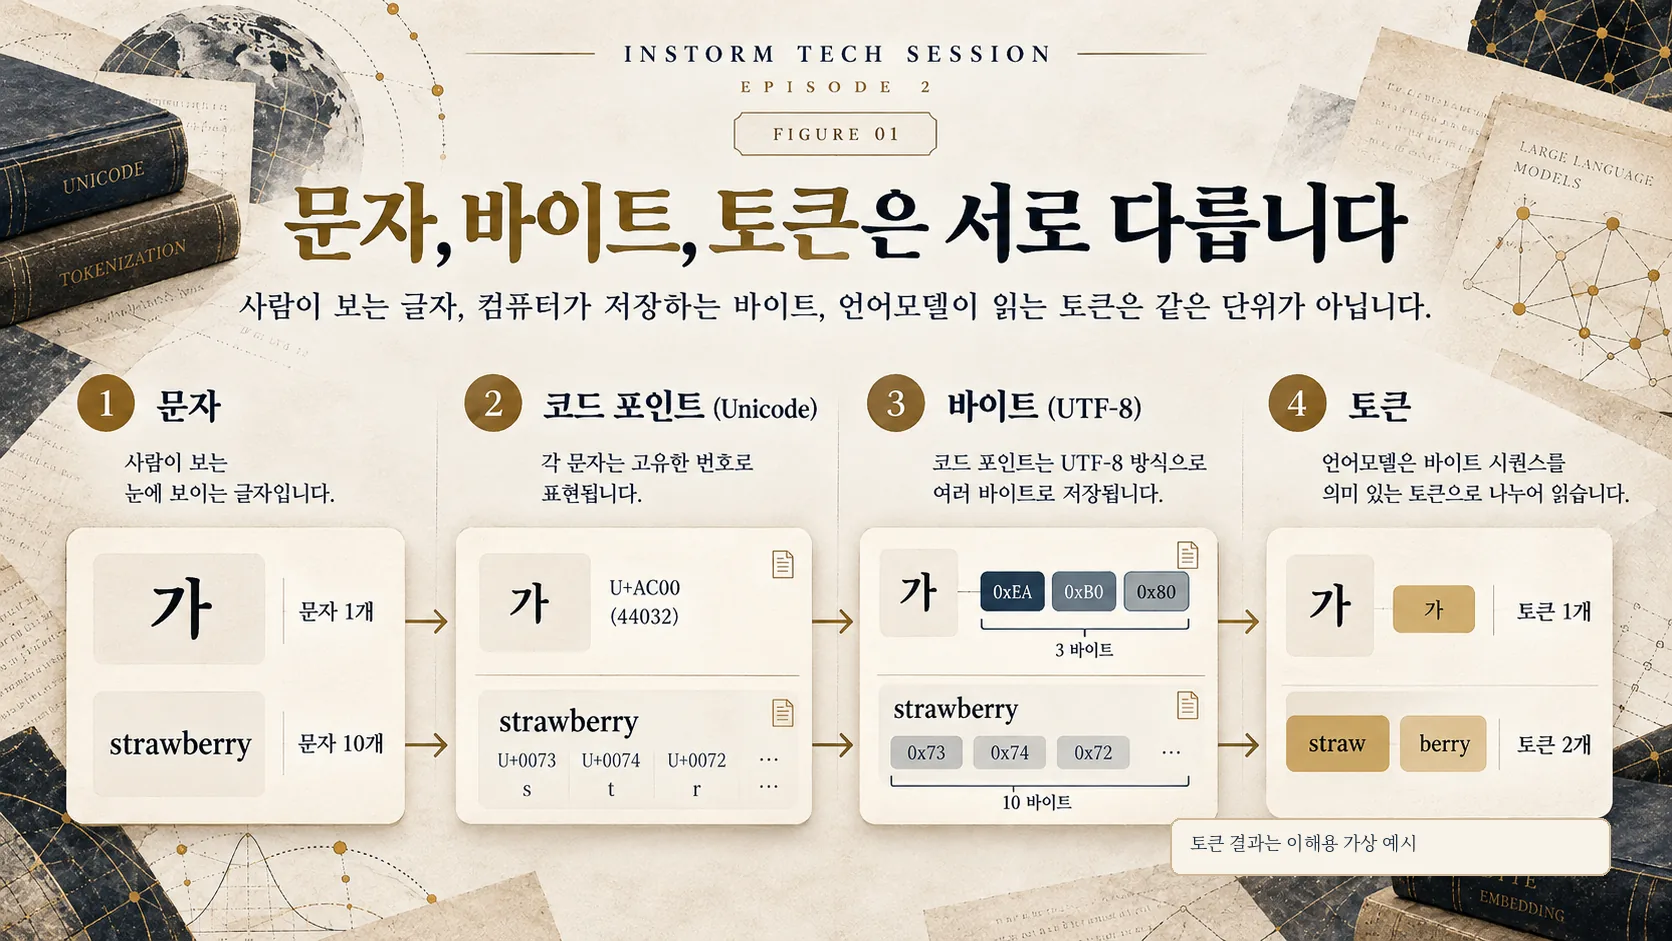
토큰이 'strawberry' 통째로일 수도 있고, 일부 글자 조합일 수도 있습니다. 따라서 사람이 글자를 셀 때 쓰는 구분선과 모델이 예측하도록 학습된 구분선은 반드시 같지 않습니다.
그런데 왜 사람과 같은 글자 단위로 입력하지 않고, 복잡하게 조각을 만들었을까요? 원래 연구자들은 딸기의 철자를 세기 위해 이 방법을 고안한 것이 아니었습니다.
새 단어가 나올 때마다 사전을 만들 수는 없습니다
2016년, Rico Sennrich와 동료들은 Neural Machine Translation of Rare Words with Subword Units라는 논문을 발표했습니다. 당시 신경망 기계번역에는 낯선 고유명사나 처음 보는 합성어를 처리하기 어렵다는 문제가 있었습니다.
예를 들어 사전에는 '도서관'이 있지만 '도서관앞문구점'이라는 새로운 표현은 없을 수 있습니다. 모든 가능한 합성어를 통째로 등록할 수는 없습니다. 그렇다고 처음 보는 단어를 무조건 '알 수 없음'으로 바꾸면 번역이 막힙니다.
연구진은 단어를 Subword(서브워드)라는 작은 조각으로 표현했습니다. 핵심은 “한 단어를 몰라도 그 안의 익숙한 조각들을 조합할 수 있지 않을까?”라는 생각이었습니다.
그 연구는 오래전부터 존재하던 압축 아이디어인 Byte Pair Encoding(BPE)을 단어 분할에 적용했습니다. 여기서 역사적 구분이 중요합니다. BPE 알고리즘을 2016년에 처음 발명한 것이 아니라, 언어 처리의 서브워드 학습에 적용한 것입니다. 2026년 ACL이 이 논문을 Test of Time Award 수상작으로 선정한 이유도 이 간단한 접근이 이후 번역을 넘어 언어모델 토큰화의 기반으로 자리 잡았기 때문입니다.
논문의 WMT 2015 영어→독일어 및 영어→러시아어 번역 비교에서는 실험 조건에 따라 사전 대체(back-off dictionary) 기준선보다 각각 최대 1.1 BLEU, 1.3 BLEU 개선을 보고했습니다. BLEU는 기계번역을 참조 번역과 비교하는 지표입니다. 그 숫자가 지금의 모든 LLM 토크나이저 성능을 보장하는 것은 아닙니다. 이 연구가 해결하려던 원래 문제는 희귀·미등록 단어를 다루는 방법이었습니다.
BPE는 어떻게 조각을 만드는가
BPE가 'banana'라는 문자열을 처리하는 가상 과정을 한 번 살펴보겠습니다.
처음에는 b | a | n | a | n | a처럼 시작할 수 있습니다. 이제 학습 데이터 전체에서 서로 이웃한 기호 쌍의 빈도를 셉니다. 가장 자주 나오는 쌍을 합쳐 새로운 기호로 만듭니다. 설명을 위해 a + n → an이 먼저 선택됐다고 합시다.
그러면 b | an | an | a처럼 표현할 수 있습니다. 이 병합을 반복하면 자주 등장하는 문자열은 더 큰 조각이 되고, 희귀한 문자열은 작은 조각의 조합으로 남습니다. 실제 BPE에서는 데이터 전체의 출현 빈도와 이미 학습된 병합 순서가 결정적입니다. 위 과정은 한 단어에서 원리를 보여주는 교육용 개념 예시이지, 특정 서비스 토크나이저의 결과가 아닙니다.
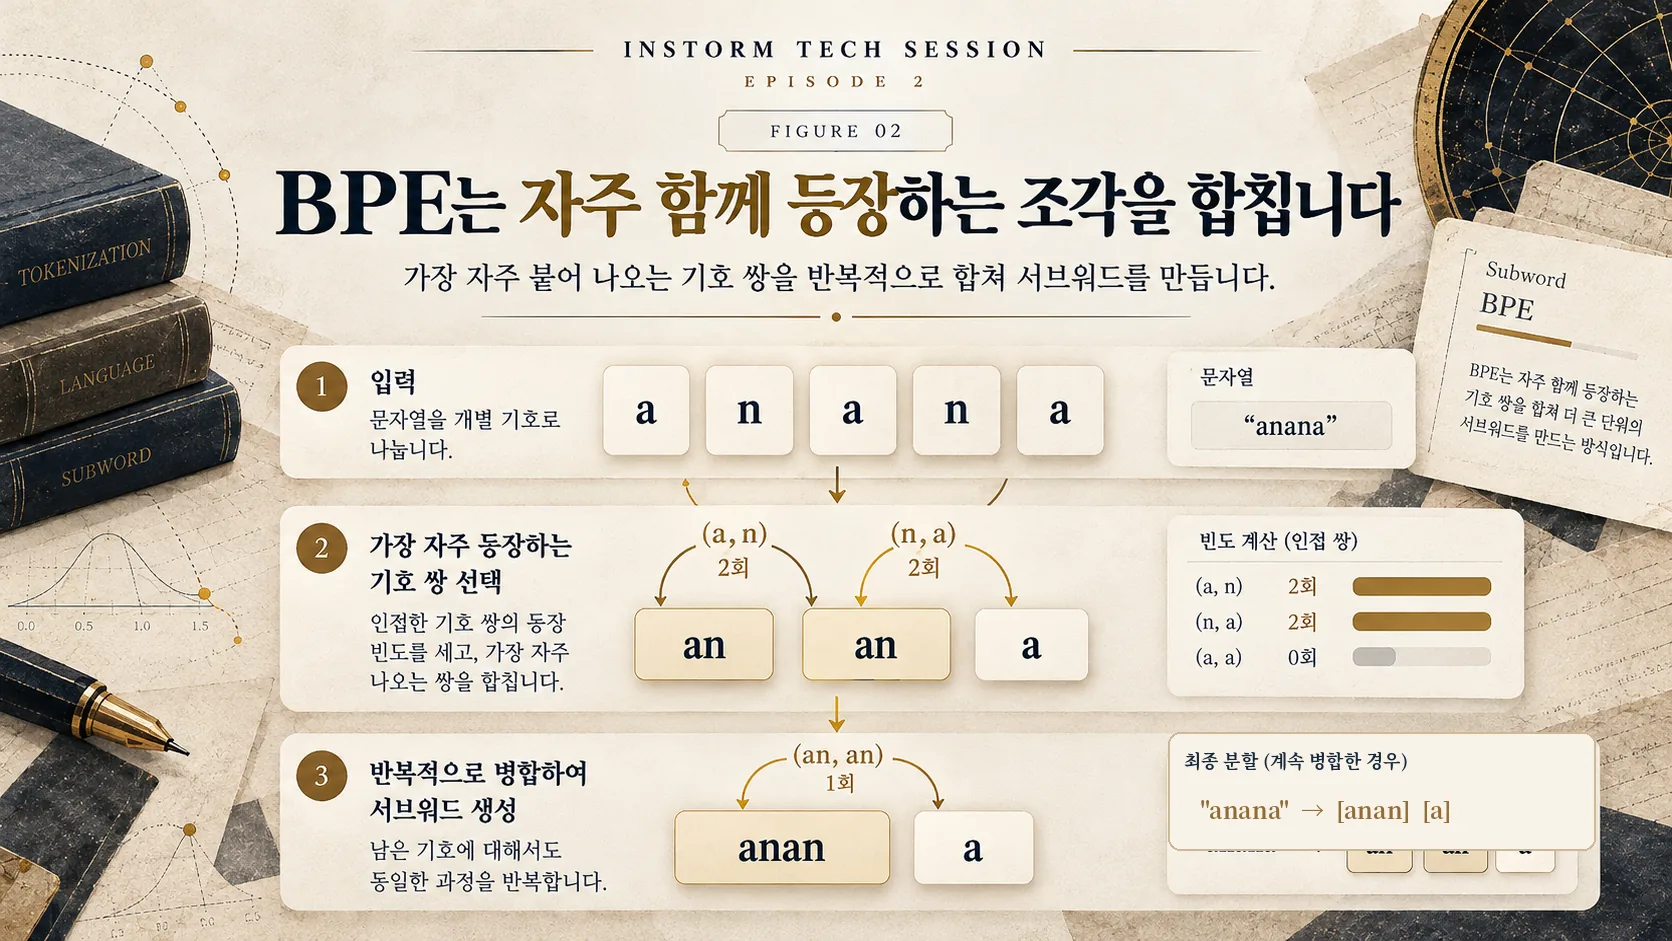
이 방식으로 얻는 것은 조각 목록과 병합 규칙입니다. 모델은 그 결과 토큰 ID를 받아 Embedding(임베딩)이라는 연속적인 숫자 벡터로 바꾸어 계산합니다. '딸기'와 '달기'라는 말이 의미가 비슷하다고 단순히 번호가 가깝게 지정되는 것은 아닙니다. 유사한 용법은 이후 학습 과정에서 벡터와 모델 파라미터에 반영될 수 있습니다.
그러면 모든 토크나이저가 같은 strawberry를 똑같이 자를까요? 이번에는 실제로 프로그램을 실행해봤습니다.
같은 단어를 두 토크나이저에 넣어봤습니다
여기서는 SentencePiece 0.2.1을 사용해 서로 다른 장난감 학습 말뭉치에서 BPE 토크나이저 두 개를 직접 훈련했습니다. 대형 상용 모델의 내부를 재현한 실험이 아닙니다. 분할 경계가 학습 데이터와 어휘집에 따라 바뀐다는 원리만 확인하려는 작은 실험입니다.
첫 번째 모델은 'strawberry'가 매우 자주 등장하는 소규모 문장 모음으로 학습했고 어휘집 크기를 80으로 설정했습니다. 두 번째 모델은 'straw', 'berry', 다른 과일 표현이 더 많이 등장하도록 만든 소규모 문장 모음으로 학습했고 어휘집 크기를 55로 설정했습니다.
| 입력 문자열 | 실습 BPE 모델 A | 실습 BPE 모델 B |
|---|---|---|
| strawberry | ▁strawberry (1토큰) |
▁s / t / r / a / w / berry (6토큰) |
직접 실행한 소규모 실습 결과. ▁ 표시는 SentencePiece의 단어 앞 공백 경계 표기이며, 실제 GPT 계열 모델의 공식 토큰 결과를 주장하는 것이 아닙니다.
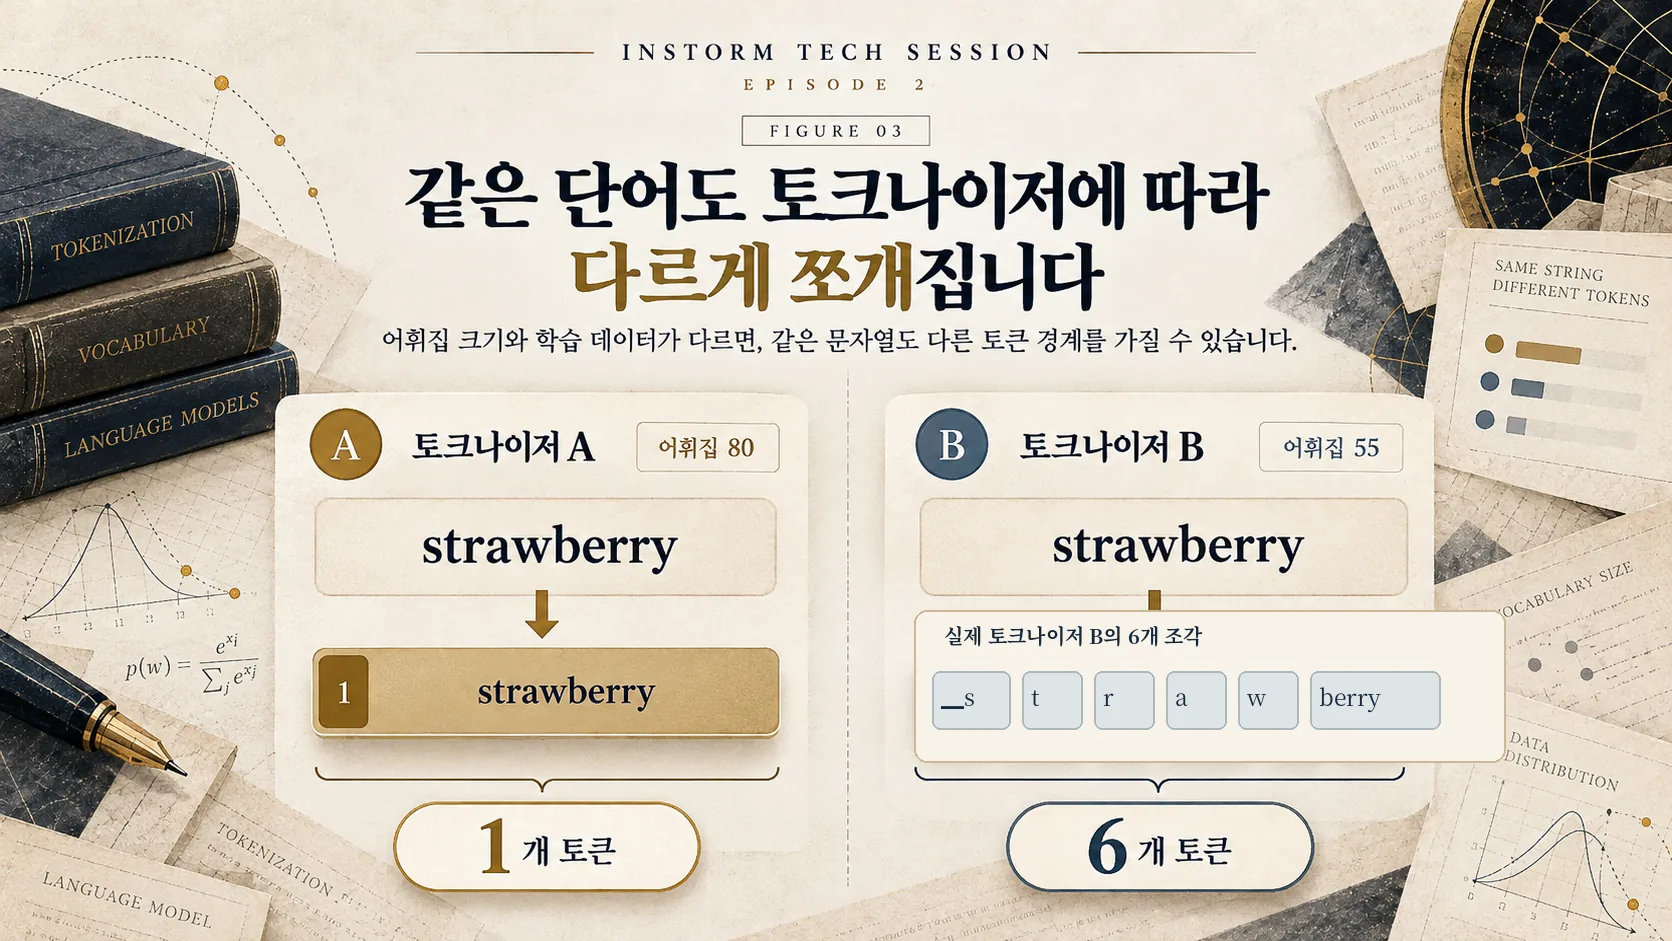
놀랍지 않나요? 똑같은 'strawberry'인데 한 모델에서는 한 덩어리, 다른 모델에서는 여섯 덩어리입니다. 사람이 세는 글자 수는 여전히 열 개입니다. 바뀐 것은 글자가 아니라 모델이 미리 학습한 조각의 경계입니다.
이제 어떤 토크나이저에서 strawberry가 한 토큰이라고 해봅시다. 그러면 다음 토큰을 고르도록 학습된 언어모델은 그 토큰만 보고 글자 안의 r을 별도 항목 세 개로 자동 전달받지 않습니다. 반대로 여섯 조각으로 나뉘었다고 해서 언제나 r 세기를 정확히 한다는 보장도 없습니다. 내부 표현과 문자 조작 능력은 별개의 문제입니다.
한국어가 반드시 더 비싸다는 말은 맞을까요?
토큰이 입력 단위라면 언어별 사용량도 달라집니다. 어떤 토크나이저에서는 같은 뜻을 전하는 한국어 문장이 영어 문장보다 더 많은 토큰으로 나뉠 수 있습니다. 그래서 한국어는 무조건 몇 배 비싸다는 주장도 돌아다닙니다.
그러나 그런 보편 법칙은 없습니다. 학습 말뭉치, 어휘집의 크기, 언어별 빈도, 띄어쓰기 처리에 따라 결과가 달라집니다. 실제로 앞에서 만든 작은 SentencePiece 모델 A는 “오늘 회의는 오후 세 시에 시작합니다.”를 17토큰, “The meeting starts at three this afternoon.”을 32토큰으로 나눴습니다. 반대 방향의 사례가 나온 것입니다.
물론 이 장난감 말뭉치의 값으로 상용 API의 한국어 효율을 주장해서는 안 됩니다. 오히려 정반대의 교훈입니다. 제품의 토큰 비용은 해당 제품이 실제 사용하는 토크나이저와 과금 규칙을 확인해야만 비교할 수 있습니다. 두 문장의 의미가 완전히 같은지도 통제해야 합니다.
2018년 Taku Kudo와 John Richardson의 SentencePiece 연구가 의미 있는 것도 여기에 있습니다. 영어처럼 띄어쓰기 중심으로 미리 단어를 자르는 전처리에만 기대지 않고, 원시 문장에서 직접 BPE나 Unigram 방식의 서브워드 모델을 훈련할 수 있도록 했습니다. 언어마다 다른 분할 전처리를 줄일 수 있는 도구이지, 모든 언어의 토큰 수를 같게 만드는 마법은 아닙니다.
고정 토큰을 버리려는 2025년 연구
연구자들은 이제 한 걸음 더 나아가 묻습니다. “아예 고정된 단어 조각 사전이 꼭 필요할까?”
2025년 ACL에서 발표된 Artidoro Pagnoni와 동료들의 Byte Latent Transformer: Patches Scale Better Than Tokens는 BLT(Byte Latent Transformer)라는 접근을 제시했습니다. 미리 고정한 BPE 어휘집 대신 바이트(Byte)를 입력으로 받고, 다음 바이트에 대한 불확실성인 Entropy(엔트로피)를 이용해 서로 다른 길이의 패치를 만듭니다.
예측하기 쉬운 구간은 큰 덩어리로, 복잡한 구간은 작은 덩어리로 처리하는 방향입니다. 연구진은 최대 80억(8B) 파라미터, 4조(4T) 학습 바이트 규모까지 실험해 고정 어휘집 없는 바이트 모델의 확장 가능성을 보였습니다. 여기서 4T는 토큰이 아니라 바이트입니다. 논문은 정해진 추론 연산 예산에서의 확장성·효율·일부 일반화 개선을 보고했지만, 오늘날의 모든 상용 토크나이저가 불필요해졌다는 뜻은 아닙니다.
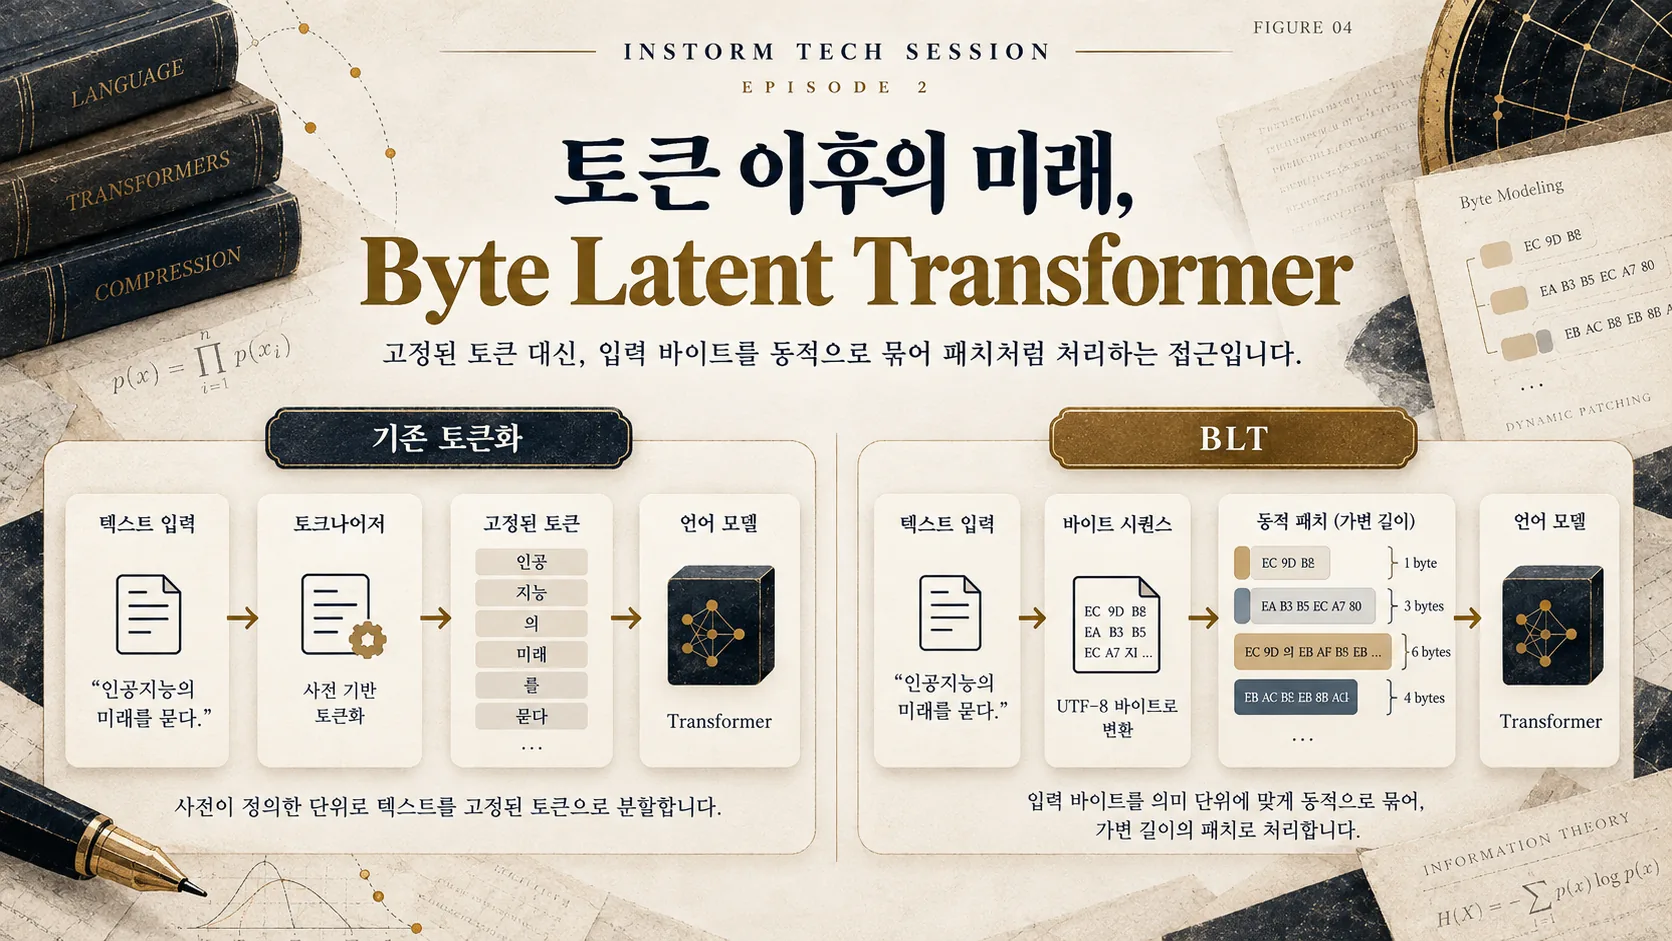
우리가 당연하게 생각했던 'AI가 먼저 문장을 토큰으로 잘라야 한다'는 방식 자체가 연구 대상으로 남아 있다는 점이 중요합니다.
정확한 글자 수가 필요할 때
자, 다시 물어보겠습니다. “strawberry에 r이 몇 개 있나요?” 답은 세 개입니다.
대부분의 언어모델은 언어의 패턴을 예측하도록 학습됐고, 정확한 문자 카운터가 되도록 설계된 것은 아닙니다. 하지만 문자 단위 분해와 코드 실행, 검증 도구를 결합하면 이 문제를 안정적으로 처리할 수 있습니다. 구조화된 추출과 계산이 필요한 작업이라면 언어모델의 자연스러운 문장을 그대로 계산 결과로 받아들이지 않는 것이 좋습니다.
토큰화가 해결한 문제는 처음 보는 단어를 제한된 어휘집으로 처리할 수 있게 한 것이고, 아직 남은 문제는 토큰의 경계가 인간이 요구하는 문자·숫자 연산과 항상 일치하지 않는다는 점입니다.
그런데 여기서 새로운 의문이 생깁니다. AI가 결국 쪼개진 조각과 숫자만 받는다면, 어떻게 그 숫자로 역사와 과학을 설명할 수 있을까요? 3편에서 기계 안쪽으로 조금 더 들어가 보겠습니다.
참고 자료
- Sennrich, Haddow & Birch (2016), Neural Machine Translation of Rare Words with Subword Units. https://aclanthology.org/P16-1162/ — 희귀어·미등록어, BPE 적용, WMT 2015 번역 성능.
- Kudo & Richardson (2018), SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing. https://aclanthology.org/D18-2012/ — 원시 문장 학습과 BPE/Unigram 구현.
- Pagnoni et al. (2025), Byte Latent Transformer: Patches Scale Better Than Tokens. https://aclanthology.org/2025.acl-long.453/ — 가변 길이 바이트 패치, 8B·4T 바이트 실험.
- Brown et al. (2020), Language Models are Few-Shot Learners. https://arxiv.org/abs/2005.14165 — 토큰 기반 언어모델 배경.