RESEARCH / Instorm
TECH SESSION 3편 | 다음 단어만 맞히던 AI는 어떻게 지식을 갖게 되었을까?
언어모델이 다음 토큰을 예측하며 지식을 형성하는 원리. 임베딩, Cross-Entropy, Backpropagation, Scaling Laws와 Chinchilla 논문까지 설명합니다.
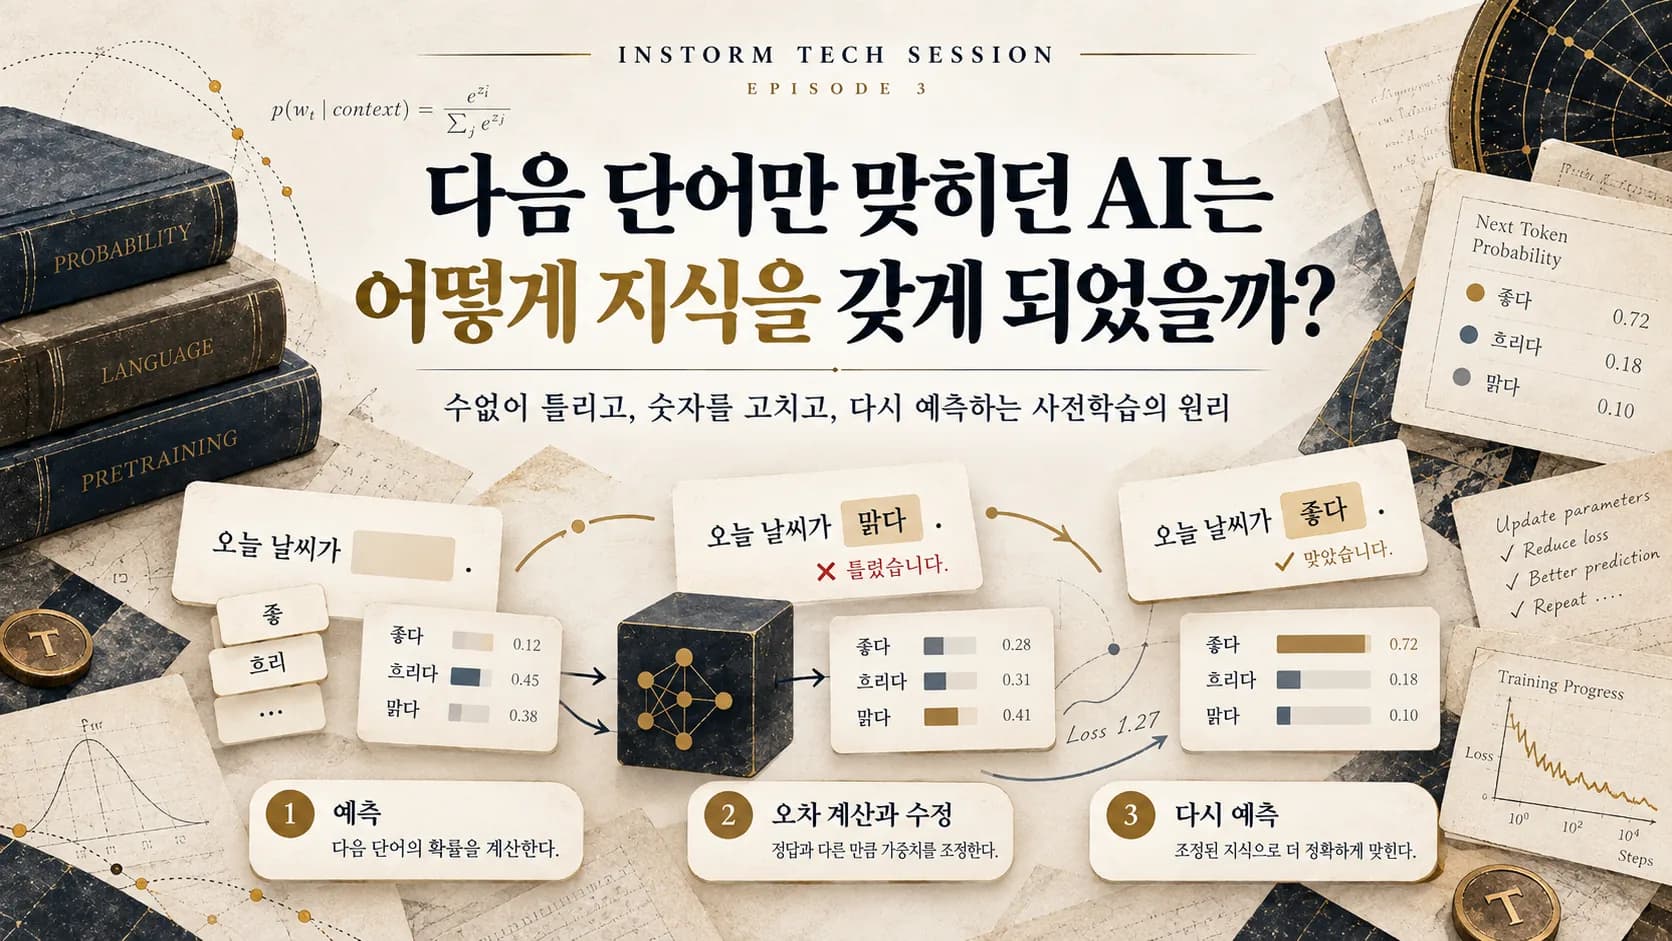
'하늘은 ___'이라는 빈칸에서 출발해 역전파, 학습률, Chinchilla의 계산 예산까지. 숫자 하나가 변하는 순간을 따라갑니다.
처음에는 빈칸을 틀리는 학생이었습니다
선생님이 학생에게 묻습니다.
“하늘은 ___.”
학생은 “맛있다”라고 답합니다. 옳지 않은 문장일 수도 있겠지만, 적어도 선생님이 보여주려던 원래 문장은 아니었습니다.
선생님은 이번에는 “하늘은 맑다”라는 실제 문장을 보여줍니다. 그리고 다시 묻습니다. “다음에 어떤 말이 나올까?”
이 장면을 몇 조 개의 토큰 위치로 늘려보면 현대 언어모델의 Pretraining(사전학습)을 이해할 실마리가 생깁니다. 특히 많은 자기회귀 언어모델은 Next-token Prediction(다음 토큰 예측)을 목표로 학습합니다.
그러나 실제 컴퓨터에 선생님이 앉아 있지는 않습니다. 정답은 원래 학습 문장에 이미 들어 있습니다. “하늘은 맑다”라는 데이터를 주면 입력 앞부분과 바로 다음에 등장한 토큰을 비교할 수 있습니다. 이렇게 원자료에서 학습용 정답을 얻는 방법을 Self-supervised Learning(자기지도학습)이라고 합니다.
이상한 점은 그다음입니다. AI에게 역사 강의를 따로 하지 않았는데 역사 문제를 풀기도 하고, 프로그래밍 교재를 순서대로 가르치지 않았는데 코드를 작성하기도 합니다. '다음에 나올 토큰'이라는 목표가 어떻게 언어와 세상에 관한 지식까지 만들었을까요?
단어의 관계를 숫자로 표현한 연구
오래된 언어모델은 앞의 몇 단어가 나왔을 때 다음 단어가 얼마나 자주 등장했는지 세는 N-gram 같은 통계적 방법을 썼습니다. 하지만 모든 표현의 조합을 외울 수는 없었습니다. 처음 보는 문장에도 대응해야 하니까요.
2003년 Yoshua Bengio와 동료들은 A Neural Probabilistic Language Model에서 단어의 Distributed Representation(분산 표현)과 문장 확률을 신경망으로 함께 학습하는 방법을 연구했습니다. 비슷한 역할을 하는 단어들이 숫자 공간에서도 관계를 갖게 만드는 방식입니다. 단어를 숫자로 표현하는 모든 아이디어가 그해 처음 탄생했다는 뜻은 아닙니다. 이 연구의 중요성은 분산 표현과 확률적 다음 단어 예측을 함께 학습하는 구조에 있습니다.
요즘 언어모델에서는 먼저 토큰 ID를 Embedding(임베딩) 벡터로 바꿉니다. '고양이'에 102번, '강아지'에 103번이 붙었다고 두 단어가 비슷하다는 뜻은 아닙니다. ID는 사전의 색인이고, 임베딩은 모델이 계산하는 숫자 표현입니다.
비슷한 문맥에서 등장하는 표현 사이의 관계는 학습을 통해 반영될 수 있습니다. 그렇다고 임베딩의 특정 좌표 하나가 '귀여움'을 담당하는 것도 아닙니다. 언어와 지식의 패턴은 여러 차원의 표현과 모델 가중치에 분산될 수 있습니다.
예측 점수는 어디서 만들어질까요?
이번에는 “하늘은”이라는 입력 하나가 모델 안으로 들어가는 과정을 따라가 봅시다.
문자열이 토크나이저를 거쳐 Token ID가 됩니다. 각 ID는 Embedding으로 바뀝니다. 그 벡터가 여러 신경망 계층을 통과하는 계산을 Forward Pass(순전파)라고 부릅니다. 현대 Transformer 계열 모델은 문맥을 반영하기 위해 Attention과 다양한 계층을 사용합니다. 자세한 구조는 4편에서 다루겠습니다.
모델 내부에는 학습 가능한 숫자, Parameter(파라미터)가 있습니다. 파라미터는 수십억 개일 수 있지만, 모든 파라미터가 고양이·서울·미분 같은 지식을 하나씩 맡는 것은 아닙니다. 수많은 숫자가 함께 출력을 만듭니다.
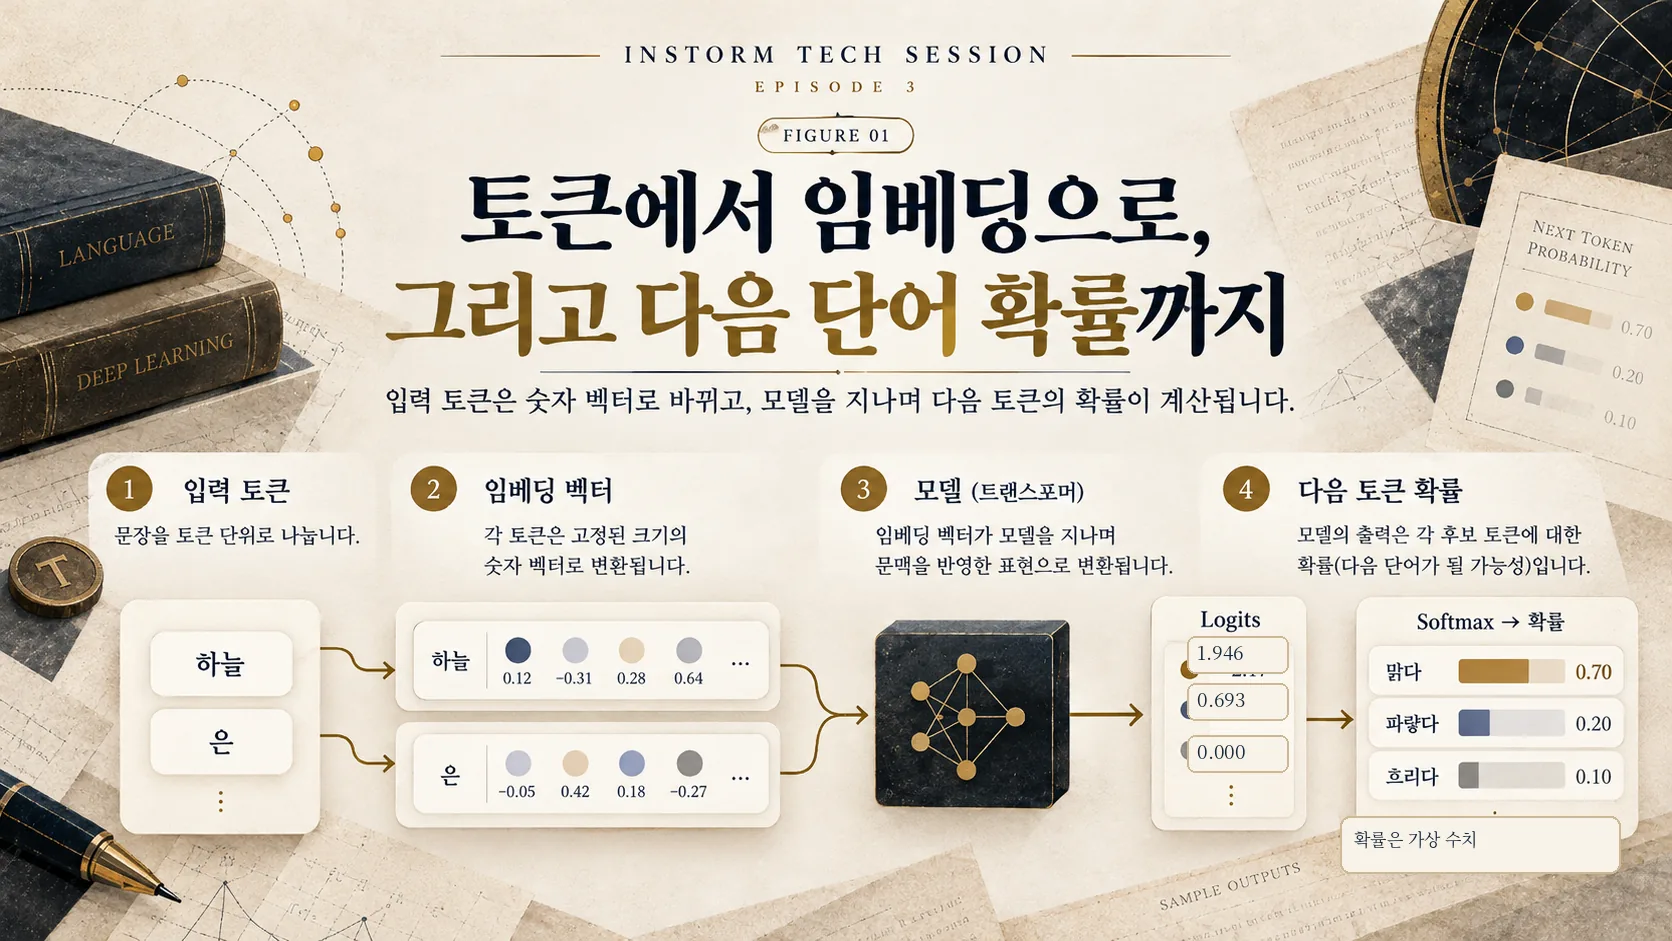
계층을 통과한 계산의 끝에서는 다음 토큰별 Logit(로짓)을 구하고 이를 Softmax로 확률 분포로 바꿉니다. 다음과 같은 예시를 가정해봅시다.
| 후보 표현 | 확률 |
|---|---|
| 파랗다 | 45% |
| 흐리다 | 45% |
| 맑다 | 10% |
이 표는 세 단어가 각각 하나의 토큰이라고 단순화한 가상의 학습 예시입니다.
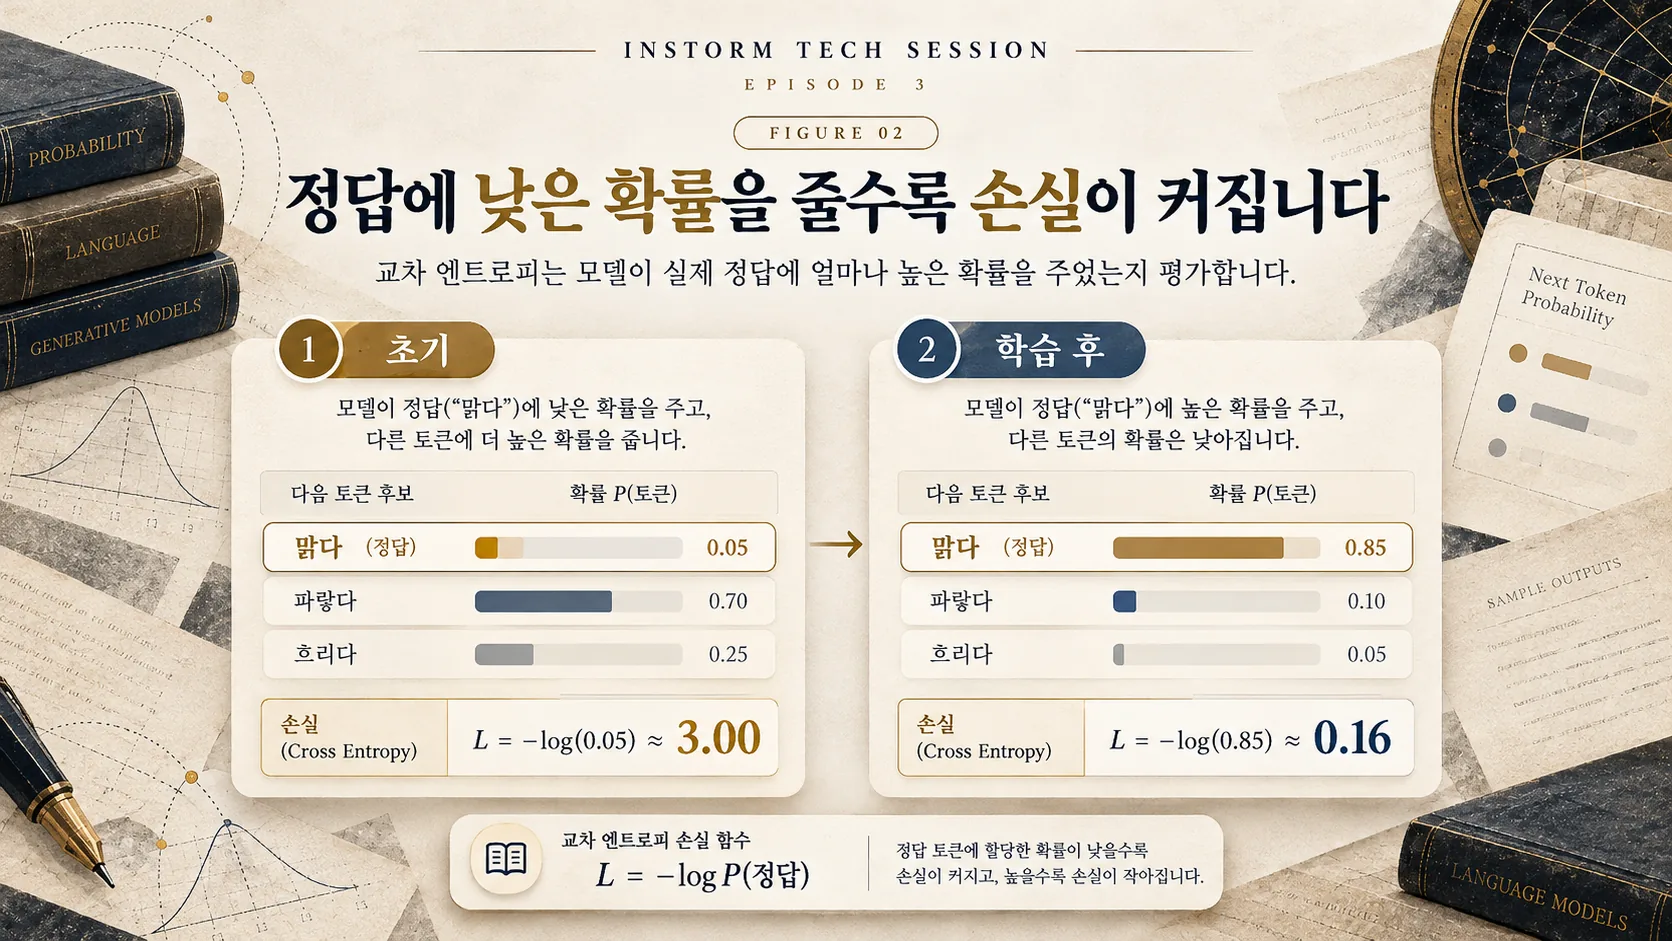
원래 학습 문장이 “하늘은 맑다”였다면 이번 위치의 정답에 해당하는 표현은 ‘맑다’입니다. '파랗다'가 무조건 거짓이라는 뜻은 아닙니다. 지금 주어진 학습 데이터에서 실제 다음에 등장한 표현이 맑다는 뜻입니다.
그런데 모델은 그 표현에 겨우 10%를 주었습니다. 이 차이를 학습 신호로 바꾸는 과정이 필요합니다.
손실은 AI에게 얼마나 틀렸는지 알려줍니다
맞혔다면 100점, 틀렸다면 0점으로 처리하면 충분할까요? 모델은 확률을 출력하므로 훨씬 정교한 피드백을 줄 수 있습니다. 실제로 등장한 토큰에 낮은 확률을 주면 더 큰 벌점을 매기는 것입니다.
이때 널리 쓰이는 것이 Cross-Entropy Loss(교차 엔트로피 손실)입니다. 정답 토큰의 확률이 10%라면 손실은 약 2.303, 50%면 약 0.693, 90%면 약 0.105입니다. 수식으로는 손실 = -ln(정답 토큰의 확률)입니다.
가장 중요한 것은 수식의 모양이 아니라 방향입니다. 정답에 더 높은 확률을 줄수록 손실이 낮아집니다. 실제 학습에서는 여러 문장과 토큰 위치의 손실을 모아 업데이트 신호를 만듭니다.
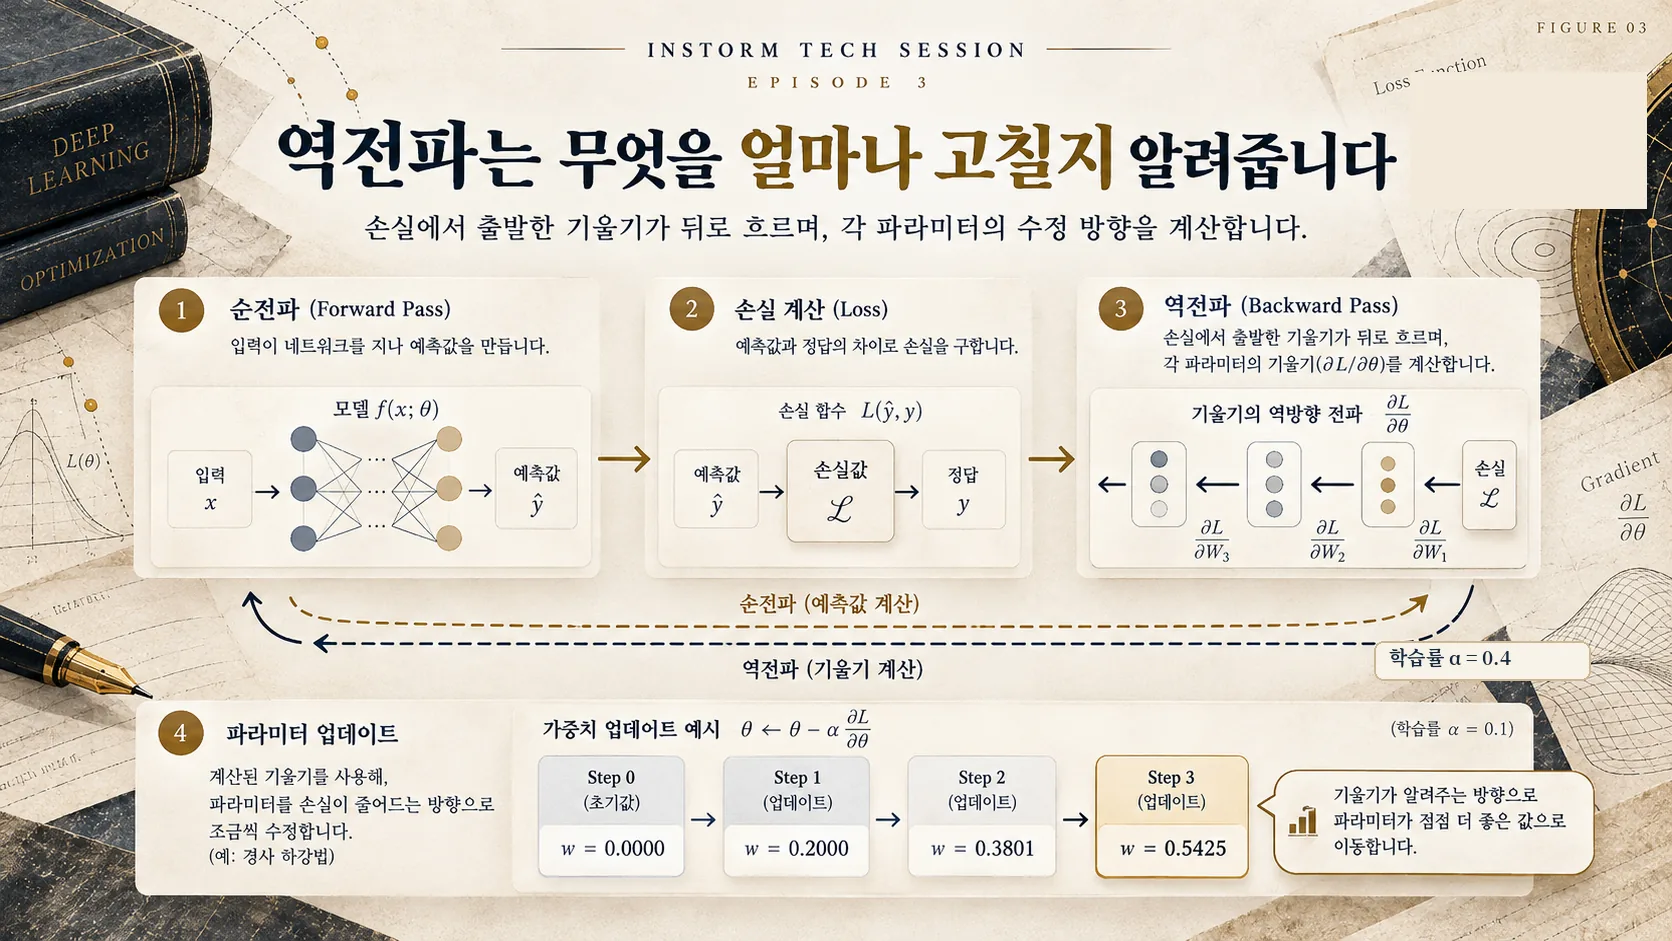
하지만 벌점을 계산했다고 숫자가 자동으로 고쳐지지는 않습니다. 수십억 개 파라미터 가운데 어떤 것을 얼마나 바꿀지 알아야 합니다. 이를 위해 Backpropagation(역전파)으로 손실의 Gradient(기울기)를 계산하고, Gradient Descent(경사하강법)와 같은 원리를 따르는 최적화 알고리즘으로 가중치를 수정합니다.
말로만 들으면 어렵습니다. 그러니 이번에는 파라미터를 단 하나만 가진 아주 작은 모델을 실제 계산해보겠습니다.
다이얼을 0.2만큼 돌렸더니 확률이 바뀌었습니다
이 작은 실습에서 AI가 고를 수 있는 것은 두 종류뿐입니다. ‘맑다’와 ‘그 밖의 표현’. 정답은 '맑다'이고, 하나의 가중치 w가 그 확률을 조절합니다. 입력 x=1, 로짓 z=w×x, 정답 확률 p=1/(1+e^-z)로 둡니다. 이는 거대한 Transformer가 아니라 역전파 방향을 이해하기 위한 장난감 이진 분류 모델입니다.
처음에는 w=0으로 두겠습니다. 그러면 정답 확률은 50%, 손실은 약 0.693입니다. 기울기를 계산하면 p-1=-0.5입니다. 학습률(Learning Rate)을 0.4로 설정했으므로, 가중치는 새 w = 기존 w - 0.4×기울기에 따라 0.2가 됩니다.
이제 같은 입력을 다시 계산하면 정답 확률은 54.98%, 손실은 약 0.598로 변합니다. 숫자를 고쳤더니 모델이 실제로 다른 확률을 출력합니다.
| 계산 시점 | 가중치 w | 정답 확률 | 손실 |
|---|---|---|---|
| 처음 | 0.0000 | 50.00% | 0.6931 |
| 1회 업데이트 후 | 0.2000 | 54.98% | 0.5981 |
| 2회 업데이트 후 | 0.3801 | 59.39% | 0.5211 |
| 3회 업데이트 후 | 0.5425 | 63.24% | 0.4582 |
직접 계산한 교육용 예시. 학습률 0.4의 이진 로지스틱 모델이며 실제 LLM 학습 로그가 아닙니다. 소수점은 반올림했습니다.
여기서 벌어진 일을 다시 생각해 보세요. 어떤 사람이 AI에게 “'맑다'를 더 좋아하도록 다이얼을 오른쪽으로 0.2 돌려라”라고 알려주지 않았습니다. 손실의 변화율, 즉 기울기가 그 방향을 알려준 것입니다.
실제 신경망에서는 이와 같은 원리를 수많은 계층에 걸쳐 적용합니다. 모델 뒤쪽 출력에서 시작해 각 연산의 미분을 앞쪽으로 전달하는 연쇄법칙(Chain Rule)이 역전파의 핵심입니다. 실무에서는 여러 토큰과 미니배치의 기울기를 합산하고 AdamW 같은 최적화 방법으로 갱신하는 경우가 많습니다.
다만 이 작은 모델에서는 같은 예시를 반복해 손실을 줄였습니다. 실제 AI가 처음 보는 질문도 잘 처리하는지 보려면 학습에 사용하지 않은 Validation Data(검증 데이터)가 필요합니다. 훈련 문장에 대한 손실 감소와 새로운 문제를 해결하는 능력은 같지 않습니다.
문장 예측에서 어떻게 지식이 나올까요?
“대한민국의 수도는 ___.”라는 문장을 올바르게 예측하려면 서울과 대한민국의 관계가 도움이 됩니다. “물은 표준 대기압에서 약 ___℃에서 끓는다”라는 문장에는 물리 지식이, “Python 함수에서 return을 만나면 …”에는 코드의 동작 규칙이 도움이 됩니다.
다음 토큰을 잘 예측하려면 단어가 이어지는 통계뿐 아니라 문장에 반복해서 등장하는 세상의 관계를 표현하는 것이 유리합니다. 학습이 쌓이면 그 관계가 모델의 파라미터에 녹아들 수 있습니다. 그렇다고 사람처럼 '이해했다'는 철학적 결론이 자동으로 따라오는 것은 아닙니다. 학습 데이터의 문장을 그대로 암기하는 경우도 있고, 자연스러운 거짓말을 만드는 경우도 있습니다.
2020년 Brown과 동료들의 GPT-3 논문 Language Models are Few-Shot Learners는 사전학습된 1,750억 파라미터 모델이 입력 프롬프트에 몇 가지 예시를 제시하는 것만으로 다양한 작업을 수행할 수 있음을 보여줬습니다. 이를 Few-shot Learning(소수 예시 학습)이라고 부릅니다. 별도 가중치 갱신 없이 문맥 속 예시를 활용한다는 뜻이지, 모든 문제를 해결했다는 뜻은 아닙니다.
여기서 하나의 발견이 중요해졌습니다. 모델이 언어를 잘 이어 쓰도록 학습하는 것만으로도, 새로운 작업에 활용 가능한 넓은 능력이 형성될 수 있다는 것입니다. 그렇다면 파라미터를 더 많이 만들수록 언제나 답이 좋아질까요?
2,800억보다 700억이 더 좋은 결과를 냈던 이유
2020년 Kaplan과 동료들은 Scaling Laws for Neural Language Models에서 모델 크기, 학습 데이터, 계산량과 손실 사이의 경험적 관계를 분석했습니다. 많이 쓰이는 Scaling Laws(스케일링 법칙)의 한 출발점입니다. 하지만 연구자들에게는 제한된 GPU 예산이라는 현실적인 문제가 있었습니다.
2022년 Hoffmann과 동료들의 Training Compute-Optimal Large Language Models, 이른바 Chinchilla 논문은 질문을 바꿨습니다. “같은 연산 예산이면 파라미터를 더 많이 만들까, 더 많은 데이터를 읽힐까?”
| 비교 대상 | Gopher | Chinchilla |
|---|---|---|
| 파라미터 수 | 2,800억(280B) | 700억(70B) |
| 학습 토큰 수 | 약 3,000억(300B) | 약 1조 4,000억(1.4T) |
| 동일한 규모의 학습 연산 예산 | 비교 기준 | 비교 기준 |
Hoffmann et al. (2022) 논문의 Table 1 및 본문에 근거한 근사값. 토큰 수는 모델 파라미터 수가 아닙니다.
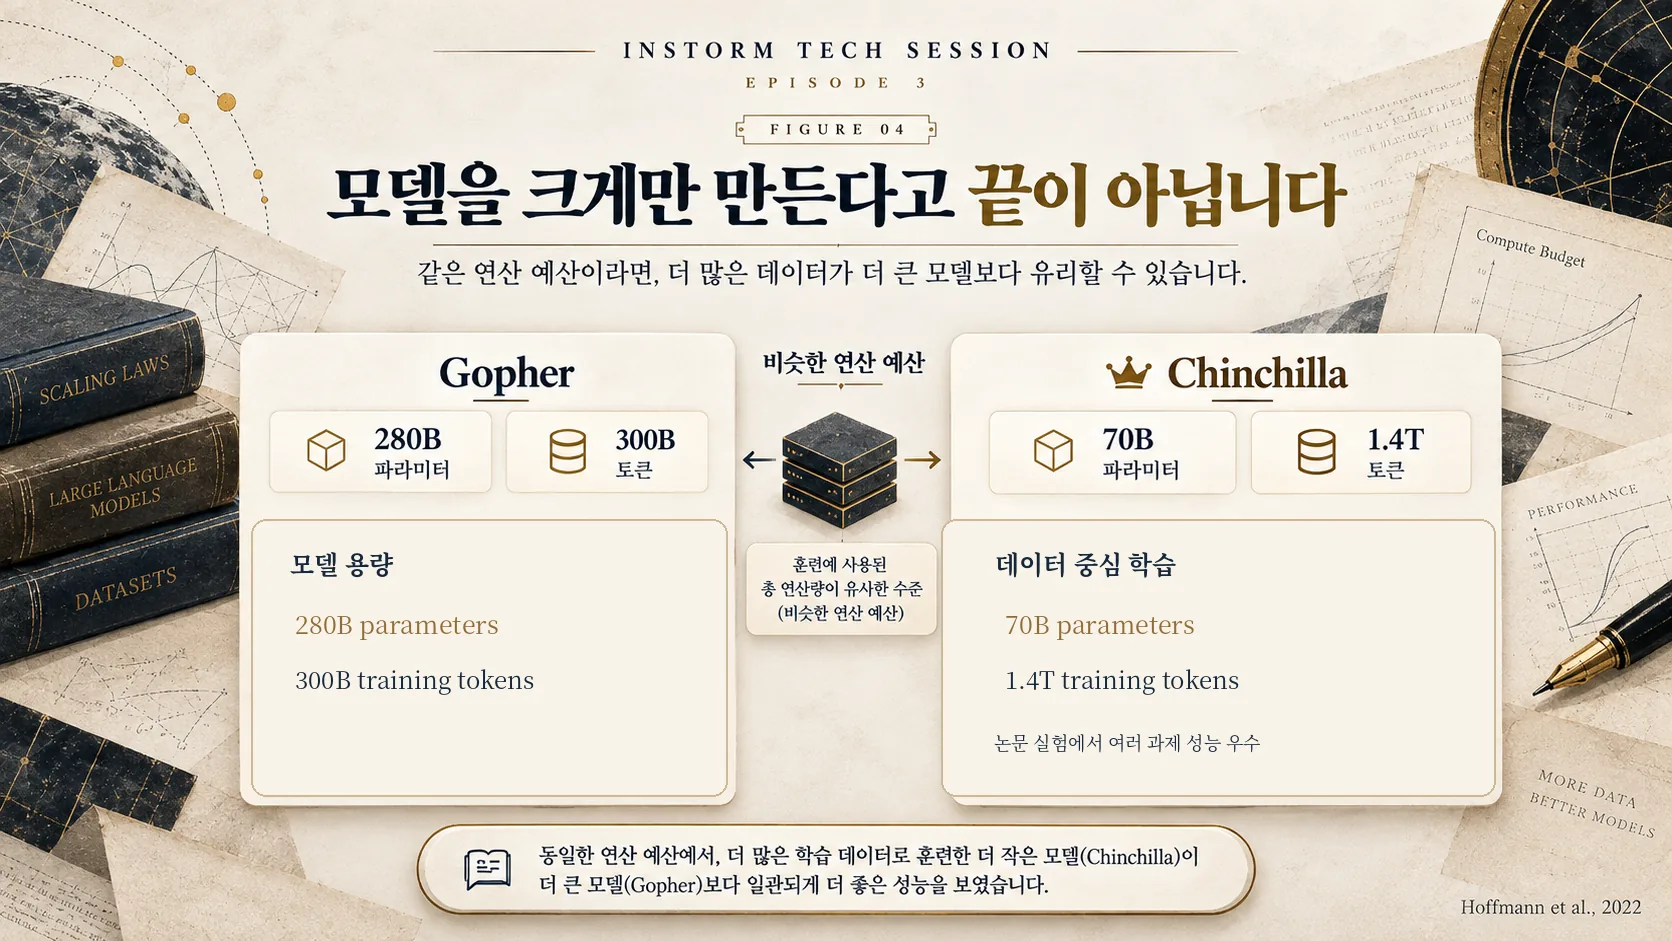
결과는 직관을 뒤집었습니다. Chinchilla는 파라미터가 4배 작았지만 더 많은 데이터를 학습했고, 논문에서 평가한 다수의 작업에서 Gopher보다 좋은 성능을 보였습니다. 예를 들어 논문 초록은 Chinchilla의 MMLU 평균 정확도를 67.5%로 보고합니다. MMLU는 여러 분야의 객관식 지식·추론 문제를 포함하는 벤치마크입니다. 이 값은 특정 평가 설정의 결과이며 실생활 전체 정확도가 아닙니다.
이 연구의 교훈은 작은 모델이 언제나 좋다는 것도, 데이터를 무한정 늘리면 된다는 것도 아닙니다. 같은 연산 예산에서 파라미터 수와 학습 토큰 수를 어떻게 배분할지가 중요하다는 것입니다. 실제 최적점은 하드웨어, 서비스 추론 비용, 데이터 질과 모델 설계에 따라 달라집니다.
2025년 The Common Pile v0.1은 또 다른 질문으로 이어졌습니다. 데이터가 많기만 하면 되는가? 이 연구는 약 8TB의 공개 도메인·개방형 라이선스 텍스트를 모았고, 70억 파라미터의 Comma 모델 두 개를 각각 1조·2조 토큰 학습시켜 비교 가능한 연산 예산에서 경쟁력 있는 성능을 보고했습니다. 데이터의 출처·라이선스·구성이 학습 연구의 중요한 축이 되고 있다는 증거입니다. 이 결과가 저작권 문제나 품질 문제를 모두 해결했다는 뜻은 아닙니다.
책을 많이 읽는 것과 질문에 대답하는 것은 다릅니다
한 학생이 책을 엄청나게 많이 읽었습니다. 그런데 누군가 “초등학생도 알아듣게 블랙홀을 설명해 줘”라고 부탁하자 논문의 어려운 문장만 이어 씁니다. 많이 읽는 능력과 질문자의 의도에 맞춰 답하는 능력은 다릅니다.
언어모델도 마찬가지입니다. 다음 토큰을 잘 예측하도록 사전학습한 것만으로 반드시 사용자의 지시에 알맞게 응답하지는 않습니다. 그래서 Instruction Tuning(지시 미세조정), SFT(지도 미세조정), RLHF(인간 피드백 기반 강화학습) 등이 등장했습니다.
2022년 Ouyang과 동료들의 InstructGPT 연구는 사람이 작성한 답변과 선호 비교를 활용해 모델을 조정했습니다. 논문의 특정 인간 평가 프롬프트 분포에서는 13억(1.3B) 파라미터 InstructGPT의 답변이 1,750억(175B) 파라미터 GPT-3 답변보다 더 선호되는 결과를 보고했습니다. 이 주장은 '작은 모델이 모든 지식·추론 능력에서 큰 모델을 이겼다'는 뜻이 아닙니다. 사용자의 의도에 맞춘 선호 평가와 모든 과제의 정확도는 서로 다른 것입니다.
이제 우리는 출발점으로 돌아왔습니다. “하늘은 ___.” 그 빈칸을 수없이 예측하면서 모델은 숫자를 고쳤고, 언어와 세계에 관한 패턴을 학습할 수 있었습니다. 하지만 정답 확률을 올리는 일은 사실을 보증하지 않고, 지식을 만드는 일은 사용자의 의도를 따르는 일과 같지 않습니다.
그렇다면 다음 편에서는 어떤 문제를 풀어야 할까요? 예측을 할 때 모델은 앞에 나온 수많은 토큰 중 무엇을 참고할까요? 그 질문에서 Attention(어텐션)과 Transformer의 이야기가 시작됩니다.
참고 자료
- Bengio et al. (2003), A Neural Probabilistic Language Model. https://jmlr.org/papers/v3/bengio03a.html — 분산 표현과 확률 언어모델의 공동 학습.
- Vaswani et al. (2017), Attention Is All You Need. https://arxiv.org/abs/1706.03762 — 현대 Transformer 계산 구조 배경.
- Brown et al. (2020), Language Models are Few-Shot Learners. https://arxiv.org/abs/2005.14165 — GPT-3와 few-shot 실험.
- Kaplan et al. (2020), Scaling Laws for Neural Language Models. https://arxiv.org/abs/2001.08361 — 크기·데이터·계산량과 손실의 관계.
- Hoffmann et al. (2022), Training Compute-Optimal Large Language Models. https://arxiv.org/abs/2203.15556 — Chinchilla/Gopher 비교, Table 1, MMLU 결과.
- Ouyang et al. (2022), Training Language Models to Follow Instructions with Human Feedback. https://arxiv.org/abs/2203.02155 — 사전학습과 지시 수행 최적화의 차이.
- Kandpal et al. (NeurIPS 2025), The Common Pile v0.1: An 8TB Dataset of Public Domain and Openly Licensed Text. https://proceedings.nips.cc/paper_files/paper/2025/hash/52acc050138d6f40dad6f12f91a4ce22-Abstract-Datasets_and_Benchmarks_Track.html — 8TB 데이터, Comma 7B 1T/2T 토큰 학습.