RESEARCH / Instorm
TECH SESSION 7편 | AI는 왜 대화가 길어지면 앞의 이야기를 놓칠까?
긴 대화의 처음과 중간에서 AI는 왜 서로 다르게 답할까? Context Window, Truncation, Lost in the Middle 원논문 수치와 질문 배치 실험을 따라갑니다.
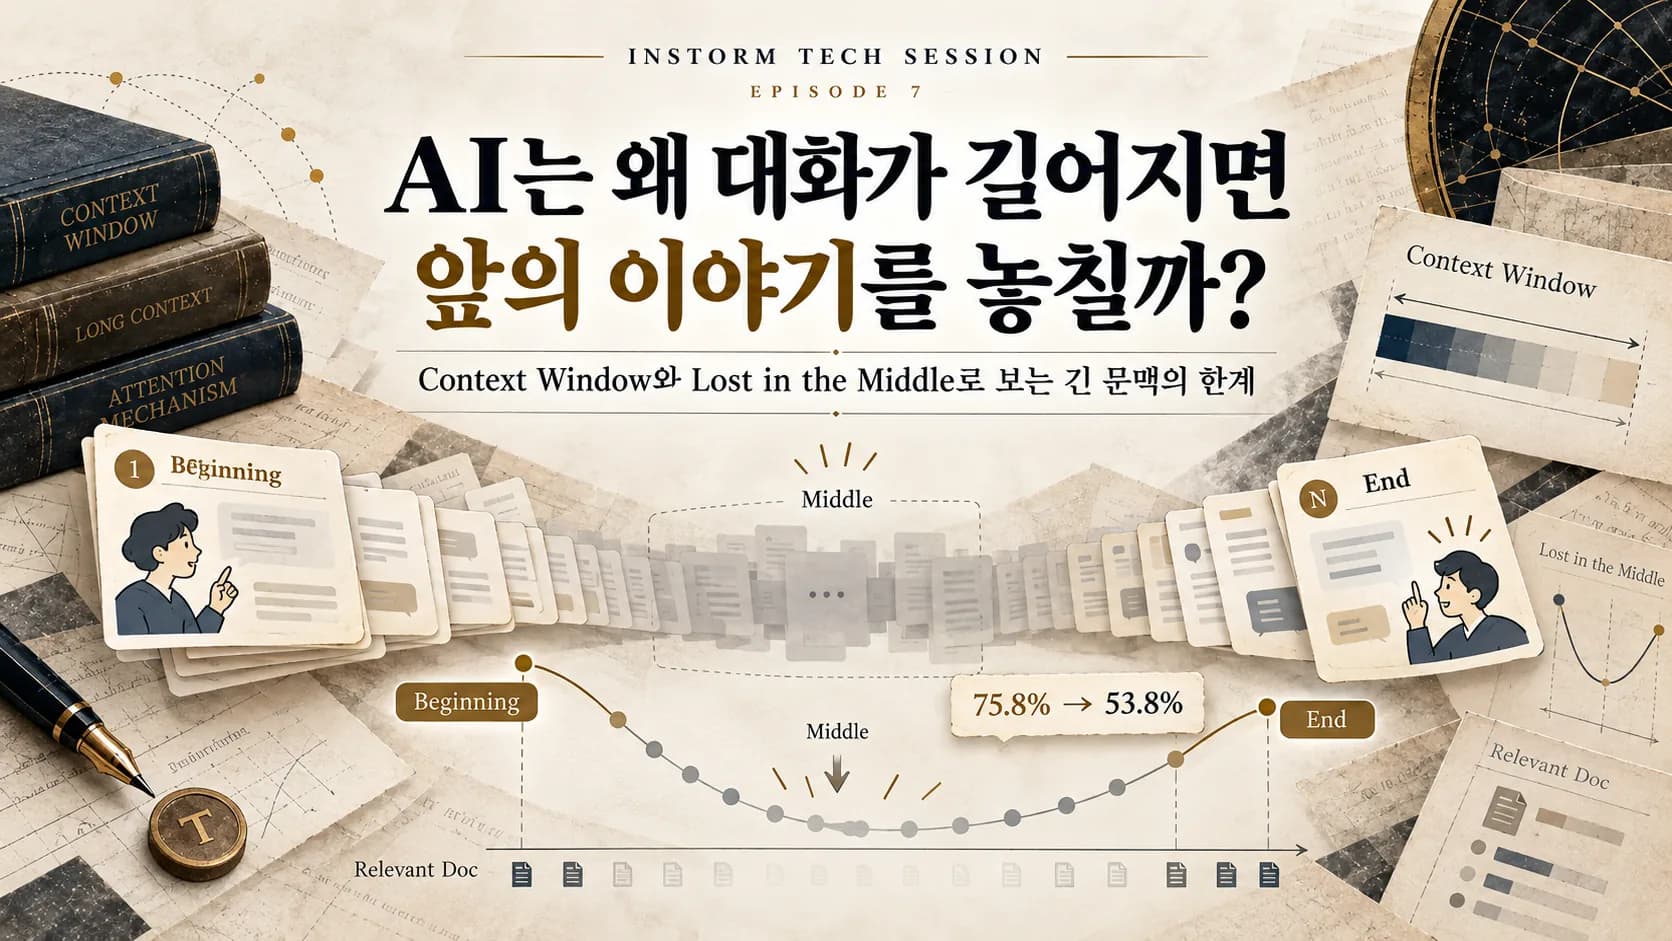
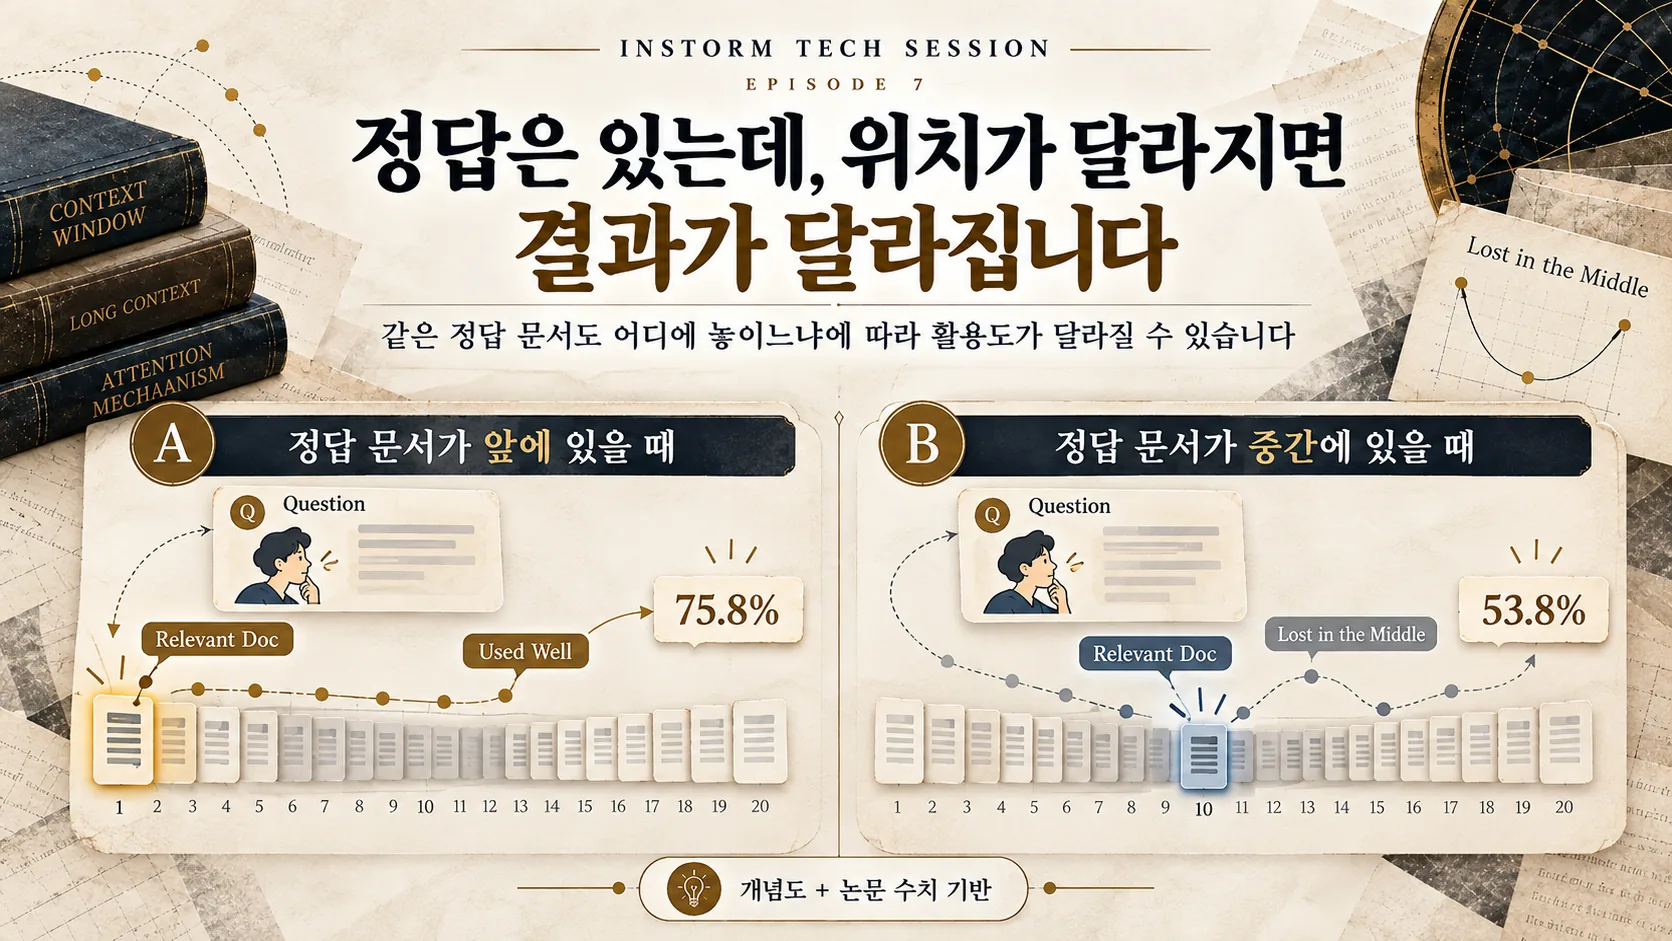
분명히 알려줬습니다. AI도 그 내용을 읽었습니다. 그런데 조금 뒤 다시 물어보니 엉뚱한 답을 합니다. 단순히 오래된 대화가 사라져서 그런 걸까요? 2024년 발표된 연구에서는 정답이 들어 있는 문서의 위치만 바꿨는데 정답률이 75.8%에서 53.8%로 떨어졌습니다. 정답을 입력받는 것과 정답을 찾아 사용하는 것은 다른 문제였습니다.
분명히 말했는데, 왜 처음 듣는 것처럼 대답할까요?
한 회사의 대표가 AI에게 워크숍 준비를 맡겼습니다. “올해 워크숍은 11월 14일, 강릉에서 열릴 예정이야.” AI는 알겠다고 답했습니다. 이후 대화가 길어졌습니다. 숙소를 비교하고, 참석자의 역할을 나누고, 예산표와 회의록까지 붙여 넣었습니다.
한참 뒤 대표가 물었습니다. “그런데 워크숍 날짜가 언제였지?” AI가 엉뚱한 날짜를 말하거나 다시 알려달라고 한다면 어떨까요?
사람에게는 기억력 문제처럼 보입니다. 하지만 AI에서는 먼저 다른 사실을 확인해야 합니다. 처음에 알려준 날짜가 지금 모델이 처리하는 입력에 실제로 남아 있을까요?
지난 6편에서는 Transformer가 토큰의 순서를 어떻게 표현하는지 살펴봤습니다. Positional Encoding과 RoPE는 토큰의 위치 관계를 계산에 반영합니다. 하지만 위치를 표현할 수 있다는 사실과 그 위치의 정보를 정확하게 활용한다는 사실은 다릅니다.
AI의 책상은 무한히 넓지 않습니다
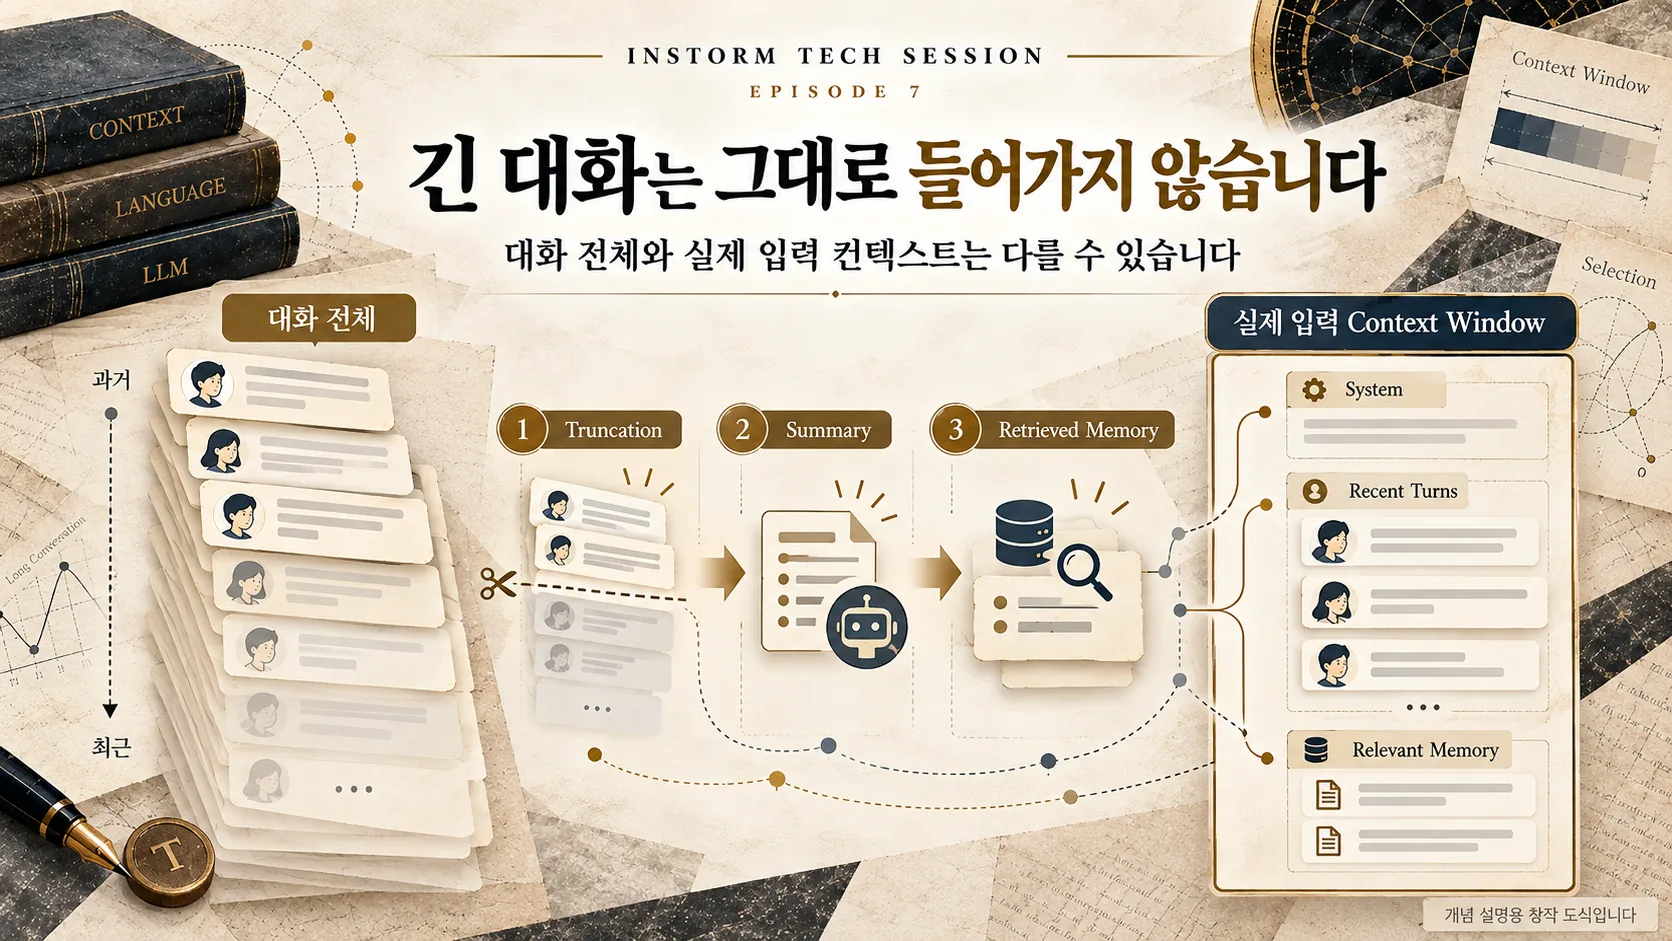
책상 하나를 상상해 보겠습니다. 보고서 열 권을 펼쳐놓았습니다. 그 위의 자료는 볼 수 있지만, 책상 밖의 자료는 다시 가져와야 합니다. 언어모델에도 이와 비슷한 입력의 한계가 있습니다. 한 번의 처리에서 다룰 수 있는 문맥 범위를 Context Window(컨텍스트 윈도우)라고 합니다.
문맥은 화면에 보이는 채팅만 뜻하지 않습니다. 시스템 지시, 이전 대화, 검색 결과와 첨부 문서도 들어갈 수 있습니다. 그 크기는 글자 수가 아니라 Token(토큰) 단위로 다루며, 모델·서비스에 따라 입력·출력 토큰 예산을 관리하는 방법이 다릅니다.
가상의 시스템에서 입력과 출력을 합친 예산이 8,000토큰이라고 해보겠습니다. 기존 입력이 이미 7,500토큰이면 답변에 쓸 공간은 제한됩니다. 실제 API는 입력과 출력의 별도 상한을 둘 수도 있으므로 이것은 원리를 보여주는 예시입니다.
한도를 넘기면 서비스가 오래된 메시지를 제외하는 Truncation(절단), 앞부분을 짧게 다시 써 전달하는 Summarization(요약), 필요한 자료를 다시 가져오는 Retrieval(검색) 등을 사용할 수 있습니다. 따라서 채팅 화면에 기록이 보인다고 그 모든 문장이 이번 추론에 전달되었다는 뜻은 아닙니다.
그런데 진짜 이상한 일은 이제부터입니다. 책상 위에 정답이 분명히 놓여 있는데도 AI가 그 문장을 제대로 사용하지 못할 수 있습니다.
2024년, 연구자들은 정답의 위치만 바꿨습니다
Nelson F. Liu와 동료들의 Lost in the Middle: How Language Models Use Long Contexts는 2024년 학술지 Transactions of the Association for Computational Linguistics에 발표됐습니다. 제목은 '중간에서 길을 잃다' 정도로 옮길 수 있습니다.
연구진은 단순하게 물었습니다. “정답 문서를 입력으로 제공한다면 앞에 있든, 가운데 있든, 뒤에 있든 똑같이 찾아낼까?”
첫 번째 과제는 Multi-document Question Answering(다중 문서 질의응답)이었습니다. 질문 하나와 여러 검색 문서를 주되, 정답이 담긴 문서 하나의 위치를 앞에서 뒤로 바꿉니다. 모델이 받는 정답 자체는 사라지지 않습니다.
다른 과제는 Key-Value Retrieval(키-값 검색)입니다. 키와 값이 짝지어진 목록에서 특정 키의 값을 찾도록 시킵니다.
여러 모델에서 정답 문서가 맨 앞이나 뒤에 있으면 결과가 상대적으로 좋았고, 가운데에 있으면 정확도가 떨어졌습니다. 성능 그래프가 U자 형태로 나타나기도 했습니다. 앞쪽 정보의 유리함은 Primacy Bias(초두 편향), 뒤쪽 정보의 유리함은 Recency Bias(최근 위치 편향)와 연관 지어 설명할 수 있습니다. 모든 모델과 과제에서 같은 곡선이 나온 것은 아닙니다.
같은 정답인데 정확도가 22%포인트 달라졌습니다
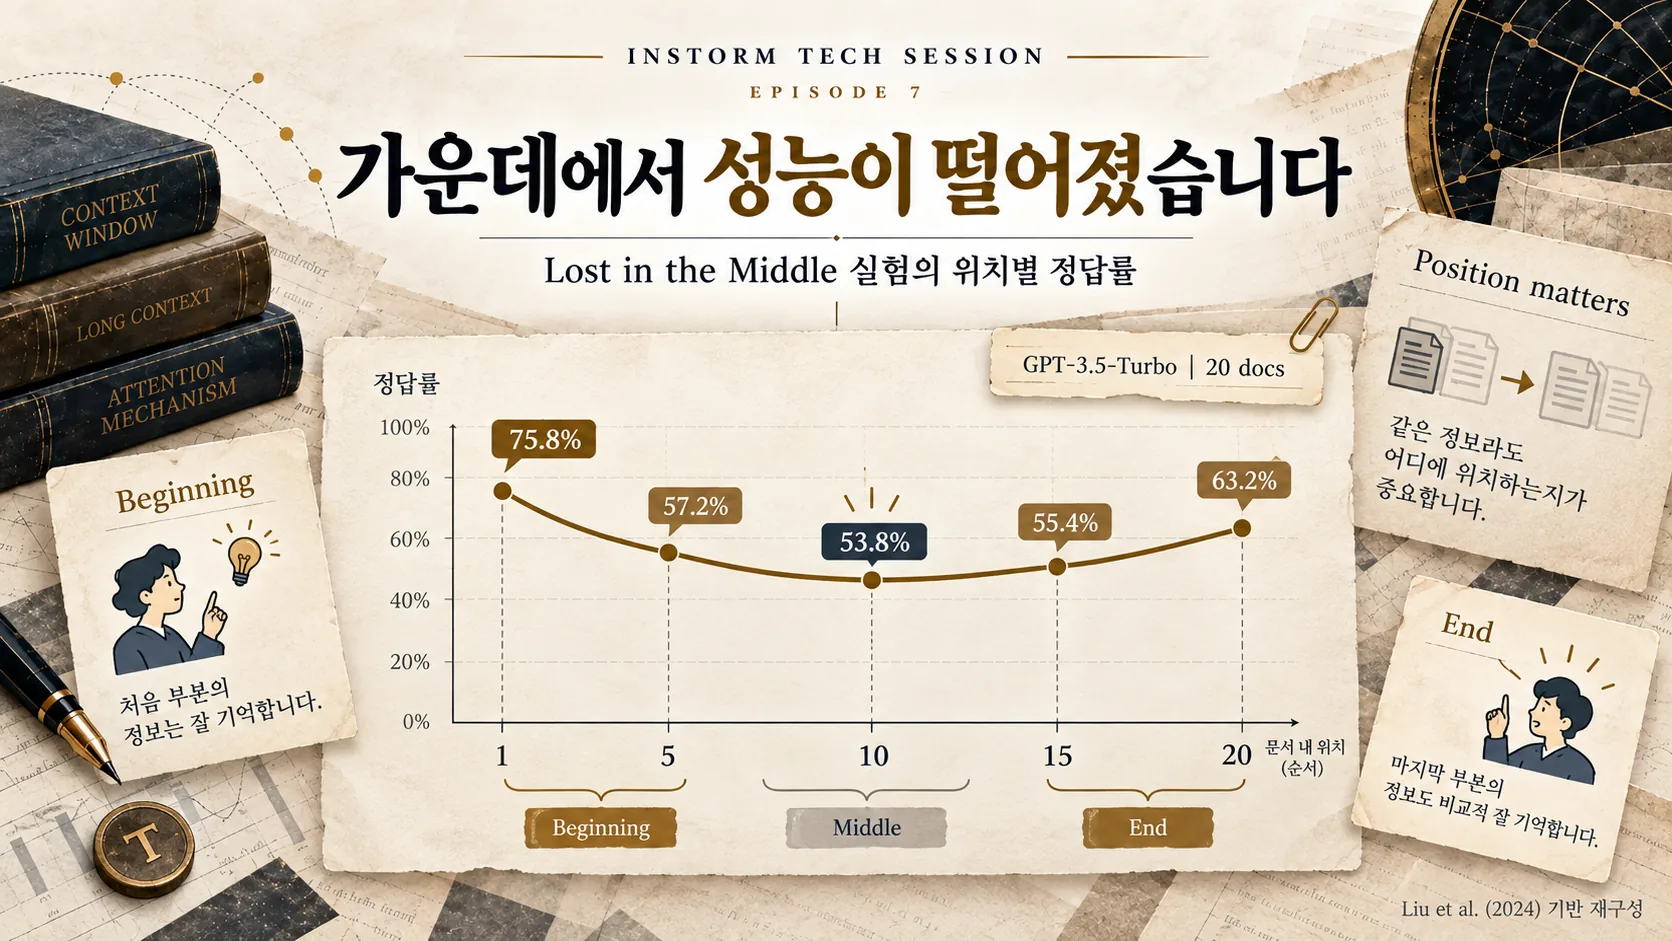
논문의 실제 숫자를 보겠습니다. 연구진은 당시 GPT-3.5-Turbo에 정답 문서 한 개와 다른 문서들을 합쳐 20개의 검색 문서를 제공했습니다. 그림에는 약 4K 토큰 조건으로 표시됐지만 입력 길이는 문서별로 다릅니다. 논문 부록의 해당 조건은 평균 약 2,946토큰, 최장 약 3,920토큰입니다.
| 정답 문서 위치 | 정답률 |
|---|---|
| 첫 번째 | 75.8% |
| 다섯 번째 | 57.2% |
| 열 번째 | 53.8% |
| 열다섯 번째 | 55.4% |
| 스무 번째 | 63.2% |
출처: Liu et al. (2024), 부록 Table 6. GPT-3.5-Turbo의 20문서 다중 문서 QA 실험.
맨 앞에 있으면 75.8%, 열 번째라면 53.8%입니다. 22.0%포인트 차이입니다. 맨 뒤에서는 63.2%까지 다시 올라갑니다. 흥미롭게도 이 실험에서 문서를 아예 주지 않고 답하는 Closed-book 조건의 정확도는 56.1%였습니다. 중간 위치에 정답을 준 경우가 이보다 낮았습니다.
물론 이것이 “문서를 주면 AI가 바보가 된다”는 뜻은 아닙니다. 당시의 특정 모델·데이터셋·설정에서 얻은 결과이지, 모든 최신 AI의 일반적인 정확도가 아닙니다.
하지만 중요한 구분이 드러납니다. Context Availability(정보가 입력에 존재하는가)와 Context Utilization(실제로 활용하는가)는 서로 다른 능력입니다.
모든 단어를 살펴보는 Attention이 있는데, 왜 놓칠까요?
4편에서 Self-Attention을 배웠습니다. Transformer는 Query(Q)와 Key(K)의 관계를 계산하고, Value(V)를 가중합합니다. 그러면 모든 이전 토큰을 참고할 수 있는데 중간의 정답을 왜 놓칠까요?
Attention은 문자열 검색 프로그램이 아닙니다. 모델은 학습된 숫자 표현을 여러 층에서 결합해 다음 토큰의 확률을 계산합니다. 특정 토큰에 Attention 가중치가 존재해도 그것이 최종 답변에 정확하게 반영되었다고 단정할 수 없습니다.
또한 Causal Mask(인과 마스크)를 사용하는 Decoder-only Transformer에서 앞의 토큰은 뒤에 나올 질문을 미리 참고할 수 없습니다. 문서 전체를 먼저 제시하고 맨 마지막에 질문을 붙인다면, 앞부분 문서의 표현을 계산하는 시점에 그 질문은 아직 뒤에 있습니다.
연구진은 질문을 문서 뒤에만 놓는 대신 앞과 뒤에 함께 배치하는 Query-aware Contextualization(질문 인식형 문맥 구성)을 실험했습니다. 일부 키-값 검색 과제에서는 놀라울 만큼 효과적이었습니다. 논문의 GPT-3.5-Turbo 16K, 300개 키-값 쌍 설정에서 어려운 위치의 정확도는 기존 45.6%였지만 질문을 앞뒤에 배치했을 때 100%가 보고됐습니다.
그런데 다중 문서 질의응답에서는 위치 민감성이 실질적으로 해소되지 않았습니다. 단순한 값을 찾아 반환하는 일과 여러 문서를 읽고 답을 만드는 일은 같지 않았습니다. 연구진 역시 위치 민감성의 원인을 하나로 단정하지 않았습니다.
2025년에는 문자열을 맞춰 찾는 것만으로 부족했습니다
2024년 발표된 RULER는 숨은 문장 하나를 찾아내는 Needle-in-a-Haystack 테스트만으로 긴 문맥 능력을 다 평가하기 어렵다고 지적했습니다. 여러 단서를 함께 찾거나 집계하는 과제도 필요했습니다.
2025년 ICML의 NoLiMa: Long-Context Evaluation Beyond Literal Matching는 직접적인 단어 일치의 도움을 줄이는 실험을 제안했습니다.
질문이 “파란색 열쇠를 가진 사람은 누구야?”이고 본문에 “파란색 열쇠를 가진 사람은 민수다”라고 적혀 있다면, 비슷한 단어를 찾는 것만으로도 도움이 됩니다. NoLiMa는 그런 일치를 최소화하고 의미 관계를 통해 정답을 찾도록 했습니다.
최소 128K 문맥을 지원한다고 명시된 모델 13개를 평가한 이 논문에서, GPT-4o는 짧은 입력 조건 99.3%에서 32K 토큰 조건 69.7%로 하락했습니다. 이는 2025년의 특정 벤치마크 결과이며 현재 모델의 일반 정확도나 모든 긴 문맥 작업으로 일반화할 수 없습니다.
이 실험이 보여주는 것은 분명합니다. 길이만의 문제가 아니라 어떤 단서를 어떤 방식으로 찾아야 하는가도 중요합니다.
기억력을 늘리는 것보다 중요한 일
다시 강릉 워크숍 이야기로 돌아가 보겠습니다. 날짜가 현재 입력에서 빠졌다면 정답을 직접 확인할 수 없습니다. 하지만 그 날짜가 들어 있더라도 모델이 잘 활용할지는 별도의 문제입니다.
따라서 실무에서는 중요한 사실을 구조화해 제공하고, 필요한 문서만 검색해 연결한 뒤, 답변이 근거를 충실히 따르는지 확인하는 방식이 도움이 됩니다. 이것이 13편에서 다룰 RAG(Retrieval-Augmented Generation, 검색 증강 생성)와 연결됩니다. 물론 검색 결과가 정확해도 답변이 자동으로 정확해지는 것은 아닙니다.
긴 문맥을 다룰 때에는 네 가지를 구별해야 합니다. 입력에 얼마나 많이 넣을 수 있는지, 필요한 정보가 이번 입력에 있는지, 모델이 그 정보를 찾는지, 그리고 찾은 내용을 올바른 답으로 사용하는지입니다.
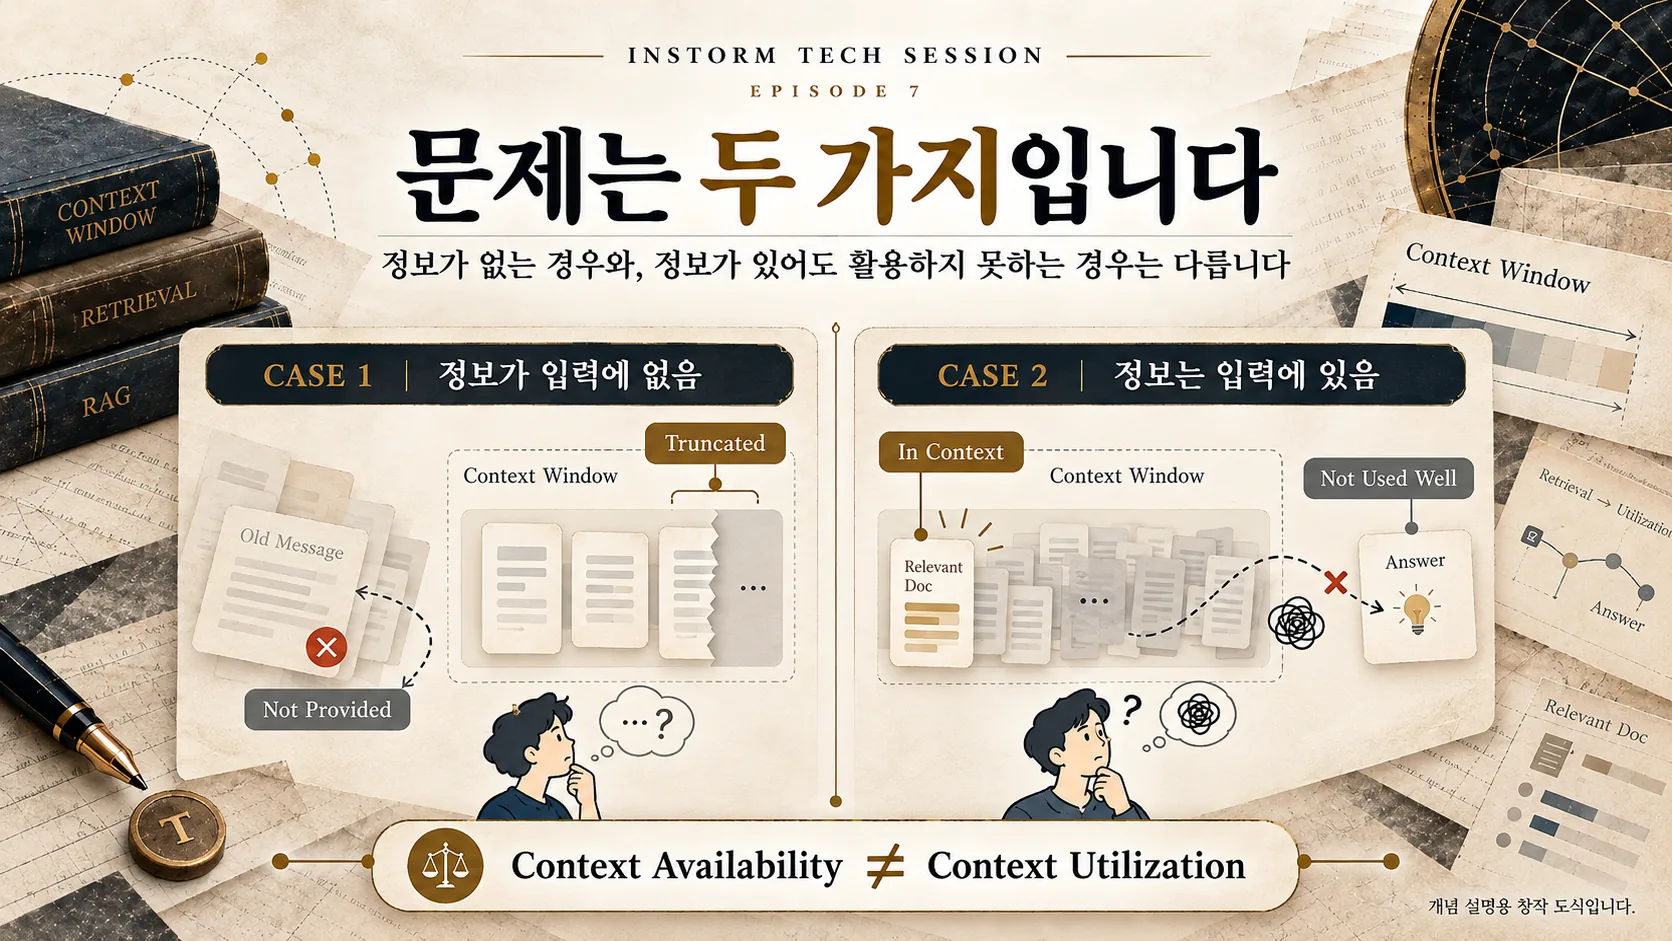
Context Window를 키우는 기술은 입력 한도를 넓힙니다. 하지만 안에 들어간 모든 내용을 똑같이 잘 쓰게 만들지는 않습니다.
그렇다면 수천·수만 토큰을 실제로 처리할 때는 무슨 일이 일어날까요? 화면 속 글자는 가벼워 보이지만 GPU 안에는 이전 토큰의 계산 결과가 쌓이고 있습니다. 8편에서는 KV Cache와 GPU 메모리의 세계로 들어가 보겠습니다.
참고 자료
- Liu et al. (2024), Lost in the Middle: How Language Models Use Long Contexts — TACL 본문과 부록 Table 6, 위치별 성능 및 질문 배치 실험.
- Vaswani et al. (2017), Attention Is All You Need — Self-Attention과 인과 마스크의 구조적 배경.
- Hsieh et al. (2024), RULER: What's the Real Context Size of Your Long-Context Language Models? — 긴 문맥의 다양한 평가.
- Modarressi et al. (2025), NoLiMa: Long-Context Evaluation Beyond Literal Matching — ICML 2025, 단어 일치에 의존하지 않는 문맥 검색.
- Lewis et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — 외부 근거 검색과 생성의 결합.