RESEARCH / Instorm
TECH SESSION 8편 | 대화가 길어질수록 왜 GPU 메모리는 부족해질까?
Prefill과 Decode는 어떻게 다를까? KV Cache에 K/V를 보관하는 이유, 8,192토큰에 1GiB가 필요한 가상 계산과 vLLM·GQA·MLA를 설명합니다.
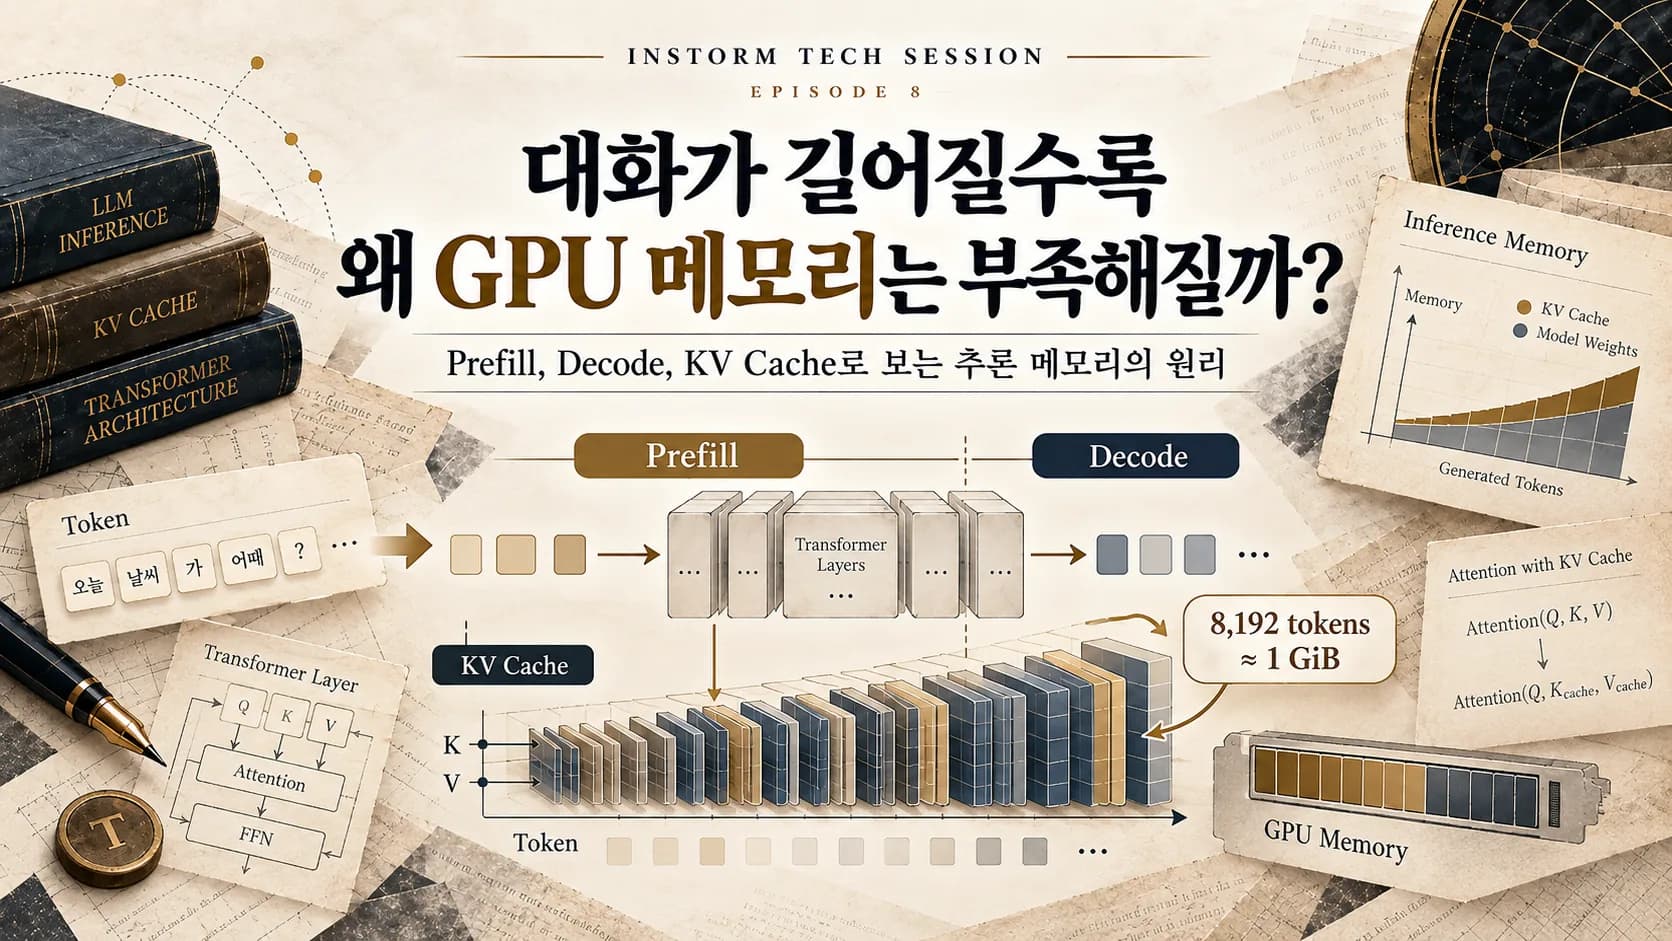
AI와 대화를 나누는 동안 화면에는 문장이 몇 줄씩 쌓입니다. 그런데 어떤 모델 구조에서는 토큰 8,192개를 보관하는 데 GPU 메모리 1GiB가 필요할 수 있습니다. 텍스트 파일로 저장하면 훨씬 작은 내용인데, GPU에서는 왜 이렇게 커질까요? 이유는 조금 역설적입니다. 계산을 빠르게 만들기 위해 이미 계산한 결과를 메모리에 쌓아두기 때문입니다.
짧은 답변 하나를 만들 때도 이전 문장이 필요합니다
식당에서 손님이 파스타와 콜라를 주문했습니다. 조금 뒤 “치즈도 추가해 주세요”라고 말합니다. 이때마다 주방장이 주문서를 처음부터 다시 읽고 모든 준비를 반복해야 한다면 어떨까요? 한두 명일 때는 괜찮아도 손님 수백 명이라면 심각한 낭비가 생길 것입니다.
많은 Transformer 기반 언어모델도 이전에 생성한 토큰을 바탕으로 다음 토큰을 만듭니다. 이를 Autoregressive Decoding(자기회귀 디코딩)이라고 합니다.
“오늘 회의는 오후 세 시에 시작합니다.”
설명을 위해 이 답을 오늘 / 회의는 / 오후 / 세 / 시에 / 시작합니다라는 가상 토큰 조각으로 나누겠습니다. 실제 토크나이저의 분할 결과는 모델마다 다릅니다.
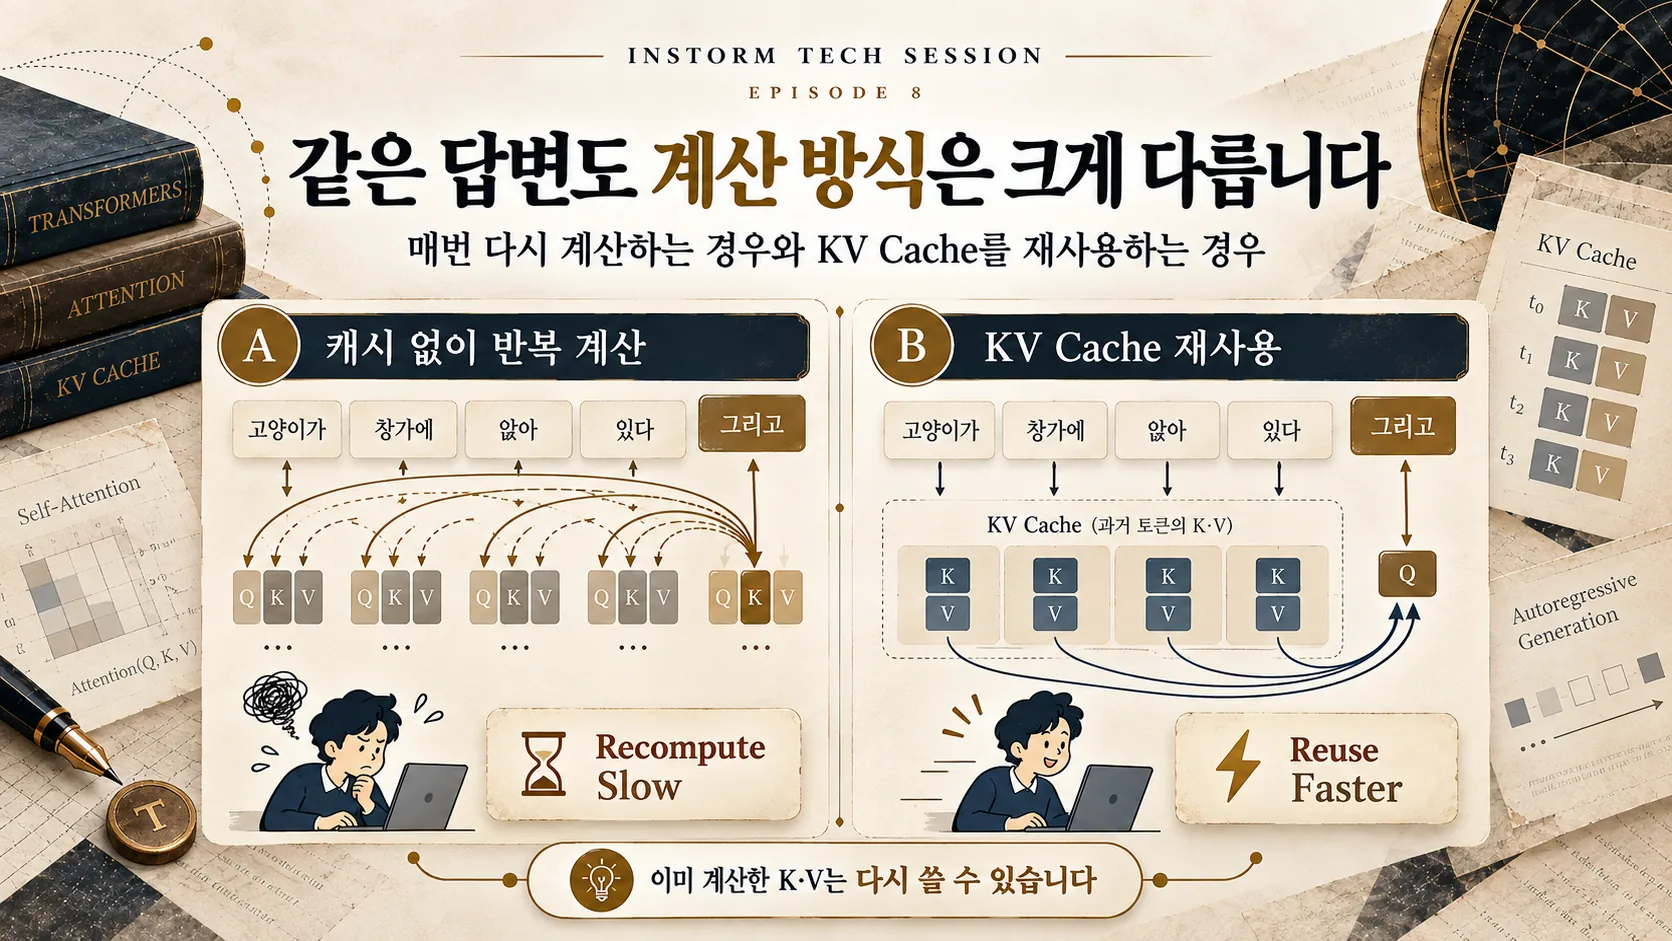
첫 번째 조각을 만든 뒤 두 번째, 그다음 세 번째 조각을 만듭니다. 새 토큰을 계산할 때 앞서 처리한 문맥을 다시 참고해야 합니다. 과거 토큰의 연산을 매 단계 처음부터 모두 수행한다면 낭비가 큽니다. 그래서 이미 계산한 것 중 다시 쓸 수 있는 값을 저장합니다.
오늘의 주인공 KV Cache(Key-Value Cache)입니다.
AI가 질문을 읽는 시간과 답을 쓰는 시간은 다릅니다
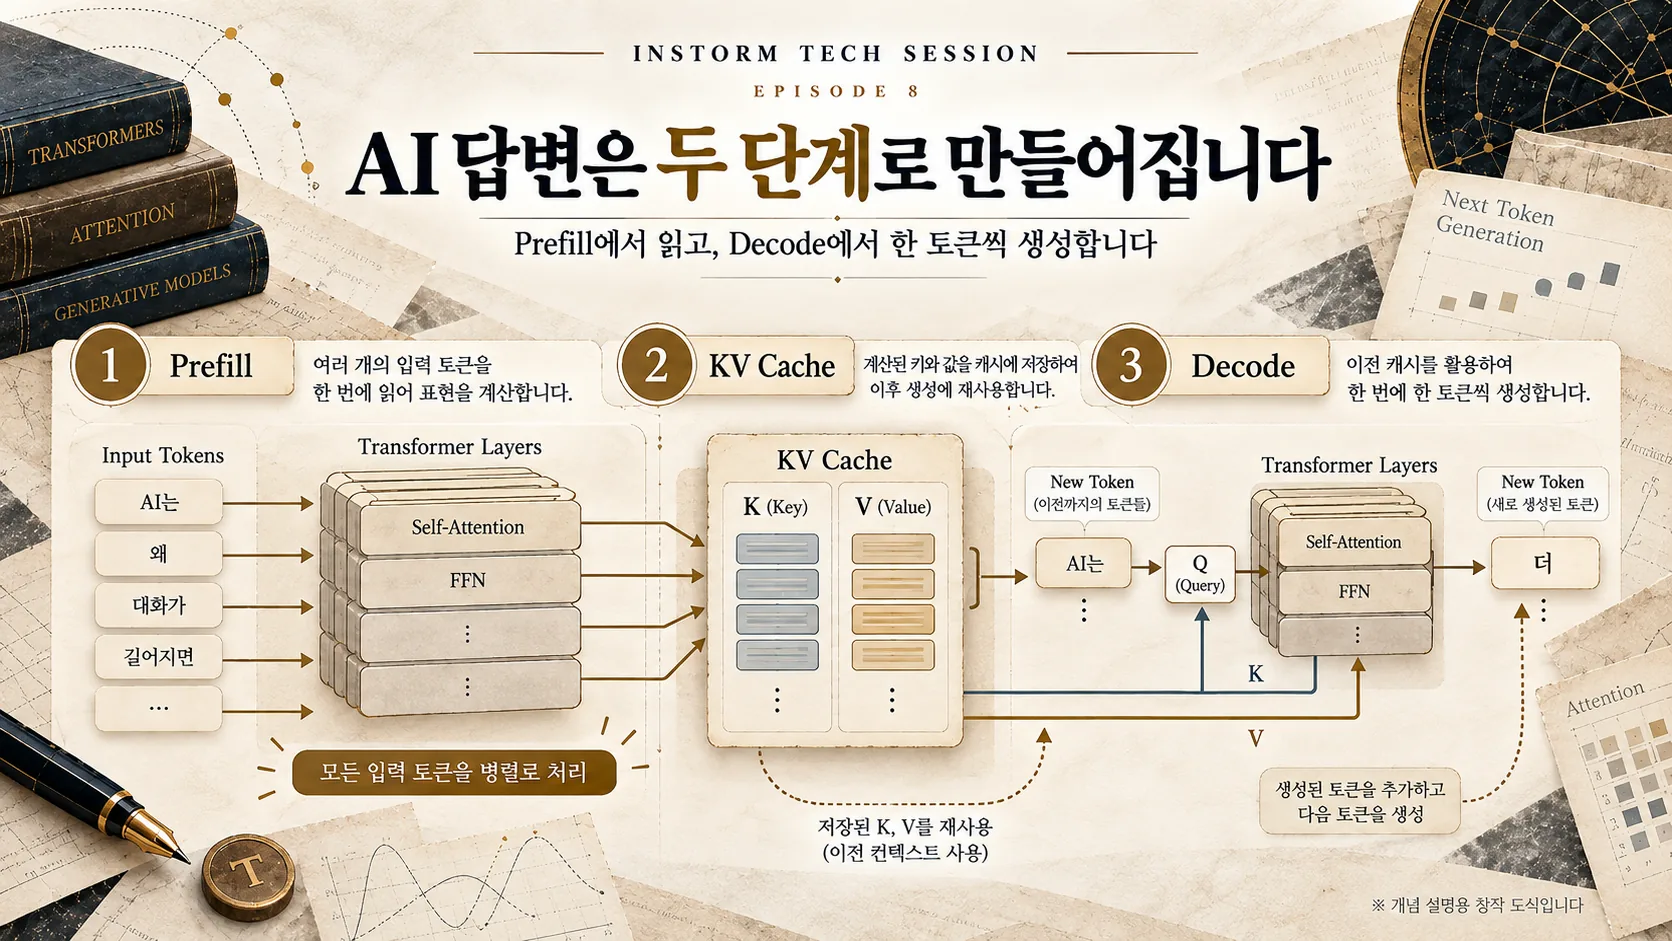
긴 회의록을 AI에게 주고 요약을 요청했다고 해보겠습니다. AI는 우선 회의록과 지시문을 처리합니다. 이 단계를 Prefill(프리필)이라고 합니다. 입력 토큰을 모델의 여러 계층에 통과시키면서 Attention에 필요한 내부 표현을 계산합니다. 입력의 여러 위치를 병렬로 처리할 수 있어 GPU의 대규모 행렬 연산을 활용합니다.
그다음에는 답변을 한 토큰씩 생성하는 Decode(디코드) 단계가 시작됩니다. 앞서 출력한 토큰이 다음 토큰의 조건이 되므로 일반적인 자기회귀 생성에는 순차적인 의존성이 있습니다.
두 단계의 병목은 다릅니다. Prefill에서는 긴 입력에 대한 행렬 연산이 중요하고, Decode에서는 매 새 토큰마다 과거의 K/V를 읽어야 하므로 Memory Bandwidth(메모리 대역폭)가 중요해질 수 있습니다. 대역폭은 일정 시간에 메모리에서 데이터를 읽고 쓸 수 있는 양입니다.
GPU의 계산 능력이 아무리 좋아도 필요한 숫자가 제때 도착하지 않으면 연산 장치는 기다립니다. 빠른 요리사도 재료가 늦게 오면 요리를 빨리 끝낼 수 없는 것과 비슷합니다.
K와 V는 왜 저장하고 Q는 매번 만들까요?
4편에서 배운 Self-Attention을 떠올려보겠습니다. 현재 토큰의 Query(Q)는 과거 위치의 Key(K)와 비교됩니다. 그 결과로 만든 Attention 가중치를 Value(V)에 적용해 정보를 결합합니다.
“고양이가 창가에서 잠든다”라는 문장의 과거 토큰들은 다음 토큰을 만들 때도 참고 대상이 될 수 있습니다. 다음 생성 단계에서 앞부분에 대한 K와 V를 다시 계산하는 대신, 이전에 구한 값을 저장해 재사용할 수 있습니다.
그 저장 공간이 KV Cache입니다. 흐름은 다음과 같습니다.
- Prefill에서 입력 토큰들의 K와 V를 각 Transformer 층별로 계산합니다.
- 과거 토큰의 K와 V를 GPU 메모리의 캐시에 보관합니다.
- 새 토큰을 처리하면서 현재 위치의 Q·K·V를 계산합니다.
- 현재 Q가 과거 캐시의 K들을 참조하고, 해당 V들과 현재 V를 이용해 Attention 출력을 계산합니다.
- 새 위치의 K와 V도 캐시에 추가합니다.
핵심은 KV Cache는 문장을 보관한 메모장이 아니라, Attention 계산에서 다시 사용하는 숫자 표현을 저장한 것이라는 점입니다.
또한 이 캐시는 일반적으로 하나의 추론 요청에서 이어지는 생성 과정에 관한 설명입니다. 사용자가 새 메시지를 보내는 별도 요청에서 이전 캐시가 무조건 재사용되는 것은 아닙니다. 서버가 공통 Prefix(접두 문맥)를 보존·재사용하도록 설계해야 관련 계산을 절약할 수 있습니다.
토큰 하나가 GPU 메모리를 얼마나 차지할까요?
이제 숫자를 직접 계산해보겠습니다. 다음은 가상의 작은 Transformer 모델입니다.
- Transformer Layer: 2개
- KV Head: 4개
- Head Dimension: 8
- 데이터 타입: FP16, 숫자 하나에 2바이트
- Batch Size: 1
Layer는 계산 층, KV Head는 K와 V 벡터의 묶음, Head Dimension은 각 묶음의 차원 수입니다. K와 V 두 종류를 저장해야 하므로 토큰 하나의 순수 KV 저장량은 다음과 같습니다.
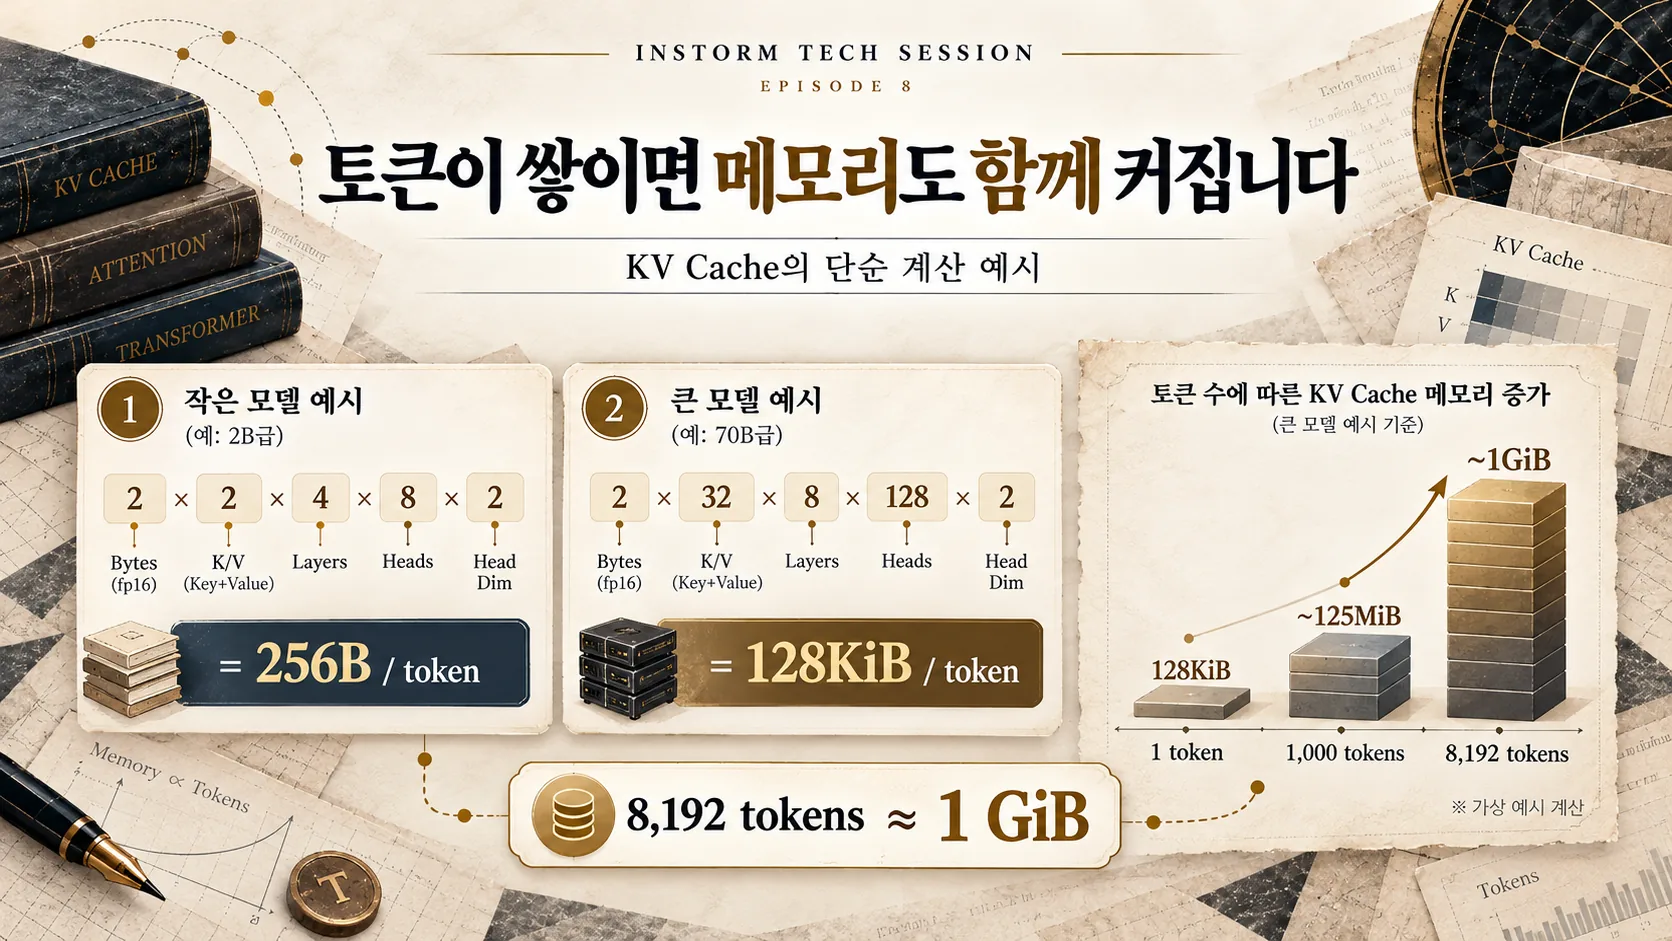
2(K·V) × 2(Layer) × 4(KV Head) × 8(차원) × 2(바이트) = 256바이트
| 누적 토큰 수 | 순수 KV Cache 용량 |
|---|---|
| 1 | 256B |
| 1,000 | 256KB |
| 4,000 | 1.024MB |
| 8,000 | 2.048MB |
KB·MB는 10진 단위입니다. 이 예시는 실제 특정 LLM 측정이 아니라 지정된 차원으로 검산한 순수 텐서 용량입니다.
좀 더 큰 가상 모델을 생각해보겠습니다. Layer 32개, KV Head 8개, Head Dimension 128, FP16이라고 가정합니다.
2 × 32 × 8 × 128 × 2 = 131,072바이트. 토큰 하나당 128KiB입니다.
8,192토큰을 누적 저장한다면 131,072 × 8,192 = 1,073,741,824바이트, 정확히 1GiB입니다. 같은 길이의 독립된 요청 열 개가 각각 캐시를 보관하고 요청 사이에 공유가 없다면 순수 KV 데이터만 약 10GiB입니다.
모든 LLM이 8,192토큰에 1GiB를 쓴다는 이야기가 아닙니다. KV Head 수·층 수·차원·자료형·압축 및 공유 여부에 따라 값은 달라집니다.
GPU 메모리에는 모델 가중치만 있는 것이 아닙니다
모델의 파라미터를 저장하는 Weights(가중치), 추론 중간 계산을 위한 Activations(활성값), 과거 토큰의 K/V를 보관하는 KV Cache, 그리고 커널 실행을 위한 임시 Workspace(작업 공간)가 모두 GPU 메모리를 사용할 수 있습니다.
예를 들어 70억 개 파라미터를 FP16으로 저장하면 순수 가중치 용량의 이론치는 14GB입니다. 그러나 이것만으로 실제 서버의 전체 VRAM을 계산할 수는 없습니다. 긴 문맥, 여러 동시 요청, 배치와 커널의 공간 요구량이 추가됩니다.
2023년 vLLM 원논문의 Figure 1에는 A100 40GB GPU에 13B 모델을 올린 예시가 있습니다. 여기에서 파라미터가 약 26GB를 사용하며, 남은 공간의 상당 부분이 동적으로 커지는 KV Cache에 배정될 수 있음을 보여줍니다. 특정 당시 시스템의 예시이며 모든 13B 모델에서 같은 구성이 나온다는 뜻은 아닙니다.
한 가지 더 중요한 구분이 있습니다. KV Cache의 저장량이 입력 길이에 선형적으로 증가할 수 있다는 사실과 표준 Attention의 전체 Prefill 연산량이 선형이라는 주장은 다릅니다. 전체 Self-Attention의 토큰 쌍 관계 계산은 입력 길이에 대해 제곱 규모일 수 있습니다.
2023년, 연구자들은 메모리를 호텔 객실처럼 관리했습니다
손님이 언제 체크아웃할지 모른다고 객실 여러 개를 미리 묶어 예약하면 빈방이 남아도 새 손님을 받기 어려워집니다. 컴퓨터의 메모리도 연속된 큰 공간을 요청마다 확보하려 하면 낭비와 Fragmentation(단편화)가 생길 수 있습니다.
2023년 SOSP에서 Woosuk Kwon과 동료들은 Efficient Memory Management for Large Language Model Serving with PagedAttention을 발표했습니다. KV Cache를 고정 크기의 블록으로 다루고, 모델이 보는 논리적 블록을 실제 물리 메모리 블록과 연결하는 방식입니다. 운영체제의 가상 메모리 관리에서 착안했습니다.
이 기술이 PagedAttention(페이지드 어텐션)이고, 이를 활용한 LLM 서빙 시스템이 vLLM입니다.
원논문은 FasterTransformer·Orca 등 당시 비교 시스템과의 특정 작업·지연 조건에서, vLLM이 같은 수준의 지연시간에서 2~4배 높은 처리량(Throughput)을 달성했다고 보고했습니다. AI의 정답률이 높아진 것도 아니고, 오늘날 모든 서버가 무조건 네 배 빨라진다는 뜻도 아닙니다.
모델의 지식을 바꾸지 않더라도 메모리를 배정하고 재사용하는 방법이 서비스 성능을 바꿀 수 있다는 점이 중요합니다.
저장하는 방법과 저장할 숫자 자체를 바꾸는 방법
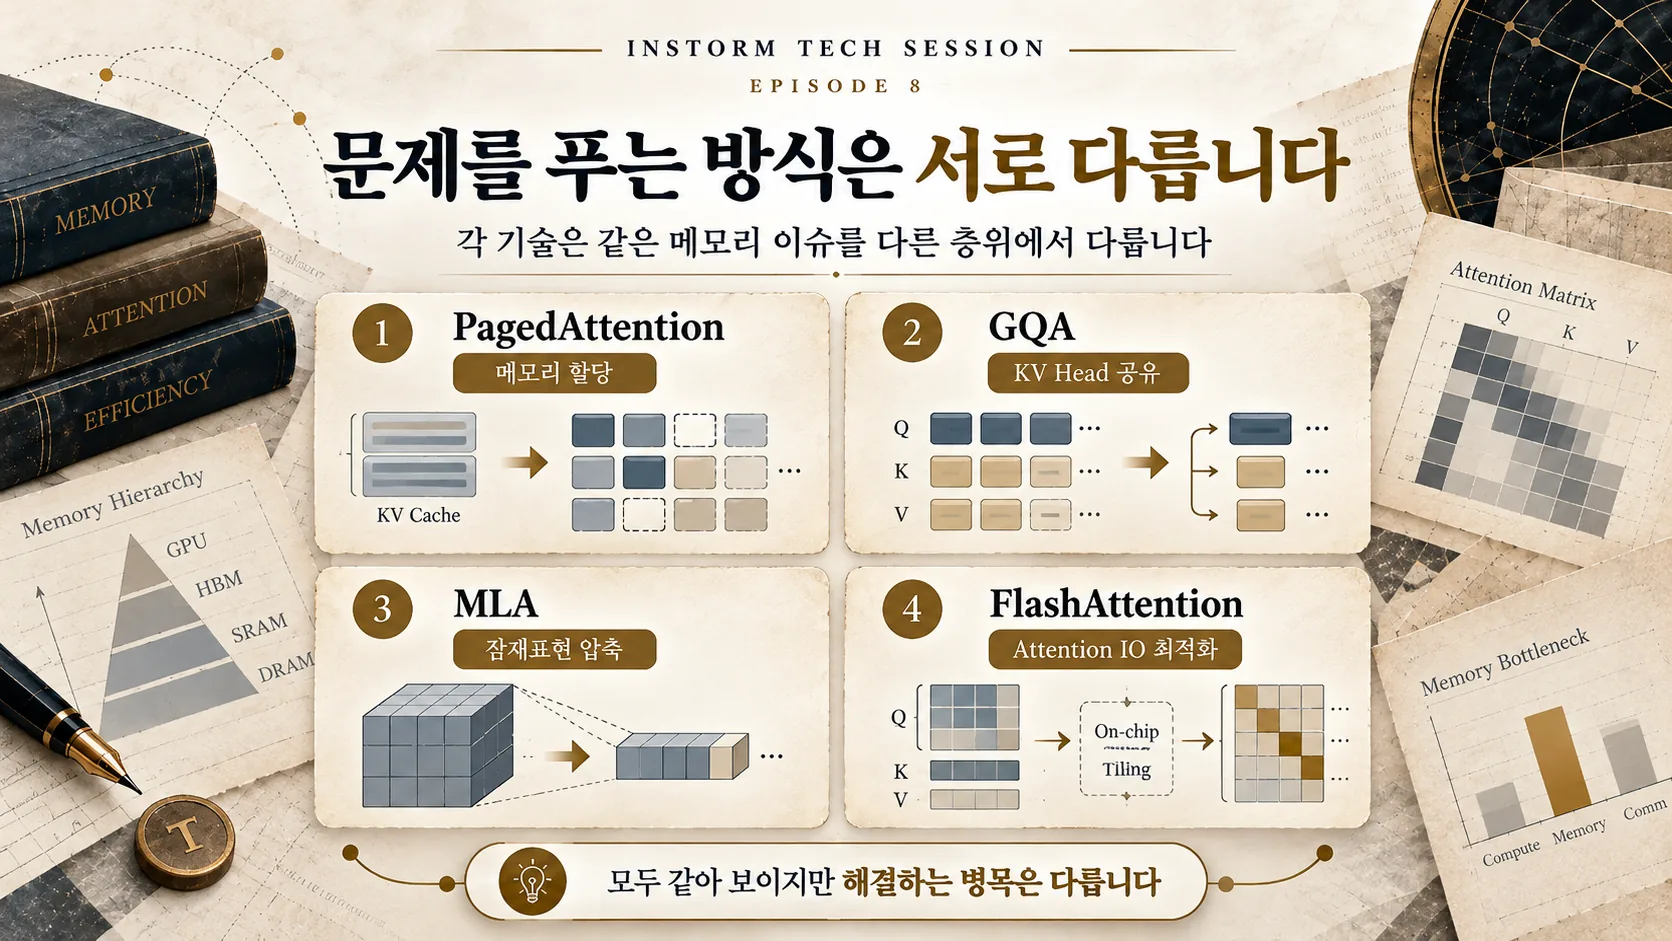
PagedAttention이 캐시 메모리의 관리 방법을 바꾼다면, GQA(Grouped-query Attention)는 여러 Query Head가 K/V Head를 공유하게 해 저장해야 할 K/V 요소 수를 줄입니다. 예를 들어 다른 차원이 같을 때 Q Head 32개, KV Head 8개라면 KV Head 32개인 MHA보다 K/V 저장 요소 수가 4분의 1입니다. 다만 전체 VRAM이나 지연시간이 그대로 4분의 1이 된다는 뜻은 아닙니다.
2024년 DeepSeek-V2는 MLA(Multi-head Latent Attention)를 이용해 K/V 정보를 저차원 잠재표현으로 압축해 캐시에 보관하는 접근을 발표했습니다. 논문은 DeepSeek 67B와의 모델 비교에서 KV Cache 93.3% 절감을 보고했습니다. 두 모델의 비교 결과이지 MLA만 단독 교체한 일반적 절감 비율이 아닙니다.
뒤의 16편에서 다룰 FlashAttention은 다시 다른 문제를 다룹니다. Attention 계산 과정에서 GPU HBM과 온칩 메모리 사이의 불필요한 데이터 이동을 줄이는 IO-aware 알고리즘입니다.
즉 PagedAttention은 할당, GQA는 K/V Head 공유, MLA는 저장 표현 압축, FlashAttention은 계산 중 데이터 이동을 최적화합니다. 모두 효율 기술이지만 같은 알고리즘은 아닙니다.
처음의 채팅창으로 돌아가 보겠습니다. 글자 몇 줄을 추가했을 뿐인데 GPU에서는 여러 층에 걸친 K/V 숫자가 쌓입니다. 이전 계산을 줄여주는 KV Cache는 유용하지만 메모리 공간과 대역폭이라는 새로운 비용도 사용합니다.
KV Cache는 반복 계산의 낭비를 줄이지만, 긴 문맥에서 정보 활용의 정확도나 무제한 동시 접속을 보장하지 않습니다.
이제 다음 질문이 생깁니다. GPU 메모리와 계산량이 이렇게 중요하다면, 애초에 모든 파라미터를 매번 계산할 필요가 있을까요? 9편에서는 47B를 가지고도 약 13B만 활성화하는 Mixture-of-Experts의 원리를 살펴보겠습니다.
참고 자료
- Vaswani et al. (2017), Attention Is All You Need — Transformer 및 Q/K/V Attention 구조.
- Kwon et al. (2023), Efficient Memory Management for Large Language Model Serving with PagedAttention — SOSP 2023, KV Cache 블록 관리와 vLLM 처리량 비교.
- Ainslie et al. (2023), GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints — GQA와 KV Head 공유.
- Dao et al. (2022), FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness — 정확한 Attention 연산의 IO 최적화.
- DeepSeek-AI (2024), DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model — MLA와 모델별 KV Cache 비교.