RESEARCH / Instorm
TECH SESSION 9편 | 470억 개의 파라미터 중 약 130억 개만 사용하는 AI의 비밀
Mixtral 8x7B는 왜 47B 중 약 13B만 활성화할까? MoE Top-2 Router 계산을 직접 따라가고 2026년 MAR·Standing Committee 논문을 살펴봅니다.
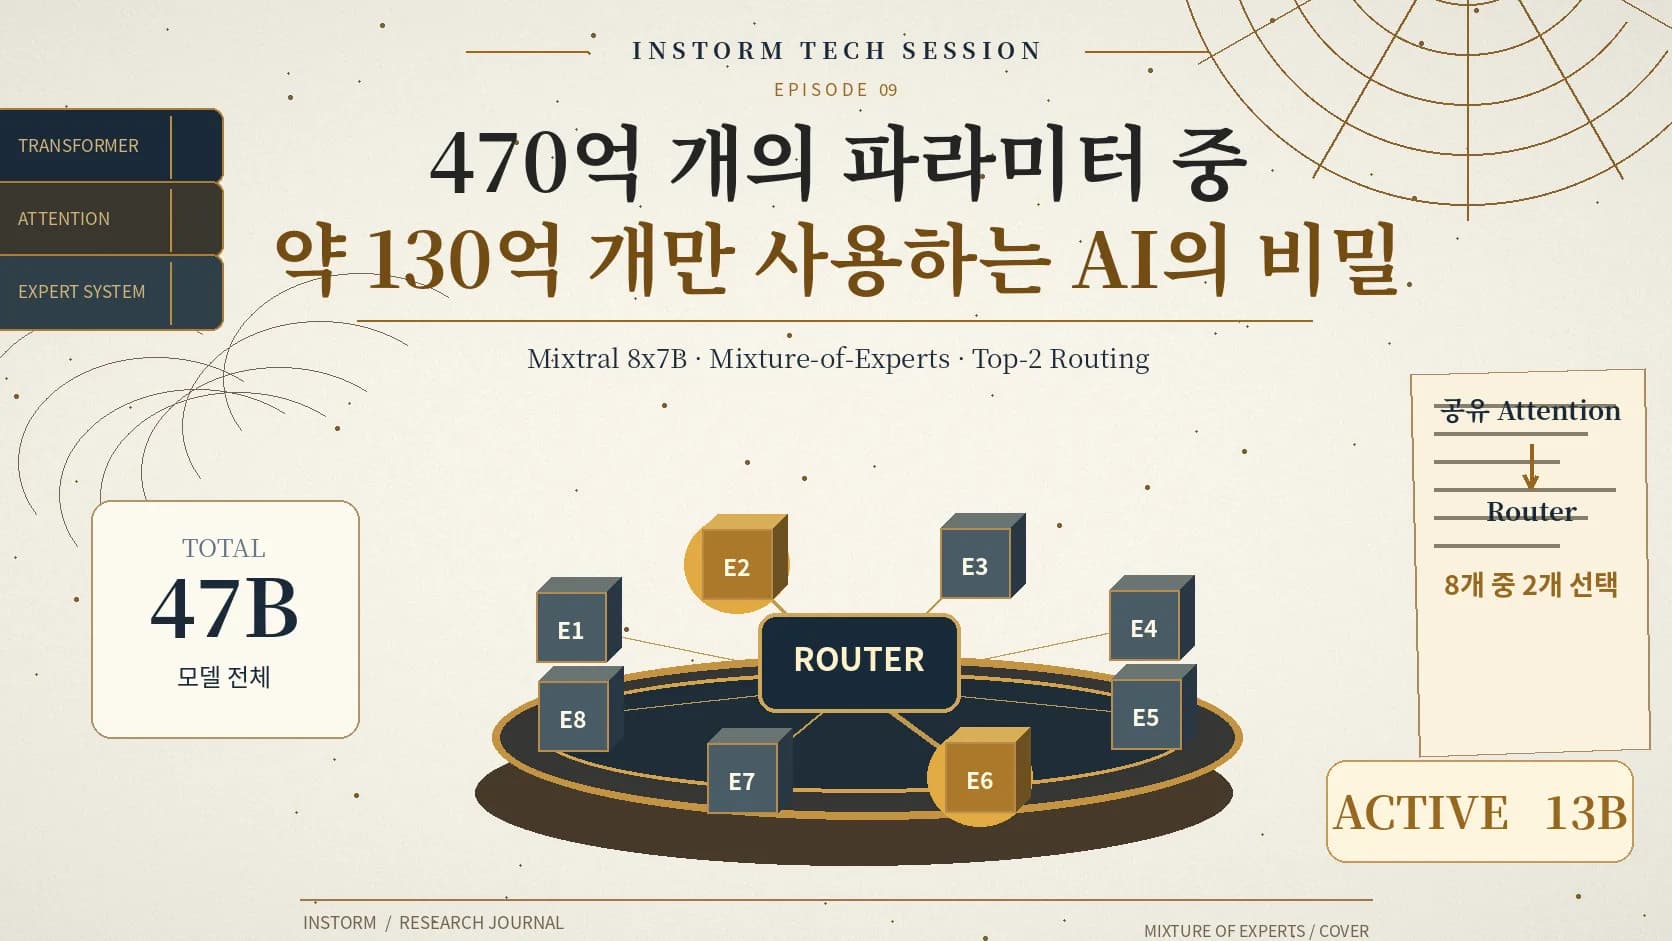
2024년, 흥미로운 AI 모델이 공개됐습니다. 전체 파라미터는 약 470억 개였지만, 토큰 하나를 처리할 때 활성화되는 것은 약 130억 개였습니다. 나머지 수백억 개는 어디에 있을까요? 쓰지도 않을 숫자를 왜 만들어 놓았을까요? 모델 전체의 크기와 특정 토큰을 계산할 때 사용하는 크기가 같을 필요는 없다는 발상에서 답을 찾을 수 있습니다.
AI가 가진 숫자를 매번 전부 계산해야 할까요?
여덟 개의 작업대가 있는 공장을 생각해 보겠습니다. 부품 하나가 들어왔습니다. 그런데 이 공장은 부품마다 여덟 작업대를 모두 쓰지 않습니다. 부품의 상태를 보고 그중 두 작업대만 고릅니다. 다른 부품이 오면 또 다른 두 작업대를 쓸 수 있습니다.
물론 AI 내부에 물리적 작업대가 있는 것은 아닙니다. 중요한 것은 전체 계산 경로를 매번 실행할 필요는 없다는 생각입니다.
일반적인 Dense Model(밀집 모델)에서는 토큰이 통과하는 각 층의 정해진 가중치 연산이 실행됩니다. 모델의 가중치가 많아지면 이를 저장하고 계산하는 비용도 커지기 쉽습니다.
전체 모델이 표현할 수 있는 용량은 늘리되, 입력 하나에 필요한 연산은 제한할 수 없을까요? 이런 접근을 Conditional Computation(조건부 계산)이라고 합니다. 대표적인 방식이 Mixture-of-Experts(MoE, 전문가 혼합)입니다.
MoE의 Expert(전문가)는 사람이 아닙니다. 독립적인 챗봇도 아닙니다. 학습 가능한 가중치를 가진 신경망 계산 모듈입니다. 토큰의 내부 표현을 기준으로 여러 Expert 중 일부를 선택하는 네트워크를 Router(라우터)라고 합니다.
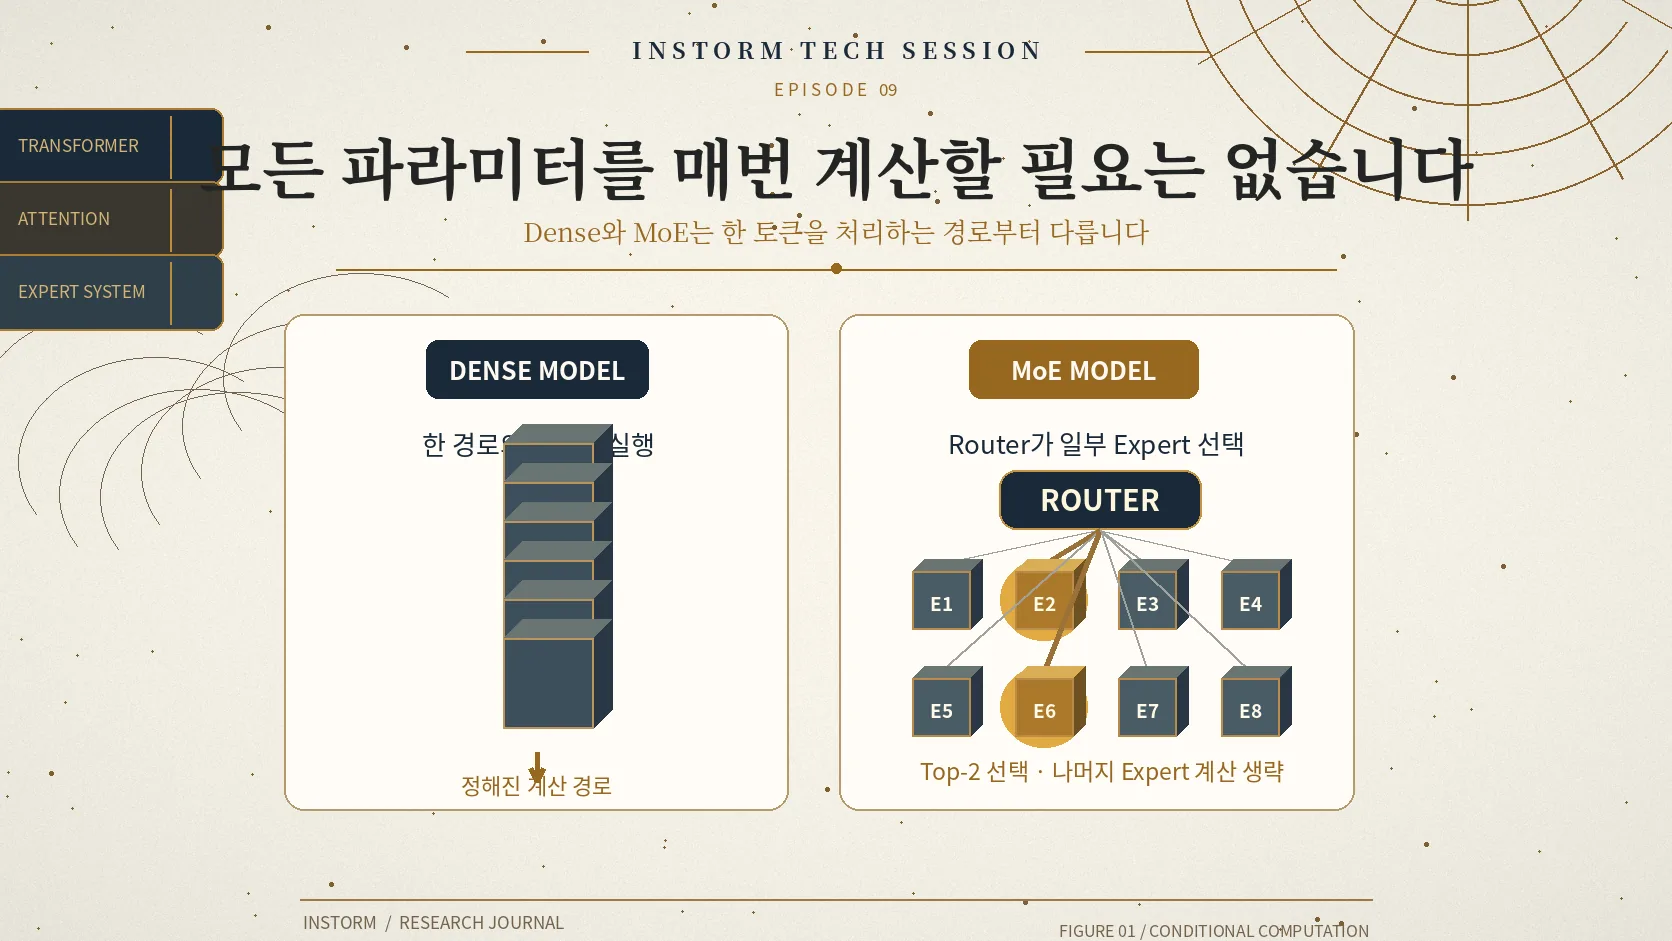
1991년부터 연구된 '전문가를 나눠 쓰자'는 생각
MoE는 ChatGPT 이후 생긴 유행어가 아닙니다. 1991년 Robert Jacobs와 동료들은 Adaptive Mixtures of Local Experts에서 여러 전문가 네트워크와 Gating(게이팅) 메커니즘을 연구했습니다. 전문가들의 출력 중 무엇을 얼마나 사용할지 결정하는 생각이었습니다.
이때의 방법이 현대 Transformer와 똑같았던 것은 아닙니다. 이후 2017년 Noam Shazeer와 동료들은 Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer를 발표했습니다. 수많은 전문가를 준비하되 토큰마다 일부만 활성화하는 Sparse(희소) MoE를 대규모 신경망에 적용했습니다.
그런데 Transformer의 어느 부분을 전문가로 나눌까요? 4편의 Self-Attention은 토큰 사이의 정보를 결합합니다. 또 다른 부분인 FFN(Feed-forward Network, 순전파 신경망)은 각 토큰의 내부 표현을 추가로 변환합니다.
많은 MoE 언어모델은 이 FFN 계산에 여러 Expert를 배치합니다. Attention 전체가 사라지거나 모델 자체가 여러 독립 챗봇으로 쪼개지는 것이 아닙니다.
2022년 Switch Transformers는 토큰마다 한 Expert를 선택하는 Top-1 라우팅을 대표적인 설계로 사용했습니다. 하지만 두 개를 선택할 수도 있습니다. 2024년 공개된 Mixtral 8x7B는 바로 Top-2 Routing을 사용합니다.
8x7B인데 왜 560억 개가 아니라 470억 개일까요?
Albert Q. Jiang와 동료들이 발표한 Mixtral of Experts를 살펴보겠습니다. 이름이 Mixtral 8x7B이니 '70억 개 파라미터인 AI가 여덟 개'라고 생각하기 쉽습니다. 70억 × 8은 560억입니다. 그런데 원논문이 소개한 전체 규모는 약 470억입니다.
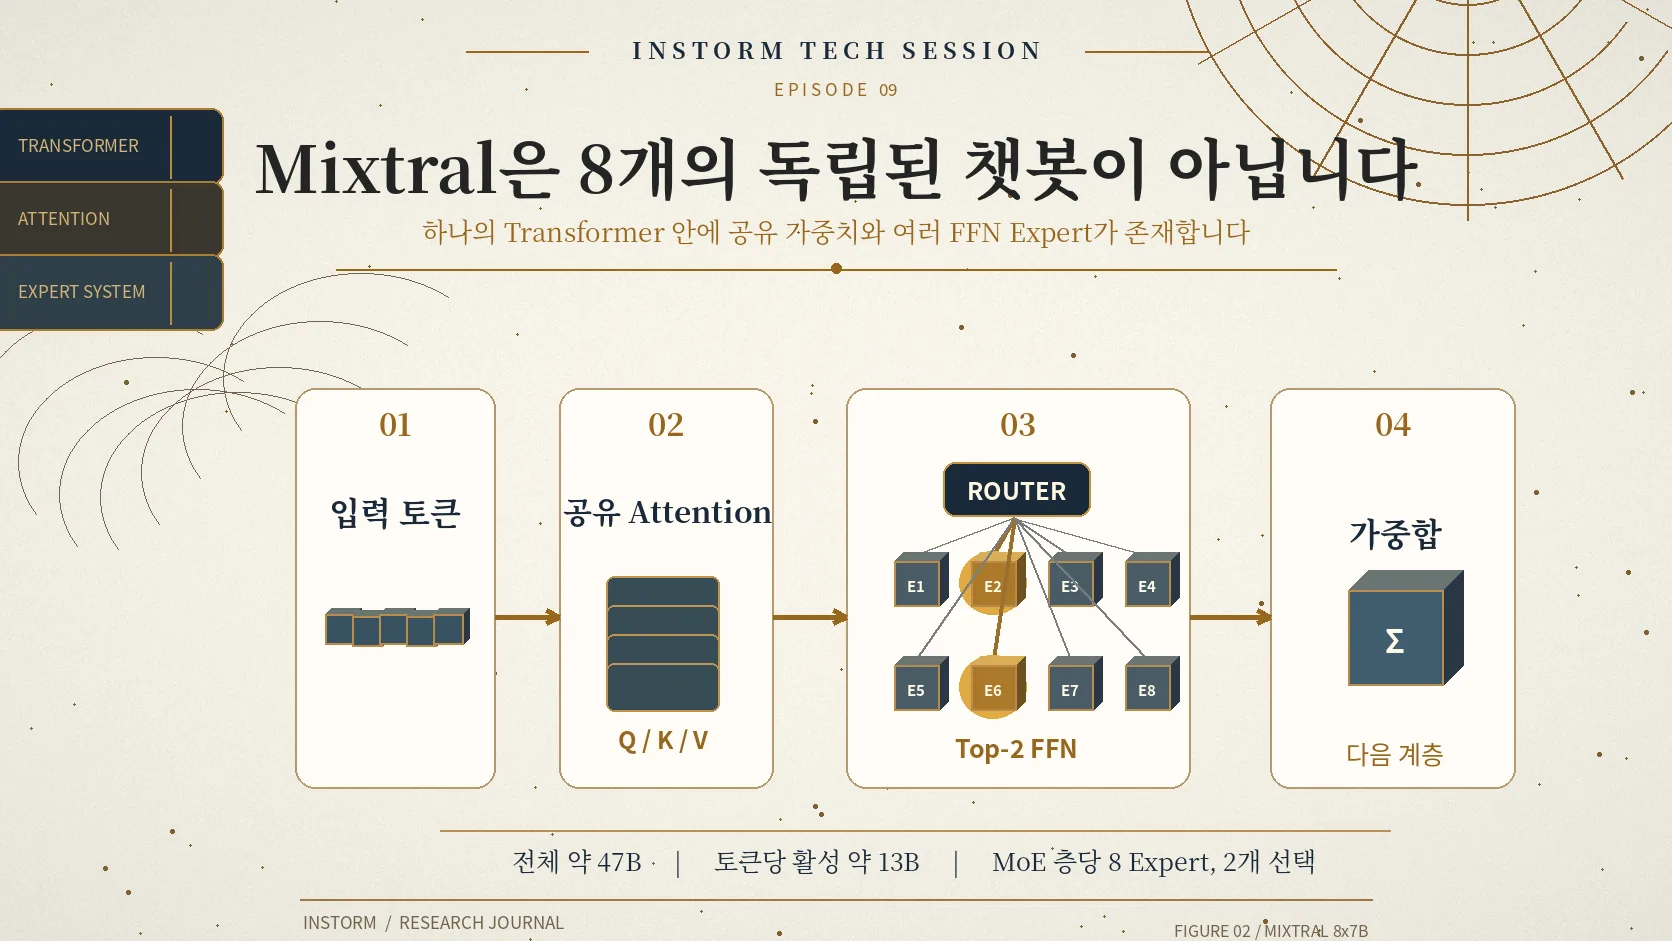
왜 차이가 날까요? Mixtral은 독립된 7B 챗봇 여덟 개를 처음부터 끝까지 실행하는 구조가 아니기 때문입니다. 하나의 Transformer 안에 공유되는 Attention 등 공통 가중치가 있고, FFN 부분에 여러 Expert가 배치됩니다.
각 MoE 층에는 8개의 FFN Expert가 있습니다. 각 토큰에서 2개를 선택합니다. Router는 현재 층으로 들어온 Hidden State(은닉 표현)라는 숫자 벡터를 보고 전문가 점수를 계산합니다. 같은 토큰이라도 층이 달라지면 표현이 달라질 수 있고 선택된 Expert도 달라질 수 있습니다.
| Mixtral 8x7B 구성 | 규모 |
|---|---|
| 전체 파라미터 | 약 47B |
| 토큰당 활성 파라미터 | 약 13B |
| MoE 층의 Expert | 8개 |
| 토큰당 선택하는 Expert | 2개(Top-2) |
숫자는 원논문 초록이 사용하는 근사치입니다. 전체 파라미터는 모델이 보유한 학습 가능한 숫자의 규모이고, 활성 파라미터는 그 토큰의 계산 경로에 실제로 참여하는 가중치의 규모입니다. 나머지 가중치가 삭제되거나 영원히 사용되지 않는 것은 아닙니다.
여덟 전문가 중 두 개를 고르는 계산을 직접 해봅시다
“고양이가 창가에서 잠든다”를 입력했다고 해보겠습니다. 설명을 위해 고양이 / 가 / 창가에서 / 잠든다라는 가상 토큰 네 조각으로 나눕니다. 실제 Mixtral 토크나이저의 결과라는 뜻은 아닙니다.
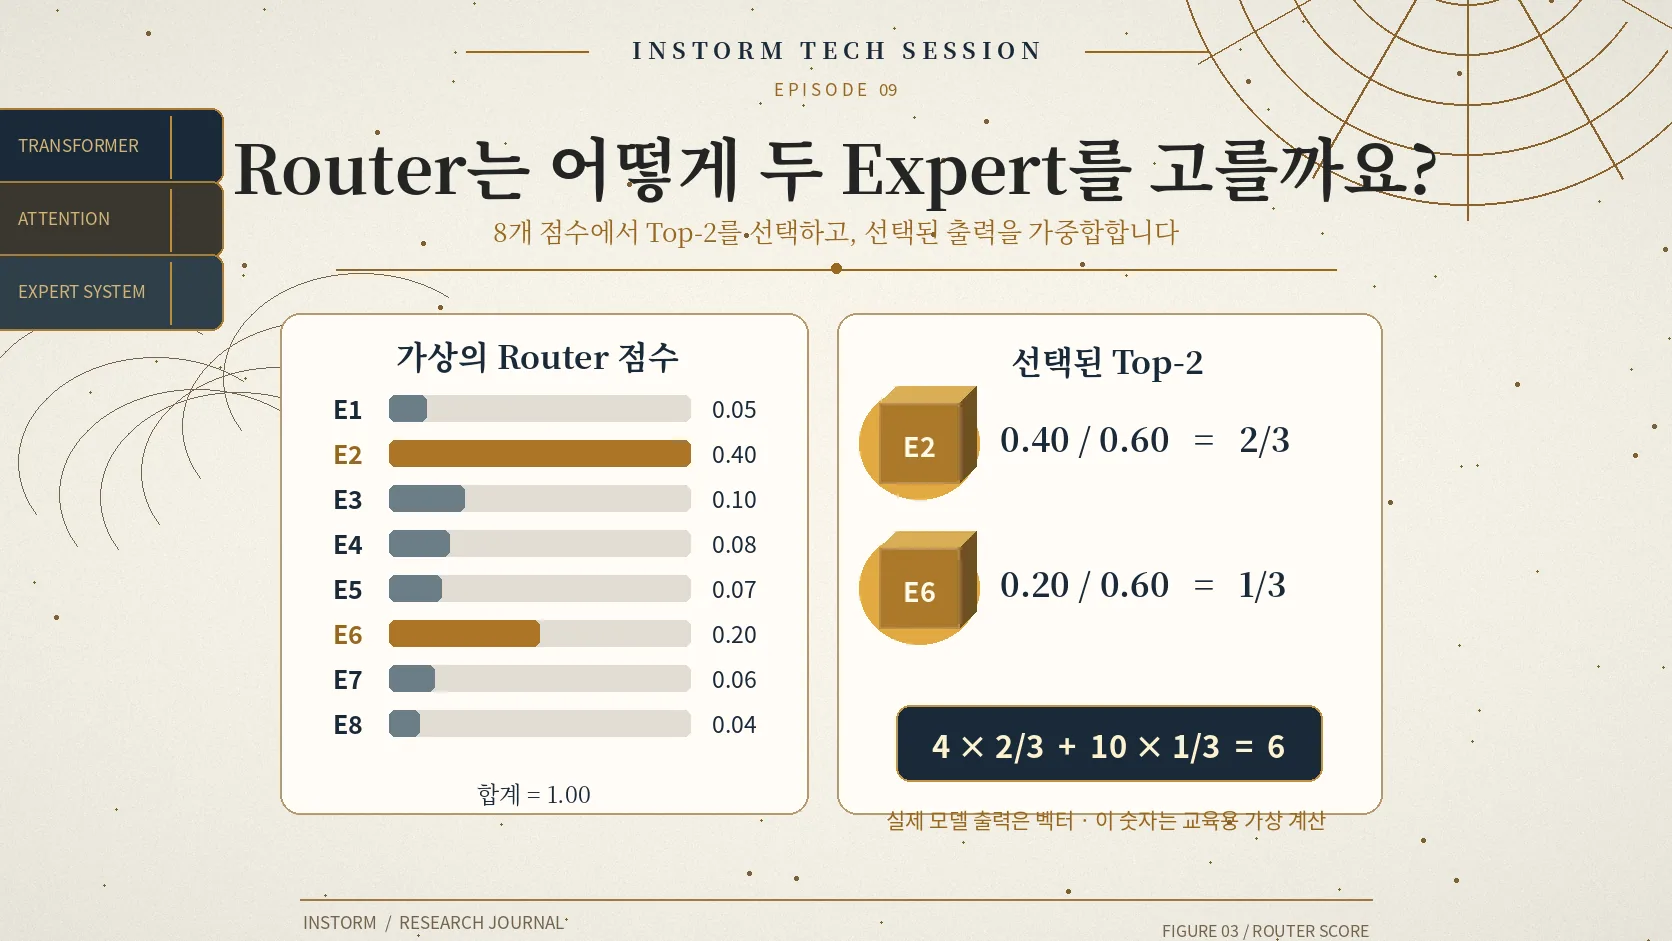
한 토큰의 Hidden State가 MoE 층에 도착하면 Router가 여덟 Expert에 점수를 부여합니다. 다음은 계산 원리만을 위한 가상 정규화 점수입니다.
| Expert | 점수 |
|---|---|
| E1 | 0.05 |
| E2 | 0.40 |
| E3 | 0.10 |
| E4 | 0.08 |
| E5 | 0.07 |
| E6 | 0.20 |
| E7 | 0.06 |
| E8 | 0.04 |
합계는 1.00입니다. 가장 높은 두 값은 E2의 0.40과 E6의 0.20입니다. 두 Expert를 선택한 뒤 그 점수를 다시 합계 1이 되도록 정규화하면 E2는 0.40/0.60=2/3, E6는 0.20/0.60=1/3이 됩니다.
이제 Expert 출력이 단일 숫자라고 단순화해 E2가 4, E6가 10을 반환한다고 해보겠습니다.
4 × (2/3) + 10 × (1/3) = 6
최종 값은 6입니다. 실제 FFN 출력은 하나의 숫자가 아니라 벡터입니다. 원논문의 Mixtral 구현은 Top-2 로짓을 선택하고 선택된 두 값에 Softmax를 적용해 가중치를 계산합니다. 표의 값은 그 원리를 설명하는 개념 예시이지 실제 Mixtral 로그가 아닙니다.
다른 토큰은 다른 두 Expert를 고를 수 있습니다. 그리고 다음 층에서는 다시 라우팅됩니다. 이처럼 토큰마다 일부 계산 경로만 활성화하는 방식을 Sparse Activation(희소 활성화)이라고 합니다.
계산이 줄었는데 왜 GPU 메모리도 똑같이 줄지 않을까요?
Mixtral의 토큰당 활성 파라미터는 전체 파라미터보다 작습니다. 그렇다면 GPU 메모리도 13B 모델만큼만 필요할까요? 반드시 그렇지 않습니다.
선택되지 않은 Expert의 가중치도 필요할 때 호출하기 위해 어딘가에 저장되어야 합니다. 모든 가중치를 GPU에 올리면 당장 계산하지 않는 Expert도 VRAM을 사용합니다. CPU 메모리나 다른 장치에 나눠 놓고 필요할 때 가져오는 방법은 가능하지만, 그 경우 데이터 이동 비용이 생깁니다.
여러 GPU에 Expert를 배치하면 토큰 표현을 해당 GPU에 보내고 결과를 받아야 할 수 있습니다. 이를 All-to-all Communication(전체 간 데이터 교환)이라고 합니다. 계산량이 줄어도 GPU 간 통신이 병목이면 전체 응답 속도는 기대만큼 빨라지지 않습니다.
따라서 Activated Parameters(활성 파라미터 수), 전체 VRAM, 실제 처리량과 지연시간은 서로 다른 지표입니다. 큰 MoE 모델을 평가할 때에는 Batch Size(배치 크기), 통신과 메모리 대역폭까지 함께 확인해야 합니다.
한 전문가에게만 일이 몰리면 어떻게 될까요?
여덟 Expert 중 E1과 E2만 계속 선택된다면 다른 Expert들은 거의 일하지 않습니다. 계산이 몇 Expert에 몰리며 학습 기회도 불균형해질 수 있습니다. 이 문제를 Load Imbalance(부하 불균형)라고 합니다. 일부 전문가만 반복 사용되는 Expert Collapse(전문가 붕괴) 같은 현상과도 연결됩니다.
이를 방지하기 위해 Load Balancing Loss(부하 균형 손실)를 추가하거나 Expert별 Capacity(처리 용량)를 조절하는 방법 등이 연구되어 왔습니다.
그런데 이상한 질문이 하나 생깁니다. Expert들이 똑같은 횟수로 호출되는 것이 언제나 좋을까요? 어떤 입력을 E2가 잘 처리하도록 학습하고 있는데, 사용 횟수를 맞추기 위해 유사한 입력을 다른 Expert에 흩뿌린다면 오히려 전문화가 어려워질 수도 있습니다.
2026년 연구는 바로 이 지점을 들여다봤습니다.
2026년, 공평한 분배가 전문화를 방해할 수 있다는 연구
2026년 ACL Findings의 Peixuan Hou와 동료들은 From Pseudo-Balancing to True Specialization: Memory-Aware Routing for Mixture-of-Experts를 발표했습니다.
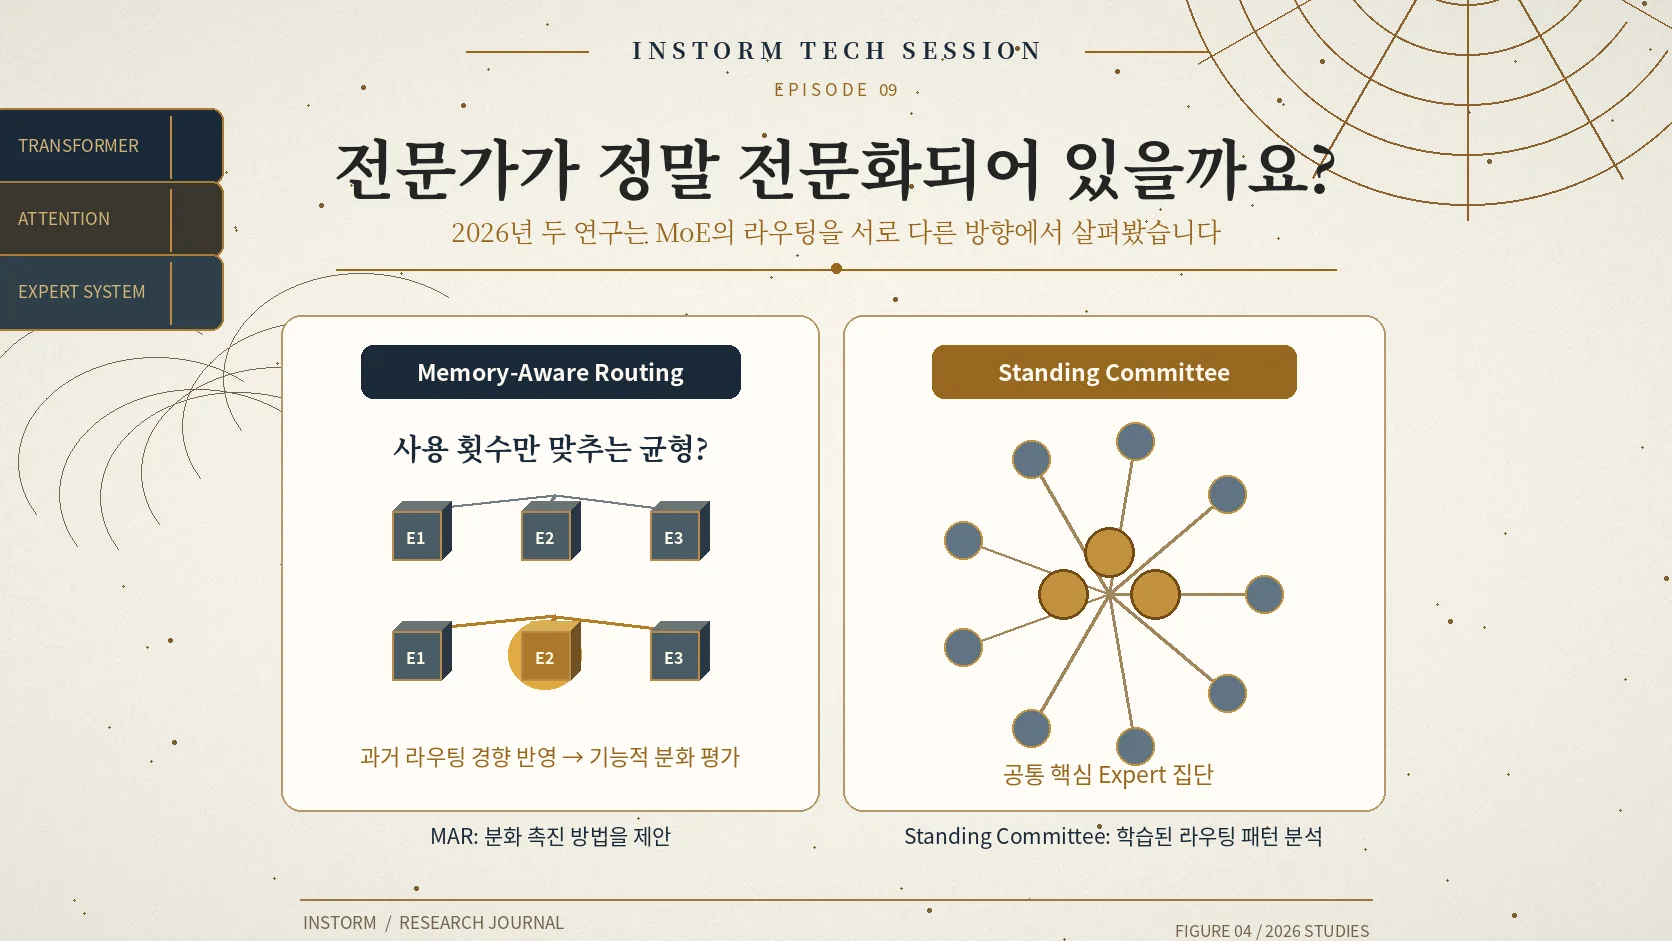
연구진은 사용 횟수가 고르게 분산되어도 유사한 입력이 매번 다른 Expert로 보내지면 기능 차이가 명확히 형성되지 않을 수 있다고 지적했습니다. 이를 Pseudo-Balancing(겉보기 부하 균형)이라고 불렀습니다.
연구진이 제안한 MAR(Memory-Aware Routing)은 Expert의 과거 라우팅 경향을 반영하는 Memory Buffer를 활용합니다. 이 '메모리'는 사용자의 대화 기록이 아니라 학습 중 Expert와 입력 사이의 연결 경향입니다.
논문은 전문가의 기능적 차이를 측정하는 KED(Key Expert Dependency) 지표에서 평균 약 35% 개선을 보고했습니다. KED는 특정 Expert를 비활성화했을 때 Perplexity(퍼플렉서티)가 얼마나 달라지는지 등을 통해 전문가 간 의존성의 차이를 살펴봅니다. 35%는 답변 정확도나 일반 지능의 개선률이 아닙니다.
논문 Table 4의 OLMoE 1B–7B 실험 중 일부는 다음과 같습니다.
| 평가 | 기준 방식 | MAR |
|---|---|---|
| MMLU 정확도 | 43.06% | 44.08% |
| SVAMP 정확도 | 10.60% | 13.30% |
SVAMP는 2.70%포인트 상승, 기준 성능 대비 상대 개선률은 약 25.5%입니다. 하지만 절대 정확도는 13.30%에 불과합니다. 이 수치를 “모든 수학 문제를 25% 더 잘 푼다”라고 일반화하면 안 됩니다. 논문은 일부 실험에서 전문가 수를 절반으로 줄이면서 기준 성능을 유지하기도 했지만, 이것을 47B Mixtral 모델의 Expert를 마음대로 절반 삭제해도 된다는 의미로 해석해서도 안 됩니다.
MAR는 버퍼 크기와 혼합 계수 등 추가 설정이 필요하며, 분포가 달라질 때 오래된 라우팅 정보가 적응을 방해할 가능성도 있습니다.
전문가들은 정말 수학·역사·코딩을 나눠 맡을까요?
MoE를 설명하는 가장 쉬운 그림은 '수학 전문가', '역사 전문가', '코딩 전문가'를 따로 두는 것입니다. 하지만 실제 모델에서 Expert의 기능이 인간의 직업처럼 명확히 구분된다는 근거가 있을까요?
2026년 ACL의 Yan Wang와 동료들은 The Illusion of Specialization: Unveiling the Domain-Invariant “Standing Committee” in Mixture-of-Experts Models를 발표했습니다.
연구진은 COMMITTEEAUDIT로 단일 Expert가 아니라 여러 Expert가 함께 선택되는 패턴을 분석했습니다. 세 종류의 대표적인 MoE 모델과 MMLU 평가에서 분야가 달라도 반복적으로 선택되는 공통 핵심 Expert 집단이 관찰됐습니다. 이를 Standing Committee(상설 위원회)라고 불렀습니다.
일부 주변부 Expert는 분야에 따라 선택 패턴이 달랐지만, 중심 집단은 여러 분야에서 공통으로 사용됐습니다. 물론 이것이 모든 MoE의 Expert가 전문화되지 않는다는 증명은 아닙니다. 특정 모델과 평가 조건에서 관찰된 라우팅 패턴입니다.
MAR는 “어떻게 Expert가 안정적이고 구별되는 기능을 배우게 할까”를 연구합니다. Standing Committee 논문은 “이미 학습된 모델에서 실제 Expert들이 어떤 집단 구조로 선택되는가”를 분석합니다. 질문이 다른 두 연구를 함께 읽으면 하나의 교훈이 남습니다.
Expert라는 이름만으로 전문화된 역할이 보장되지는 않습니다. 실제 계산 경로, 기능과 검증이 중요합니다.
처음의 47B와 13B로 돌아가 보겠습니다. MoE는 전체 파라미터 용량을 크게 유지하되, 토큰마다 일부 FFN 전문가를 선택해 계산하는 구조입니다. 계산을 효율화할 가능성을 만들지만 가중치의 저장 비용, 라우팅, 통신과 전문화 문제까지 없애지는 못합니다.
MoE가 해결하려는 것은 모델 용량과 토큰당 계산 비용의 관계입니다. 답변이 참인지 거짓인지까지 자동으로 보장하지는 않습니다.
그렇다면 AI는 왜 모르는 질문을 받아도 그럴듯하고 자신 있는 대답을 만들어낼까요? 10편에서는 Hallucination(환각), Calibration(확신도 보정), 그리고 학습·평가 구조가 답변에 미치는 영향을 살펴보겠습니다.
참고 자료
- Jacobs et al. (1991), Adaptive Mixtures of Local Experts — 초기 전문가 혼합과 게이팅 모델.
- Shazeer et al. (2017), Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer — 대규모 희소 MoE.
- Fedus et al. (2022), Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity — Top-1 Expert 라우팅.
- Jiang et al. (2024), Mixtral of Experts — Mixtral 8x7B, Top-2 및 47B/13B.
- Hou et al. (2026), From Pseudo-Balancing to True Specialization: Memory-Aware Routing for Mixture-of-Experts — MAR와 KED 및 실험 한계.
- Wang et al. (2026), The Illusion of Specialization: Unveiling the Domain-Invariant “Standing Committee” in Mixture-of-Experts Models — COMMITTEEAUDIT와 공통 Expert 집단.